GLM Coding Plan 2026价格与限额全解析:套餐怎么选

GLM Coding Plan 以积分制提供三档订阅,重度美洲用户最划算,轻量用户按量付费更省。
GLM Coding Plan 是 Z.ai 面向编程智能体的月度订阅,2026 年 7 月起已从提示词计数切换为按 token 计量的积分系统。Lite、Pro、Max 三档月付分别为 $18、$80、$168,年付享 7 折,积分计算公式公开:输入、缓存输入、输出各有倍率,MCP 调用固定计费。非高峰时段按 5 折计费,美洲开发者几乎全程享受折扣,实际额度近乎翻倍。套餐积分花在 GLM-5.3 上最划算,用于 Flash 折扣偏薄。与 Z.ai 自家 API 相比可省 4 至 12 倍,但对比 Novita 等第三方开源托管商优势缩水到约 1.6 倍。配额仅限官方支持工具内使用,禁止共享或接入自建应用。
GLM Coding Plan 2026价格与限额全解析:套餐怎么选
Z.ai 的 GLM Coding Plan 已成为不少开发者日常运行编程智能体的默认选择——最低 $18/月,按官方测算,其每周额度足以覆盖 4800 万至 9700 万 tokens 的旗舰模型 GLM-5.3。若按 Z.ai 自己的按量付费价格购买同等用量,这一数字约为每月 70 至 140 美元。
但问题在于,很多评测描述的套餐早已不存在。仅 2026 年内,该套餐就从「按提示词计数、无周上限」,变为「按提示词计数、带 5 小时与每周上限」,再到 7 月 30 日全面切换为按 token 计量的积分系统。价格也已上移:Pro 档从 4 月的 $72/月涨至如今的 $80。
本文拆解定价页没有讲清楚的机制:积分究竟怎么扣、各档额度折合多少美元、与按量付费和第三方托管相比的盈亏平衡点在哪里。
一、GLM Coding Plan 是什么
GLM Coding Plan 是 Z.ai(智谱 AI 国际品牌)推出的月度订阅,用于在 AI 编程工具中以固定额度调用 GLM 模型,而非按 token 计费。你创建 API Key,将 Claude Code、Cline 等受支持的智能体指向 Z.ai 的编程端点,每次调用消耗固定额度而非绑定信用卡余额。
三个档位包含相同的模型——旗舰 GLM-5.3 与更快的 GLM-5.3-Flash——外加图像理解、网页搜索、网页读取和仓库读取四个 MCP 工具。档位之间只在使用量上存在差异,且一个额度在所有接入的工具间共享。
该套餐不是 API 套餐:Z.ai 订阅条款明确禁止用户「从自己的应用、机器人、网站、SaaS 产品或其它系统」调用模型。额度不能与同事共享,耗尽后不会回退到账户余额,且不可退款。
为什么会有固定费率套餐
编程智能体对模型供应商而言是特殊客户。智能体循环的每一步都会重发此前的对话(系统提示、工具定义、已读取的文件),单个任务可能推送数百万 tokens,而其中绝大部分与前一次调用完全相同。Z.ai 对 GLM-5.3 的新鲜输入收 $1.40/百万 tokens,缓存输入仅 $0.26/百万——按量计费下,重度用户的账单庞大、以重读为主且难以预测。
因此该套餐适合三类人:日常高频使用智能体的开发者;希望在 Claude Code 内用更便宜模型处理常规任务的用户;工作日几乎全部落在 Z.ai 折扣时段的美洲开发者。轻量用户和希望接入自建应用的人则不适合。
提示词缓存(Prompt Caching) 是理解本套餐经济模型的关键。它的原理是:当多次请求的前缀部分(系统提示、工具定义、已读文件等)完全一致时,模型供应商可以复用上一次推理时已计算的键值缓存(KV Cache),无需重新对这部分输入做前向计算。因此缓存命中的输入 token 能享受极低费率——本文中 GLM-5.3 的新鲜输入是 $1.40/百万 tokens,而缓存输入仅 $0.26/百万,相差约 5.4 倍。
编程智能体天然是缓存密集场景:每一步循环都会重发整个对话历史,单次调用可能有 12 万 tokens 上下文,其中 95% 以上是重复前缀。没有缓存,按 token 计费的账单会迅速失控;有了缓存,同样的任务成本可以下降数倍。这也是文章反复强调「上下文越短越省钱」的根本原因——上下文膨胀不仅增加输入 tokens,还降低了缓存命中率。
二、2026 价格与档位
Z.ai 出售 Lite、Pro、Max 三个个人档位,均可按月、季、年付费。月付分别为 $18、$80、$168;季付享 8 折,年付享 7 折,年付折算月价为 $12.60、$56、$117.60。
| 档位 | 月付 | 年付(折合月) | 5 小时积分 | 每周积分 |
|---|---|---|---|---|
| Lite | $18 | $12.60 | 2,000 | 10,000 |
| Pro | $80 | $56 | 12,000 | 60,000 |
| Max | $168 | $117.60 | 28,000 | 140,000 |
每千每周积分的单价随档位递减:Lite $1.80、Pro $1.33、Max $1.20。Pro 的每积分成本比 Lite 便宜约 26%,Max 便宜约三分之一。不过这并不意味着 Max 是理性默认选项——未使用的积分价值为零。它意味着一旦你确定要用掉 Lite 数倍的额度,更大档位是更划算的买法:6 个 Lite 订阅每月 $108,才能买到这里 Pro 以 $80 提供的周积分。
折扣、推荐与团队定价
新订阅者通过邀请链接注册可获首单 9 折,邀请人获得新订阅者付费金额 10% 的积分,满 3 位付费受邀者后释放。团队购买按座位计费:标准座 $88/座/月,高级座 $188/座/月,最少两个座位,年付再省 10%。
值得留意的是价格历史。2026 年 4 月,Z.ai 迁移通知中的月价还是 $18、$72、$160。Lite 保持原价,Pro 和 Max 在积分系统上线时分别上涨约 11% 和 5%,且用量计量方式彻底改变。任何写于 7 月 30 日之前的评测,描述的都不是同一个产品,即便档位名称相同。
三、积分如何运作
积分直接与 token 挂钩,公式已公开:积分 =(输入 tokens × 输入倍数 + 缓存输入 × 缓存倍数 + 输出 × 输出倍数)/ 10,000。MCP 工具调用按每次固定积分单独计费。
| 用量 | 输入倍数 | 缓存输入倍数 | 输出倍数 |
|---|---|---|---|
| GLM-5.3 | 6.9 | 1.7 | 24 |
| GLM-5.3-Flash | 2.3 | 0.56 | 8 |
| 搜索/读取/Zread MCP | — | — | 每次 1.2 |
两个直接后果:缓存命中是该套餐的命脉——编程智能体每步重发约 12 万 tokens 上下文时,绝大部分按 1.7 的费率结算,这才使广告中的 token 额度成为可能。推理很贵——GLM-5.3 的思考 tokens 属于输出 tokens,按 24 计费,而模型默认使用最高推理强度。
高峰时段与 5 折优惠
高峰时段之外,模型用量按标准费率的 50% 计费。高峰时段为周一至周五新加坡时间 14:00 至 18:00(UTC+8),即每周 168 小时中的 20 小时。
| 地区 | 工作日高峰窗口 |
|---|---|
| 新加坡、北京 | 14:00–18:00 |
| 印度 | 11:30–15:30 |
| 柏林、巴黎 | 08:00–12:00 |
| 伦敦 | 07:00–11:00 |
| 纽约 | 02:00–06:00 |
| 旧金山 | 前一日 23:00–03:00 |
模式很明显:美洲开发者几乎从不触碰高峰窗口,实际额度近乎翻倍;欧洲开发者上午大部分时间付全价;印度开发者中午付全价。
两个窗口
5 小时窗口滚动刷新,每笔用量在消耗 5 小时后释放;每周窗口从订阅时刻起每 7 天重置。任一窗口耗尽,工具调用即失败,套餐绝不回退到账户余额。每个档位的周额度恰好是 5 小时额度的 5 倍。
四、额度究竟值多少美元
Z.ai 自己的换算:在 95% 缓存命中率下,Lite 每周覆盖 4800 万至 9700 万 GLM-5.3 tokens,Pro 为 2.9 亿至 5.8 亿,Max 为 6.76 亿至 13.52 亿。低端假设全部落在高峰,高端假设全部非高峰。
| 档位 | 套餐价格 | API 价值(全高峰) | API 价值(全非高峰) |
|---|---|---|---|
| Lite | $18 | $71 | $141 |
| Pro | $80 | $424 | $848 |
| Max | $168 | $989 | $1,978 |
按 Z.ai 自己的价格读,套餐对重度用户是很强的交易:充分使用时,Lite 提供约 4 至 8 倍月费的用量,Pro 为 5 至 11 倍,Max 为 6 至 12 倍。但更实用的数字是盈亏平衡点——Lite 需月购约 5300 万 tokens 才划算,约为其高峰额度四分之一;Pro 约五分之一,Max 约六分之一。低于该线,按量付费更便宜。
Flash 的不对称性
GLM-5.3-Flash 换来完全不同的图景。套餐按 GLM-5.3 约三分之一的积分收费,但 Z.ai 的 API 将 Flash 定价为 GLM-5.3 的约九分之一,因此套餐对 Flash 的折扣薄得多。实用规则很简单:把套餐积分花在 GLM-5.3 上。
对比最便宜的托管商
「最高省 92%」的说法是与 Z.ai 自己的 API 比较,而后者并非精打细算开发者的首选采购地。GLM-5.3 权重开源,OpenRouter 上有 32 家供应商。在同样的缓存密集型负载下,Z.ai 自己的端点排在 32 家中的第 31 位。
| 托管商 | 输入/缓存/输出(每百万) | 每百万 token 成本 |
|---|---|---|
| Z.ai | $1.40 / $0.26 / $4.40 | $0.34 |
| DeepInfra | $0.56 / $0.13 / $2.50 | $0.16 |
| Novita | $0.42 / $0.08 / $1.32 | $0.10 |
| InferenceNet | $0.12 / $0.04 / $4.40 | $0.07 |
对比最好的托管商,套餐优势从「5 至 11 倍」缩水到接近盈亏平衡——Pro 在 Novita 价格下仍胜出,但倍数约为 1.6 而非 5。
开放权重模型与托管商生态是评估本套餐性价比时容易被忽视的一环。GLM-5.3 的权重是公开的(开源),任何厂商都可以在自有 GPU 上部署并以自定价格提供服务。OpenRouter 这类聚合平台把 32 家供应商的同一模型放在一起比价,价格差异可以非常大——本文表格中 InferenceNet 的输入价仅为 Z.ai 官方端点的约 1/12。
这带来两个后果:其一,Z.ai 宣传的「最高省 92%」是与自家 API 比,而自家 API 恰恰不是最便宜的采购渠道;其二,订阅套餐的「固定费率」本质上是把价格波动和供应商选择权让渡给 Z.ai,换取额度可预测。如果你的工作负载稳定且缓存命中率高,直接选择 Novita、DeepInfra 等第三方托管商,往往比订阅更灵活——本文测算显示套餐相对最优托管商的优势会从 5 倍以上缩水到约 1.6 倍。
五、你实际获得的模型
所有档位只包含两个模型:GLM-5.3 与 GLM-5.3-Flash。路由规则决定你实际拿到什么——请求 GLM-5.2 或 GLM-5.1 会被自动路由到 GLM-5.3,请求 GLM-4.7 会路由到 GLM-5.3-Flash。
GLM-5.3 使用与 GLM-5.2 相同的基础模型,所有提升来自后训练,拥有 100 万 token 上下文、三档推理控制和开放权重。在 Terminal Bench 3.0 上达 28.3(GLM-5.2 为 4.6),DeepSWE 上达 66.9(前代 46.2)。
GLM-5.3-Flash 则是 3200 亿参数、180 亿激活的原生多模态模型,MIT 许可,在套餐中充当廉价主力。
套餐还包含四个 MCP 工具:图像理解、网页搜索、网页读取和 Zread(GitHub 仓库检索),后三者每次调用 1.2 积分。
六、配置与使用建议
配置的核心要求是:配额只在请求通过受支持工具到达 Z.ai 编程端点时生效。三种协议各有其 base URL——Claude Code 用 Anthropic 格式(https://api.z.ai/api/anthropic),多数编辑器用 OpenAI Chat Completions(https://api.z.ai/api/coding/paas/v4),Codex 用 Responses 格式(https://api.z.ai/api/v1)。
节省积分的三个习惯
让额度更耐用,有三个零成本的习惯:不让上下文无限增长、常规工作降低推理强度、把重活移出高峰时段。
保持上下文简短:12 万 tokens 上下文的单次调用在高峰消耗 28.3 积分,40 万 tokens 则要 83 积分。Claude Code 中用 /clear 开启新对话、/compact 压缩历史、/context 查看窗口占用。
调低推理档位:GLM-5.3 默认最高推理强度,每个思考 token 按 24 倍输出计费。Claude Code 中用 /effort 切换档位,难题用 max,机械性工作降到 high 或 low。
善用 Flash 与错峰:小任务交给 Flash(积分仅三分之一),大型重构安排在非高峰时段,成本直接减半。
七、可能让你损失订阅的规则
套餐条款比多数开发者订阅更严格,且以自动化「风控」执行。核心限制是配额只能用于官方支持的工具,绝不用于「通用 API 访问」;条款明确将「基于 SDK 的访问」列为系统可检测的模式。
第二项限制关乎使用者。订阅「仅授权给与账户关联的自然人」,以任何方式与同事、朋友、客户或组织共享均被禁止。最可能绊倒诚实用户的行为都很平常:运行未列出的工具、把 Key 接入脚本或内部机器人、把 Key 借给同事一天。
订阅一经购买不可退款,自动续费按续费当日页面所示价格扣款——这意味着涨价会在下次续费时触及现有订阅者。
八、还是买吗?
GLM Coding Plan 是一个好产品,但甜蜜区很窄。三个变量决定你是否在线的这一侧:智能体每周实际运行多少小时、上下文膨胀到多大、这些时间是否落在 Z.ai 的高峰窗口。价格的重要性低于这三者——如果最便宜的档位每天下午就耗尽,它反而是昂贵选择。
| 你的情况 | 建议购买 |
|---|---|
| 每周几次任务 | 按量付费,优选便宜托管商 |
| 每日使用,身处美洲 | 从 Lite 起步,触墙后升 Pro |
| 每日使用,身处欧洲或印度 | Pro,并将重活移出高峰 |
| 全天候多项目工作 | Max |
| 公司团队 | 团队座位并开启超额 |
无论选哪档,首个周期先用月付并测量。控制台会显示积分消耗,一周标准费率下的真实工作(非促销期)比任何估算都更能说明你是 Lite、Pro 还是 Max 用户。
背景补充
推理强度(Reasoning Effort / Thinking Budget) 指模型在给出最终回答前进行内部「思考」的 token 预算,通常分为 low、high、max 等档位。GLM-5.3 是推理模型,其思考过程产生的 tokens 被计入输出侧,而输出在积分公式中倍率高达 24(输入仅 6.9)。这意味着提高一档推理强度,消耗的积分可能成倍增长,即便最终答案长度不变。
实用含义是:推理强度应随任务难度动态调整。架构设计、复杂 bug 定位等难题值得用 max,让模型充分展开思考链;而格式化、简单改写、样板代码生成等机械性工作应降到 high 或 low,既能省积分,也能减少响应延迟。Claude Code 中通过 /effort 命令切换,其它工具多在配置项中设置。
端点(Endpoint) 在这里不是技术细节,而是订阅合规的判定边界。Z.ai 的编程套餐只在流量经过特定受支持工具、命中专用编程端点时计算配额;若用同一个 API Key 直接请求通用 API 端点,系统会识别为「基于 SDK 的访问」并可能触发风控。换言之,Key 本身没有变,但走的协议路径决定了这次调用是合规的套餐用量,还是违规的通用 API 调用。
常见的误触情形包括:把 Claude Code 的 Key 复制到自己的 Python 脚本里、接入内部 Slack 机器人、或在 Cline 之外的第三方插件中配置同一 Key。这些行为在技术上可行,但会绕过套餐的计量与授权模型,属于条款明令禁止的范畴。使用前应确认工具是否在 Z.ai 官方支持列表中。
相关推荐

iPhone Duo上手体验:2000美元的小屏折叠,值不值?
YouTube博主Allison分享iPhone Duo上手体验:双屏多任务效率翻倍,视频观看体验出色,磨砂质感好评,但机身偏厚、单屏操作偏小,2000美元定价进入MacBook区间,属于奢侈品定位。

Sentry广告笑疯开发者:On-call也能变有趣?
Sentry广告短片以开发者On-call焦虑为切入点,用幽默对话展示其将错误、日志、链路、指标、录屏和发布记录集中一处的可观测性能力,引发开发者社区共鸣。
LLM应用越改越糟?三步构建有效评估体系
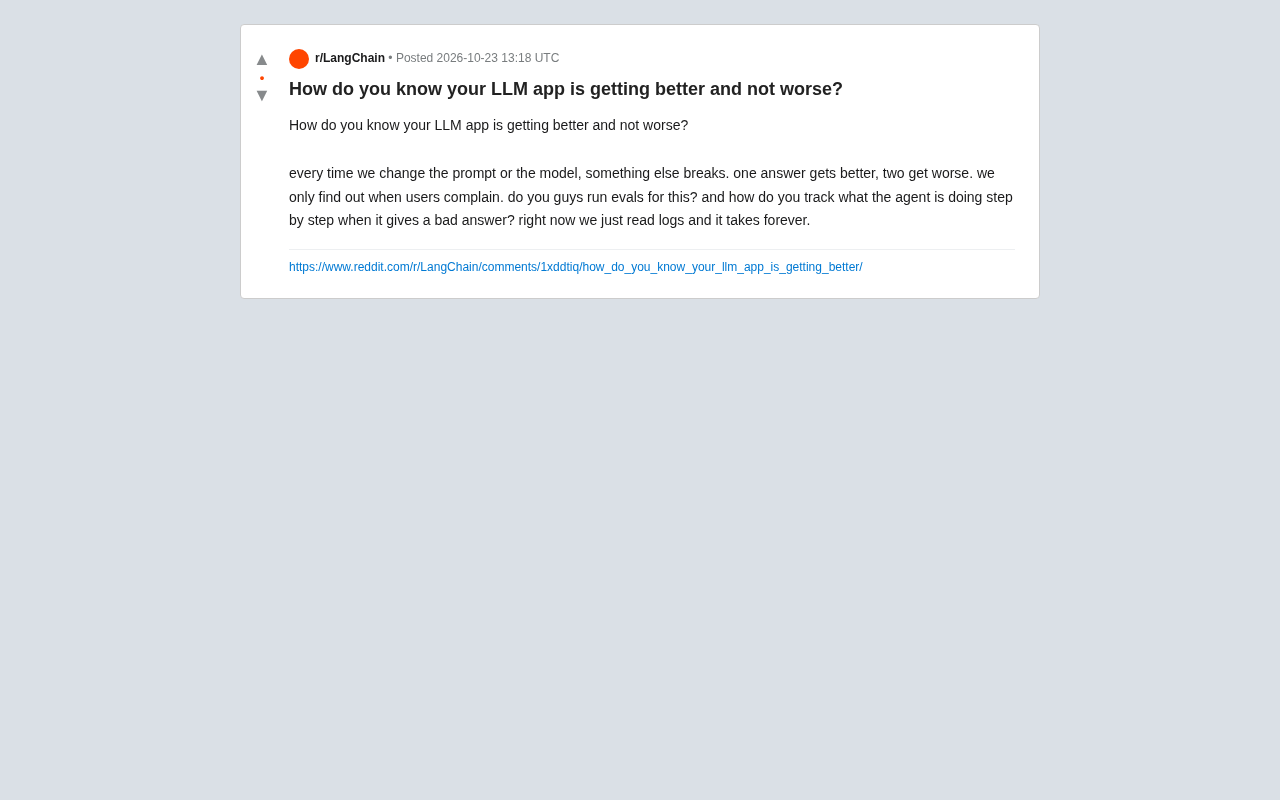
LLM应用迭代时如何判断变好还是变坏?本文基于Reddit开发者讨论,详解构建测试集、自动化回归评估、LLM-as-judge评分与结构化追踪智能体行为,建立从生产反馈到评估追踪的持续闭环。