共轭矩量测度:用单一凸势函数统一采样与映射的生成模型新范式

共轭矩量测度用单一凸势函数统一生成模型的采样与传输,解决了经典分解中先验分布与目标严重失配的问题。
研究者 Nina 提出"共轭矩量测度"框架,以同一凸势函数 W 同时刻画采样分布与传输映射,为生成建模提供了区别于扩散模型的新路径。经典矩量测度分解虽理论优雅,但其对应先验分布与目标分布可能严重失配——高斯情形下先验协方差为目标的逆,导致传输映射 Lipschitz 常数爆炸。共轭分解的关键改动是将传输映射替换为势函数高斯变换后的梯度,使高斯情形下先验协方差变为 Σ^(1/3),显著改善对齐。存在性由 Schauder 不动点定理保证,估计算法直接源自不动点迭代结构,高维实现依赖输入凸神经网络与摊销技巧。卡通头像实验揭示出对数凹噪声携带丰富语义信息这一有趣现象,体现了采样与传输天然统一的独特优势。
生成模型的核心挑战之一,是如何将"从噪声中采样"与"把噪声映射到数据"这两个过程有机联系起来。研究者 Nina 在一场学术研讨会上介绍了一项名为**共轭矩量测度(Conjugate Moment Measures)**的新工作,提出用同一个凸势函数 W 同时刻画采样分布与传输映射,为生成建模提供了一条与主流扩散模型截然不同的路径。
从矩量测度分解说起
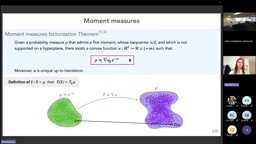
这项工作的理论起点,是 Cordero-Erausquin 和 Klartag 在 2015 年证明的一条定理。该定理指出:对于任意具有一阶矩、重心为零且不支撑于超平面上的概率测度 ρ,都可以被分解为一种特殊形式——其中 u 是一个凸函数,exp(-u) 对应所谓的 Gibbs 分布(或对数凹分布),而分解中的传输映射恰好是 u 的梯度。
这个分解的意义在于:只要知道凸函数 u,就能先从与 u 关联的对数凹分布中采样,再用 ∇u 把样本传输过去,从而得到 ρ 的样本。采样过程和传输过程都由同一个凸势 u 决定。一年之后,Santambrogio 用一个关于概率分布的变分问题证明了相同的结论,其泛函第一项是熵,第二项来自最优传输的对偶问题,通过证明泛函存在极小值并推导最优性条件,恰好还原出矩量测度分解。
与最优传输的深层联系
矩量测度与最优传输之间存在紧密纽带。回到最优传输的核心——Monge 问题:给定两个分布 μ 和 ν,寻找一个传输映射 T,在最小化传输代价的前提下把 μ 送到 ν。Brenier 定理告诉我们,凸函数的梯度总是最优传输映射。因此在矩量测度分解中,∇u 正是 Gibbs 分布与 ρ 之间 Monge 问题的解。有意思的是,从最优传输的视角看,u 出现了两次:一次在起始分布中,一次在传输映射中。
**最优传输(Optimal Transport,OT)**是研究如何以最低代价将一个概率分布"搬运"到另一个分布的数学理论,其历史可追溯至 Monge 在 1781 年提出的土方搬运问题。现代形式由 Kantorovich 在 20 世纪中叶重新表述为线性规划。Brenier 定理(1991 年)是该理论的里程碑结论:当源分布绝对连续时,将源分布传输到目标分布的唯一最优映射(在平方欧氏代价下)必然是某个凸函数的梯度,该凸函数被称为 Brenier 势。这一结论将最优传输问题化约为求解一个凸函数,为数值计算和理论分析都提供了极大便利。在生成模型领域,OT 提供了一种将随机噪声"对齐"到数据分布的自然框架——无需逐步去噪,而是直接构造一个全局最优的映射,这也是本文工作区别于扩散模型的核心出发点之一。
为什么矩量测度不适合生成建模
尽管矩量测度是一个优雅的答案,但作者论证它并不适合生成建模。通过引入 KL 散度重写 Cordero 等人研究的泛函,可以看出:矩量测度分解中的 u,是使得与其 Legendre 变换(凸共轭)u* 关联的 Gibbs 分布最接近 ρ 的那个 u。
问题恰恰出在这里——接近 ρ 的是与 u* 关联的分布,而作为先验的、与 u 关联的 Gibbs 分布并不保证接近 ρ,在高斯情形下甚至可能相距极远。当 ρ 是协方差矩阵为 Σ 的高斯分布时,其对应先验竟然是协方差 Σ⁻¹ 的高斯分布。这意味着:如果 ρ 很分散(长尾),先验就会高度集中于零点;反之亦然。当先验极度集中、目标极度分散时,传输映射的 Lipschitz 常数会爆炸,给数值优化带来灾难。对于任意分布的边缘情形,同样的病态也会出现。
*Legendre 变换(凸共轭)是凸分析中的基本工具:给定凸函数 f,其凸共轭定义为 f(y) = sup_x {⟨x, y⟩ - f(x)}。凸共轭将一个函数"翻转"到对偶空间,且对凸函数有 f = f(双重共轭还原自身)。在最优传输语境中,Kantorovich 对偶定理将原始的联合分布优化问题转化为关于一对"对偶势"(f, g) 的优化,且二者互为凸共轭。KL 散度(Kullback-Leibler 散度)则是衡量两个概率分布"差距"的标准工具,定义为 KL(p‖q) = ∫ p log(p/q),值为零当且仅当两分布相等。文中通过将原始变分泛函改写为含 KL 散度的形式,清晰地揭示出矩量测度的先验分布究竟在优化什么目标——这是理解"为何先验与目标分布相距极远"这一核心缺陷的关键一步。
共轭矩量测度:一处关键改动
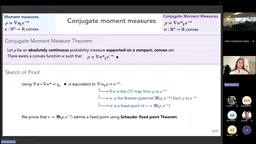
新提出的共轭矩量测度分解形式上与原分解非常相似,唯一的差别在于:不再用势函数的梯度做传输,而是用势函数高斯变换后的梯度来传输,这里 W 仍是凸函数。正是这处改动扭转了前述病态。
证明思路也与前人不同。作者没有直接证明该等式,而是借助凸对偶,在等式两边同时作用 ∇W,转而证明一个等价形式。由 Brenier 定理,∇W 是 ρ 与其关联 Gibbs 分布之间的最优传输映射,即 W 是二者的 Brenier 势。进一步,W 是"给定势 V 返回 ρ 与其 Gibbs 分布间 Brenier 势"这一映射的不动点。作者用 Schauder 不动点定理证明该映射存在不动点,从而保证分解方程有解——这也是证明中需要紧性假设(ρ 绝对连续、支撑于紧凸集)的原因。
再看高斯情形:当 ρ 协方差为 Σ 时,共轭分解对应的先验 Gibbs 分布协方差变为 Σ^(1/3),而非原来的 Σ⁻¹。也就是说,ρ 分散时先验也分散,二者更好对齐,Lipschitz 常数不再爆炸。这从直觉上说明新分解更适合生成建模。
Schauder 不动点定理是泛函分析中的经典存在性工具:若 T 是紧凸集上的连续映射,则 T 必有不动点 x* 满足 T(x*) = x*。它是有限维 Brouwer 不动点定理在无穷维函数空间中的推广,广泛用于证明微分方程和变分问题解的存在性。在本文证明中,作者将"给定势 V 返回 Brenier 势 W"这一映射定义在合适的函数空间紧凸集上,通过验证该映射的连续性与紧性条件,即可直接调用 Schauder 定理断言不动点存在,进而保证共轭矩量测度分解方程有解。这一证明策略绕开了对分解方程直接构造解析解的困难,是处理此类非线性算子方程的标准技巧。
如何估计势函数 W
估计算法直接来自证明中的不动点结构:初始化一个势函数,在每一步用 ρ 与当前迭代 Gibbs 分布之间的 Brenier 势更新势函数,迭代至收敛。
难点在于每步都要估计两个分布间的 Brenier 势(即最优传输映射)。在一维情形下,最优传输映射有闭式解,可由起始分布的累积分布函数与目标分布的分位数函数表示,用直方图近似密度、调用 Python 库即可轻松计算。
在一维实验中,作者对比了两种分解。第一个例子是四个高度集中于零点的高斯混合:矩量测度对应的 Gibbs 分布极度分散(与高斯理论吻合),而共轭分解的 Gibbs 分布与数据更对齐。第二个例子是三个较分散的高斯混合,矩量测度的先验仍集中于零点,共轭分解依旧对齐良好。
高维:借助凸神经网络与摊销求解
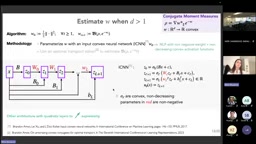
维度高于一维时,Brenier 势没有闭式解,需要依赖基于神经网络的最优传输求解器。作者用 输入凸神经网络(ICNN)——由 Brandon Amos 提出、通过对部分权重加非负约束并采用凸且非减的激活函数来保证输出凸——来参数化势函数,并用来自对偶形式的最优传输损失训练。
损失中棘手的一项是 f 的凸共轭(Legendre 变换),由于 f 凸,该项是凹函数的最大化问题,可用梯度上升求解,但每步都要重新计算并反向传播,代价高昂。作者采用 Amos 提出的摊销技巧:额外引入一个 MLP 预测凸共轭问题的解,作为求解器的热启动,从而大幅加速。实践中还发现,即使每步只对目标做一次梯度更新、得到极其"嘈杂"的最优传输映射估计,算法依然能收敛,这让最终算法相当简洁。采样时用 Langevin 蒙特卡洛(可理解为对势函数 W 做带噪梯度下降)从对数凹分布中取样,其步长根据 W 的 Hessian 最大特征值自适应调整。
**输入凸神经网络(Input Convex Neural Network,ICNN)**由 Brandon Amos 等人于 2017 年提出,专门设计用于参数化凸函数。其核心约束有两条:一是所有"直通"(skip-connection)以外的中间层权重必须为非负;二是激活函数须同时满足凸性与单调不减性(如 softplus)。这两条约束共同保证网络输出关于输入的凸性,使得梯度 ∇W 可被解释为合法的最优传输映射。**Langevin 蒙特卡洛(Langevin Monte Carlo)**是一种基于梯度的 MCMC 采样算法,其迭代格式为 x_{t+1} = x_t - η∇U(x_t) + √(2η) ε,其中 ε 是标准高斯噪声、U 是势能函数。对于对数凹分布(势能为凸),Langevin 动力学在理论上保证收敛到目标分布,步长的自适应调整(此处依据 W 的 Hessian 最大特征值)对实践中的收敛速度至关重要。
实验结果与意外发现
二维实验中,作者在五个数据集上训练并生成新样本,生成分布与原分布高度相似,且势函数 W 的等值线与目标分布很好贴合,再次印证了理论。
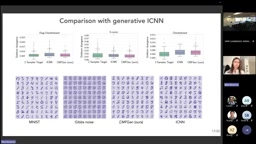
在更高维的卡通头像数据集上,模型也能生成合理图像。一个耐人寻味的现象是:与 W 关联的对数凹"噪声"竟然携带了大量信息——噪声中直接浮现出人脸轮廓,而通常生成模型使用的是无信息的高斯噪声。更进一步,从一份特定噪声就能预测最终生成图像的特征(例如"红发加墨镜"),因为采样与传输由同一个 W 联系在一起。作者坦言结果并未达到生成模型的 SOTA,但在"用凸神经网络做生成"这一类别中是最优的;实验也揭示了瓶颈——ICNN 表达力有限且训练困难。
此外,作者推导了共轭分解在密度层面对应的 Monge-Ampère 方程,使模型能像归一化流那样访问生成分布的密度,从而支持图像重建(在损坏像素上做梯度下降)等任务;并提出了当 ρ 仅已知到归一化常数(采样场景常见设定)时估计 W 的算法。
尚待解决的问题
在问答环节,唯一性成为焦点。原始矩量测度在给定条件下具有"平移意义下的唯一性",一旦放宽假设便会失去唯一性、出现无穷多解。对于共轭分解,作者尚未证明唯一性,但在所有实践例子中都稳定地恢复出同一个势函数,高斯情形下解甚至在高斯族内唯一。她也表示目前正尝试摆脱对 ICNN 的依赖——寻找不要求凸神经网络的新目标函数,甚至让采样与传输使用不同的势,从而让方法能扩展到更复杂的数据集。
关于数据存在不连续簇的疑问,作者回应称绝对连续、紧性、凸性等假设仅为数学证明所需,实践中(如图像数据往往不满足绝对连续)算法依然可以运行并有效。这项工作更像是在严谨数学与实用生成建模之间架起的一座桥梁,其价值不在刷新指标,而在于提供了一种采样与映射天然统一的全新视角。
相关推荐

好莱坞的真正对手:免费内容的降维打击
Skydance 收购华纳和派拉蒙后高喊对标硅谷,但好莱坞真正的对手是 TikTok、Instagram 和 YouTube——它们几乎不为内容付费。本文剖析免费内容大军、硅谷版权侵权文化与 AI 训练数据争议背后的成本结构之战。

KernelAgent:多智能体自动优化GPU内核,跨硬件超越专家基线
Meta 推出的 KernelAgent 是一套多智能体 GPU 内核优化框架,能自动编写并优化内核,在 GPU、TPU、AMD 及 Meta 自研 AI 芯片等异构硬件上超越专家基线。本文解析其设计思路与应用价值。

Alexa Plus一年实测:智能家居之王,为何仍走不出家门?
The Verge播客实测Alexa Plus近一年:语音创建自动化场景体验出色,成为最强智能家居助手,但跨出家门做通用助理却屡屡碰壁。亚马逊500美元新平板欲补个人情境短板,苹果Siri AI也将入场,智能家居之争背后是技术成熟与隐私信任的深层张力。