工具调用智能体的缩放定律:环境合成如何决定泛化能力
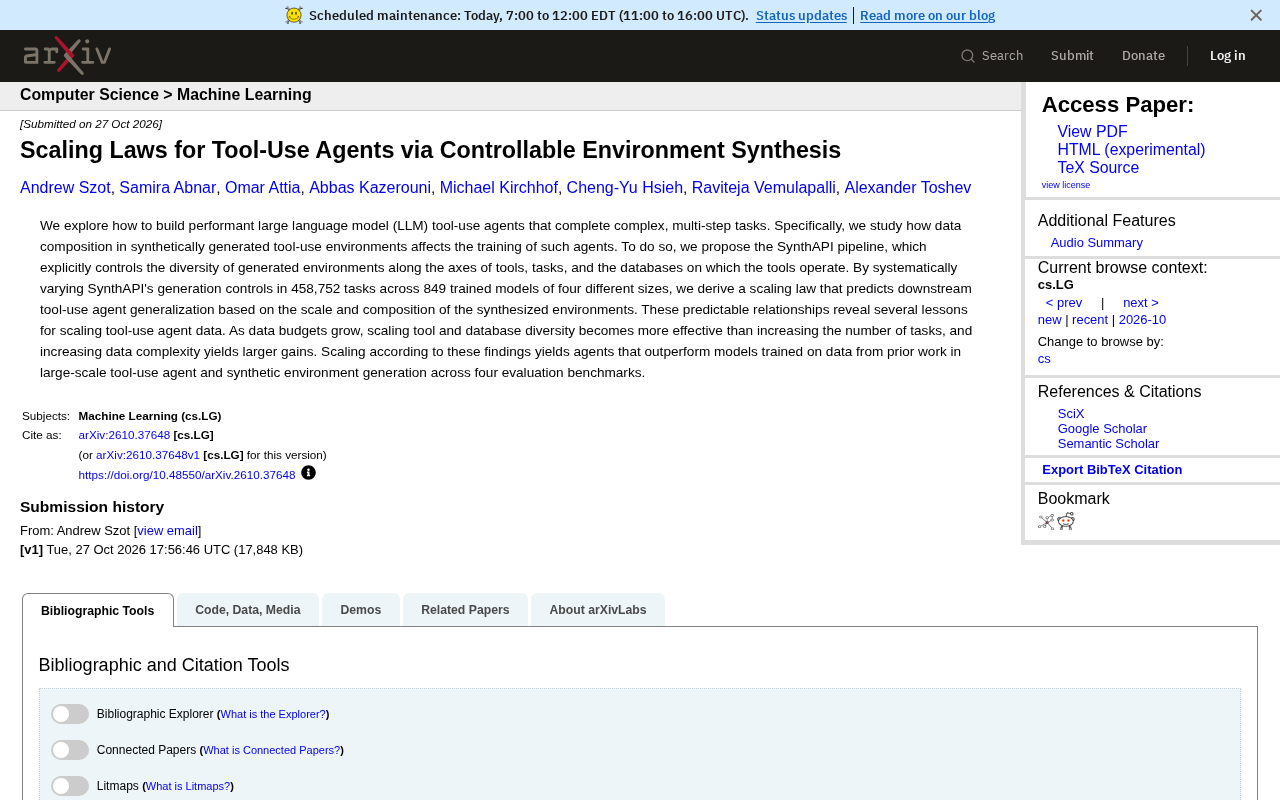
SynthAPI管道通过可控合成环境揭示工具调用智能体的数据缩放定律,发现工具与数据库多样性比任务数量更关键。
该研究提出SynthAPI管道,可沿工具、任务和数据库三个轴显式控制合成工具使用环境的多样性,并在45.8万个任务上训练了849个不同规模的模型,首次系统性地推导出工具调用智能体的数据缩放定律。核心发现包括:随着数据预算增长,单纯增加任务数量的收益递减,而扩展工具和数据库多样性更为有效;提高数据复杂度比简单堆量带来更大性能增益;依据缩放定律指导数据生成,训练出的智能体在四个评估基准上均优于先前工作。这项工作将“数据越多越好”的朴素认知推进到“数据如何配比”的可计算层面,为工具调用智能体的数据工程提供了可量化的决策依据。
工具调用(Tool-Use)智能体正成为大模型落地的重要形态,但如何高效地训练它们完成复杂多步任务,一直缺乏系统性的数据指导。近期一项研究提出了 SynthAPI 管道,通过可控合成工具使用环境,首次揭示了数据组成与智能体泛化能力之间的缩放定律。
核心问题:数据配比比数据量更重要
研究团队关注的是:在合成生成工具使用环境时,数据组成如何影响智能体训练效果。他们提出的 SynthAPI 管道,能够沿工具、任务和数据库三个轴显式控制生成环境的多样性。这意味着研究者可以系统性地调节环境复杂度,而不只是盲目扩大数据规模。
为了推导缩放定律,团队在 458,752 个任务上训练了 849 个不同规模的模型(共四种尺寸),通过系统变化 SynthAPI 的生成控制参数,观察下游泛化表现的变化规律。这种大规模受控实验在工具调用智能体研究中并不多见。
工具调用智能体(Tool-Use Agent) 是指能够根据用户指令,自主规划并调用外部工具(如搜索引擎、计算器、API接口、数据库查询等)来完成复杂任务的大语言模型智能体。与仅生成文本的模型不同,这类智能体需要理解工具的功能语义、构造合法的调用参数、解析工具返回结果,并在多步任务中维护状态与上下文。其核心挑战在于:模型不仅要“会说”,还要“会做”——在动态环境中做出正确的工具选择与调用决策。训练此类智能体通常需要大量包含工具调用轨迹的交互数据,而真实环境中的数据获取成本高、覆盖范围有限,因此合成数据成为关键手段。SynthAPI 这类可控合成管道的出现,正是为了解决训练数据中工具多样性和任务复杂度难以系统调控的问题。
缩放定律揭示的三个关键发现
基于实验数据,研究者得出了可预测下游工具调用智能体泛化能力的缩放定律。几个反直觉的结论值得关注。
工具与数据库多样性比任务数量更有效
随着数据预算增长,单纯增加任务数量带来的收益会递减,而扩展工具和数据库的多样性变得更为有效。这意味着,与其让智能体在大量相似任务上重复训练,不如让它接触更多样的工具接口和底层数据库结构。
缩放定律(Scaling Law) 最初在语言模型研究中被广泛验证,指模型性能(如损失或下游准确率)随模型规模、数据量和计算量的增加而呈现可预测的幂律关系。将这一概念迁移到工具调用智能体的训练数据上,意味着研究者试图建立数据组成(工具多样性、任务数量、数据库多样性、复杂度等)与智能体泛化性能之间的定量函数关系。与传统的“数据越多越好”不同,数据缩放定律关注的是数据配比的边际收益:在固定数据预算下,不同维度的数据扩充对性能的贡献并不均等。本研究的贡献在于首次在工具调用智能体场景下系统性地推导出这种可预测关系,使数据工程从经验驱动转向可计算、可优化的方向。
数据复杂度提升带来更大增益
提高数据复杂度(而非简单堆量)能带来更显著的性能提升。复杂环境迫使智能体学习更鲁棒的工具使用策略,这种策略更容易迁移到未见过的任务上。
缩放定律可用于指导数据生成
这些可预测的关系直接转化为数据缩放的操作指南。按照研究发现来缩放数据,训练出的智能体在四个评估基准上均优于使用先前工作数据训练的模型——这些先前工作同样涉及大规模工具调用智能体和合成环境生成。
合成环境生成(Synthetic Environment Generation) 是指通过程序化方法自动构建包含工具接口、任务指令和底层数据库的虚拟交互环境,用于训练和评估智能体。与真实环境相比,合成环境的核心优势在于可控性:研究者可以精确调节环境的复杂度参数(如工具数量、任务类型分布、数据库schema的丰富程度),从而开展受控实验。SynthAPI 管道沿工具、任务、数据库三个轴显式控制多样性,使得“环境复杂度”从随机变量变为可调自变量。这种方法论价值在于,它让研究者能够分离并量化各个数据维度对智能体泛化能力的独立贡献,而不会受到真实数据中混杂因素的干扰。
对工具调用智能体训练的启示
这项工作的价值在于把“数据越多越好”的朴素认知,推进到“数据怎么配比”的可计算层面。SynthAPI 的受控生成思路,让环境多样性成为可调参数,而不是随机结果。
对于实际训练工具调用智能体的团队,这意味着在规划数据预算时,应优先考虑工具和数据库的覆盖广度,其次才是任务数量的堆叠。同时,主动提升合成环境的复杂度,可能比收集更多简单样本更划算。
研究还表明,缩放定律不仅能预测性能,还能反向指导数据合成管道的设计。这种“预测-指导”闭环,为合成数据在智能体训练中的系统性应用提供了方法论基础。
总结
SynthAPI 管道和相应的缩放定律,为工具调用智能体的数据工程提供了可量化的决策依据。工具多样性、数据库多样性和数据复杂度,是比任务数量更关键的缩放维度。随着智能体应用场景日益复杂,这类受控环境合成与缩放规律研究,将成为提升智能体泛化能力的重要基础设施。
相关推荐
Claude Code实战:零代码搭建切片工厂,长视频自动变竖屏短视频
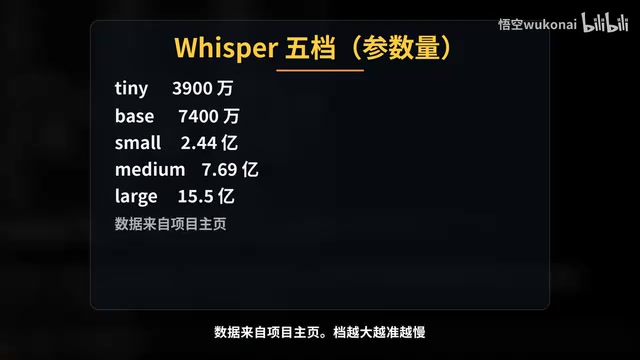
B站UP主悟空用Claude Code零代码搭建切片工厂,将35分钟长视频自动切成10条竖屏短视频。从Plan Mode、Whisper转写、claude.md规则、Hook质检到Subagent审核和Plugin分发,完整实战流程与实测数据。
WorkBuddy保姆级教程:AI Agent如何帮你自动转文件
WorkBuddy保姆级教程实战:从豆包只能给方案到AI Agent直接动手,三分钟批量转换PDF并归档。含安装、积分机制、与Codex对比及上手建议。
零基础入门Java+DeepSeek实战:程序员转型AI大模型开发指南
本文基于B站直播教学,详解Java程序员如何零基础转型AI大模型开发,涵盖技能路径、实战构建第一个Java AI应用、简历包装与求职策略,助你抓住大模型时代机遇。