多模型热切换架构:低成本实现AI模型自由切换

通过模型抽象层架构设计,实现AI模型一分钟热切换
文章针对AI项目中模型切换成本高的痛点,提出三层解耦的热切换架构方案:业务逻辑层、模型抽象层和配置管理层。核心步骤包括用AI工具摸清项目模型层、设计前端可视化配置页+后端持久化存储实现热加载、以及建立配置报错的标准修复流程。该方案通过适配器模式统一不同模型SDK差异,让模型切换从改代码一周压缩为填表一分钟。
引言:模型切换不该是一场噩梦
当你使用的AI模型突然涨价或被限流,你需要把项目从一个模型切换到另一个——这时候你是翻开代码改一个礼拜,还是在网页上填三个字段、一分钟切完,连服务都不用重启?
这个问题的答案,取决于你的项目架构中是否预留了模型抽象层。本文将拆解多模型工程化适配的完整链路,帮你把"换模型"从一周的工程量压缩成一个动作。
模型名写死在代码里的代价有多大
很多开发者(包括笔者自己)最早做多模型项目时,都有一个错误认知:切模型就是改个接口名字的事。
直到真正要把项目从一个模型切到另一个,打开代码才傻眼:
- 模型名散落在几十处,到处都是硬编码
- 提示词模板各处都有自己的定制版本,牵一发动全身
- 前后端连响应格式的假设都耦合在一起,改一个地方就崩另一个
最致命的场景是:业务方一句"这个回答不如之前的,能不能切回去?"——你看着刚改完的几十个文件,一句话都说不出来。
硬编码的技术债务为何如此昂贵?
硬编码(Hard Coding)指将本应作为配置的值直接写入源代码。在软件工程中,硬编码被视为一种典型的技术债务,其代价会随时间指数级增长。对于AI模型名称的硬编码,问题尤为突出:模型版本迭代频繁(如GPT-4到GPT-4o再到GPT-4.1),厂商随时可能弃用旧版本;价格策略调整、限流政策变化都可能迫使紧急切换。每一次被动切换,开发者都要承担全量代码扫描、回归测试、重新部署的完整成本,而这些成本在架构设计阶段本可以一次性消除。
后来才彻底想明白:多模型适配从来不是工程问题,是架构问题。它应该在写第一行代码之前就把"模型随时能换"这一层留出来。
三步构建多模型热切换架构
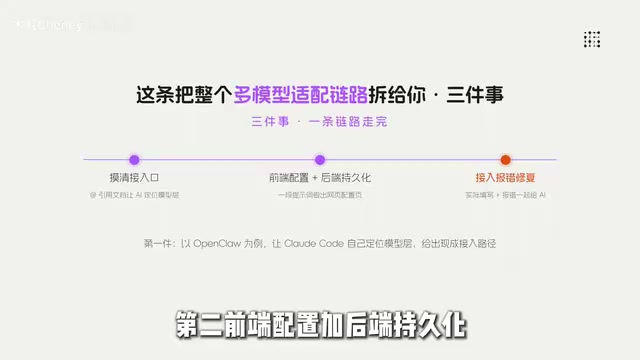
整个多模型工程化适配的链路,核心就三件事:模型层定位、前端配置设计、报错修复闭环。
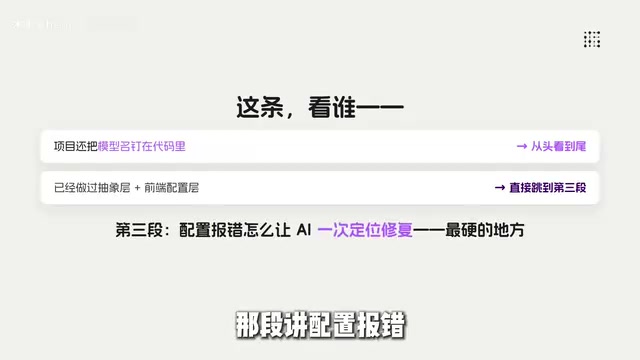
第一步:用AI工具摸清项目的模型层
以OpenAI和Claude为例,第一步不是急着写代码,而是让Claude Code(或类似的AI编程工具)自己摸清楚项目现在支持哪些模型接入。
关键方法是:用引用项目文档的方式,让AI去定位模型层,给出现成的接入路径,而不是你自己翻源码。这样做的好处是:
- AI能快速扫描整个代码库,找到所有模型相关的调用点
- 自动生成当前模型依赖的拓扑图
- 给出标准化的抽象层接入建议
第二步:前端配置页面 + 后端持久化存储
这一步的核心是设计一个网页配置页,让模型切换变成"填表"操作。
具体来说,需要设计一段把需求说清楚的提示词,让AI帮你生成:
- 前端配置页面:包含模型选择、API Key、Base URL、模型参数等字段
- 后端持久化逻辑:将配置存储到数据库或配置文件,支持热加载
- 模型适配器模式:统一的调用接口,底层自动路由到不同模型的SDK
为什么需要"热加载"而不是重启服务?
热加载(Hot Reload)指在不重启服务进程的情况下,动态更新运行时配置。实现热加载的常见方案包括:将配置存储在数据库或Redis中,服务启动时加载到内存,配置变更时通过消息队列或轮询机制触发内存刷新;或使用文件系统监听(如Node.js的
fs.watch)实时感知配置文件变化。对于AI模型切换场景,热加载意味着切换模型后无需重新部署,线上服务零中断,这对高可用业务场景尤为关键。
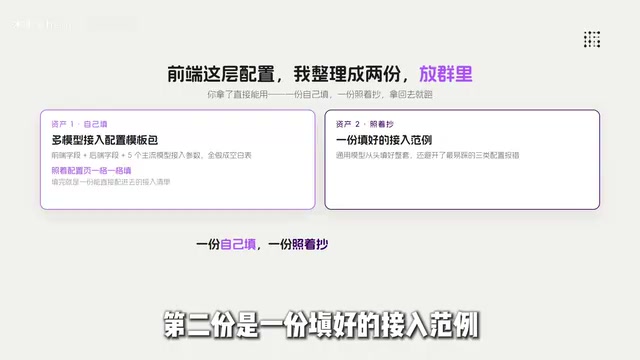
对于主流模型的接入参数,核心字段通常包括:
| 字段 | 说明 |
|---|---|
| Provider | 模型提供商(OpenAI/DeepSeek广告/Claude/Gemini/通义千问广告) |
| API Key | 接入密钥 |
| Base URL | API端点地址 |
| Model Name | 具体模型版本 |
| Temperature | 温度参数 |
| Max Tokens | 最大输出长度 |
为什么同样是"填API Key",不同模型的字段含义却不一样?
不同AI厂商在API设计上存在显著差异,这正是模型抽象层存在的根本原因。认证方式上,OpenAI和DeepSeek使用Bearer Token,Claude使用
x-api-key请求头,部分国内厂商还需要额外的签名机制。响应格式上,OpenAI将内容放在choices[0].message.content,Claude放在content[0].text,Gemini放在candidates[0].content.parts[0].text。流式输出协议上,各家的SSE(Server-Sent Events)数据格式也不统一。这些差异如果不在适配器层统一处理,就会渗透到业务代码的每一个角落,让"填表切换"变成奢望。
填完这些字段,就是一份能直接配进系统的接入清单,不用再去猜每个模型该填什么、填在哪里。
第三步:配置报错的标准修复流程
接入新模型时,报错是家常便饭。但关键不是甩给AI一句"报错了",而是要把你实际填的内容连同报错信息一起给它。
这是AI能一次定位、一次修对的前提。具体操作:
- 截取完整报错信息:不只是错误码,还要包含请求参数和响应体
- 附上你填写的配置内容:让AI能对比配置与报错的关联
- 说明你的预期行为:告诉AI你期望的正确结果是什么
常见的三类配置报错及修复思路:
- 认证失败(401/403):通常是API Key格式不对或Base URL填错,不同厂商的Key前缀和URL格式差异很大
- 模型不存在(404):Model Name拼写错误或该Key没有对应模型的访问权限
- 响应格式解析失败:不同模型的返回结构不同,需要在适配器层做统一的响应格式转换
热切换架构的核心设计原则
回顾整个方案,多模型热切换架构的本质是三层解耦:
- 业务逻辑层:只关心"我要一个AI回答",不关心底层是哪个模型
- 模型抽象层:统一接口定义,屏蔽不同模型SDK的差异
- 配置管理层:前端可视化配置 + 后端持久化,支持运行时热切换
适配器模式:让"翻译层"承担所有兼容性工作
适配器模式(Adapter Pattern)是经典的GoF设计模式之一,其核心思想是在不兼容的接口之间建立一个"翻译层"。在多模型场景下,每家AI厂商的SDK接口设计各异:OpenAI使用
chat.completions.create(),Anthropic Claude使用messages.create(),Google Gemini使用generateContent(),参数命名、响应结构、流式输出协议都不尽相同。适配器模式将这些差异全部收敛到一个统一的内部接口,业务代码只与这个内部接口交互,底层切换对上层完全透明。这也是为什么在这套架构下,切换模型不需要改一行业务代码。
这套架构能适配80%以上的通用业务场景。无论是对话类、生成类还是分析类应用,模型切换都不需要改一行业务代码。
总结:模型抽象层是工业级AI项目的标配
你会不会在写代码之前就留出"模型随时能换"这一层,决定了下一次涨价、限流来的时候,你是改一个礼拜还是切一分钟。
多模型适配不是等到出问题才去做的事,它是工业级AI项目的标配能力。核心要点:
- 模型名永远不要硬编码在业务代码中
- 用适配器模式统一不同模型的调用接口
- 配置层做到前端可视化、后端可持久化、运行时可热加载
- 报错修复时,给AI完整的上下文而不只是一句"报错了"
这套方案的投入成本不高,但在模型生态快速变化的今天,它能帮你省下的时间和风险是巨大的。
核心要点
- 多模型适配是架构问题而非工程问题,应在项目初期就预留模型抽象层
- 通过前端配置页+后端持久化实现模型热切换,支持OpenAI、DeepSeek、Claude、Gemini、通义千问等主流模型
- 利用AI编程工具(如Claude Code)自动分析项目模型层,定位所有模型调用点并生成标准化接入路径
- 配置报错修复的关键是提供完整上下文:实际填写内容+报错信息+预期行为,让AI一次定位修对
- 三层解耦架构(业务逻辑层、模型抽象层、配置管理层)可适配80%以上通用业务场景
相关推荐
 教程攻略
ChatGPT Plus订阅指南:GPT-5.5、image-2与Codex值得升级吗
详解ChatGPT Plus核心功能GPT-5.5、image-2图像生成和Codex编程助手的实际体验,对比Plus与Pro方案差异,并提供国内用户安全订阅的完整操作流程与避坑建议。
 教程攻略
Cursor+Codex双IDE协同:开源项目二开实战方法论
基于实战经验总结的开源项目二次开发完整方法论,详解Cursor+Codex双IDE协同工作流,涵盖二开七环节、MVP验证、AI读源码技巧,帮助开发者三天跑通项目、两周完成业务集成。
 教程攻略
Cursor多Agent实战:50分钟搭建Next.js全栈博客
使用Cursor IDE多Agent协作模式,50分钟内从零搭建全栈博客。涵盖Next.js、Clerk认证、Supabase数据库集成,详解4个AI Agent分阶段开发流程与关键避坑经验。