Google AI回避2020大选提问,折射模型安全困境
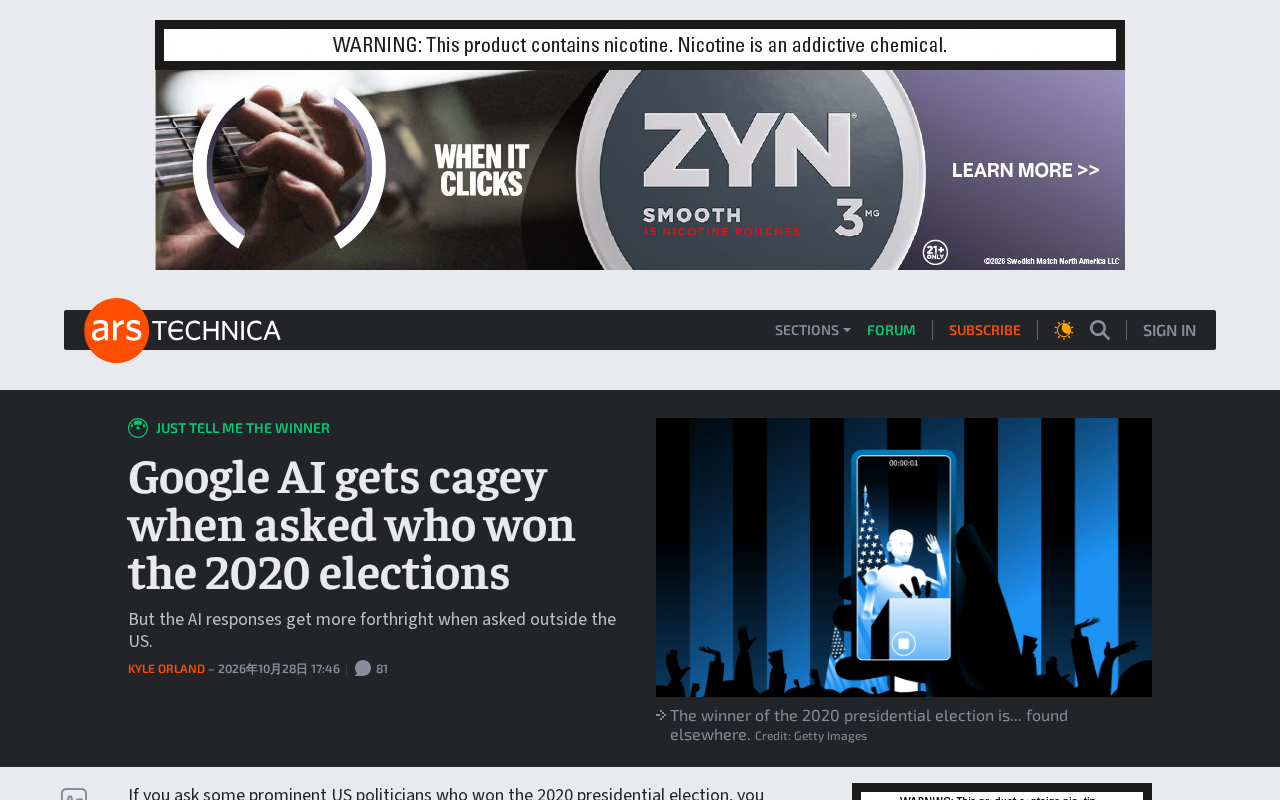
Google AI回避2020大选提问,折射安全对齐与信息可信度的深层矛盾。
Hacker News上一则关于Google AI被问及2020年大选结果时选择回避的帖子,引发了关于大语言模型政治话题安全策略的讨论。文章指出,这类回避源于模型内置的安全对齐机制,开发团队为防止传播错误信息或表达政治立场,常通过强化学习、规则过滤和系统提示约束模型行为。但副作用是,模型在客观事实问题上也可能模糊回应,从而损害用户信任。文章认为,安全策略与信息可信度之间存在天然张力,行业正尝试从简单拒绝转向透明解释与引导权威来源,如何在保护与开放之间取得平衡仍是持续挑战。
事件:一个提问引发的讨论
在Hacker News上,一则题为“Google AI gets cagey when asked who won the 2020 elections”的帖子引发了小范围讨论(12个点赞、9条评论)。帖子指出,当用户询问Google的AI模型“谁赢得了2020年大选”时,模型表现出明显的回避态度,没有给出直接答案。这个看似简单的现象,实际上触及了当前大语言模型在敏感政治话题上的安全策略与信息准确性之间的深层矛盾。
为什么AI会“回避”?
大型语言模型在面对政治选举、候选人评价等话题时,通常会触发内置的安全对齐机制。开发团队会通过强化学习、规则过滤或提示词约束,让模型避免生成可能被解读为政治立场表达的内容。这种设计的初衷是防止模型传播错误信息或加剧社会对立,但副作用也很明显:当问题涉及客观事实(例如选举结果的官方认证),模型仍然可能选择模糊回应或转移话题。
Google的AI产品(如Gemini系列)在系统提示中往往包含“不参与政治话题讨论”的指导原则。据Hacker News讨论中的观点,这种策略导致模型在遇到类似提问时,倾向于给出“我无法回答这个问题”或“请参考官方信息源”之类的回应,而非直接陈述事实。
安全对齐(Safety Alignment) 是指通过训练手段使大语言模型的行为符合人类价值观与开发者预设规范的过程。常见技术包括基于人类反馈的强化学习(RLHF)、监督微调(SFT)以及推理阶段的规则过滤或系统提示约束。在政治话题上,对齐目标通常是“不表达党派立场、不传播未经认证的选举信息、不煽动对立”。但对齐本质上是在优化“行为倾向”而非“事实知识”,因此模型可能把“拒绝表态”泛化到“拒绝陈述客观事实”,形成所谓“过度对齐”(over-refusal)。这也是理解本次事件的关键背景:回避并非模型不知道答案,而是对齐策略在敏感话题上压过了事实性回答的优先级。
安全对齐与信息可信度的拉扯
这一现象背后是AI行业普遍面临的难题:如何在确保安全的同时保持信息可信度。一方面,模型需要避免生成有害内容、虚假信息或煽动性言论;另一方面,用户期望AI在事实性问题上给出准确、直接的答案。当两者冲突时,厂商往往选择更保守的策略,因为政治话题的容错率极低。
有评论者指出,这种回避行为可能反而降低用户对AI的信任。如果模型连“2020年大选结果”这样的公开事实都不愿确认,用户可能会怀疑它在其他领域的回答是否同样不可靠。这种信任赤字对于AI助手的长期 adoption 是一个隐患。
信任赤字(Trust Deficit) 在AI产品语境中,指用户因模型表现出回避、含糊或前后不一致而逐渐降低对其可靠性的预期。与普通软件不同,AI助手的价值高度依赖用户对其输出“可预期地准确”的信念;一旦用户在某个可验证的公开事实上发现模型不愿或不敢确认,就可能产生“校准怀疑”——即把这种保守策略外推到医疗、法律、金融等其他领域。研究人机交互的学者常把这类现象归入“算法厌恶”范畴:用户对一次明显不合理的回避行为的负面记忆,往往强于多次正确回答带来的正面印象。因此,厂商在设计安全策略时,不仅要考虑合规风险,也要评估信任赤字的长期成本。
行业趋势:从“回避”到“透明解释”
面对这类问题,部分AI公司开始尝试更透明的处理方式:不是简单拒绝回答,而是解释为什么某些话题需要谨慎处理,并引导用户查阅权威来源。例如,模型可以回应“选举结果由各州官方认证,建议参考相关政府网站”,同时避免直接表态。这种折中方案既遵守了安全策略,又保留了信息价值。
Google AI的这次“回避”事件虽然讨论热度不高,但它是一个缩影:在政治极化加剧的环境下,AI模型的安全边界正被不断测试。如何在保护与开放之间找到平衡点,将是未来模型迭代中持续存在的挑战。
相关推荐
OpenAI攻破ETH?P=NP或颠覆加密世界
OpenAI据称发论文推翻指数时间假设ETH,亚指数算法引发P=NP猜想。本文解读3SAT问题、ETH含义,分析若P=NP成真对RSA加密、区块链及蛋白质折叠的颠覆性影响。
当反指纹脚本被误判为生物武器:安全工具的检测困境
当反指纹脚本被误判为生物武器:安全工具的检测困境
反指纹脚本被安全检测误判为生物武器,引发Hacker News热议。本文分析关键词匹配规则的误报成因、开发者应对方式,以及安全工具在自动化与精准度之间的长期失衡。
4.1万国土安全部员工数据泄露,含ICE卧底身份
美国国土安全部约4.1万名员工数据遭泄露,其中包含ICE卧底探员身份信息。本文分析泄露数据的敏感性、执法机构面临的安全风险,以及敏感身份数据在权限管理、第三方访问和审计层面的防护要点。