Google Cloud Platform入门实战:GCP核心服务速成指南

面向AI工程师的GCP速成:六大核心服务、IAM权限模型与成本控制要点全览
本文基于一份GCP初学者速成教程,系统梳理了Google Cloud Platform的核心架构与实操要点。文章从项目与计费账户的组织逻辑出发,依次介绍Cloud Storage(对象存储)、Cloud Run(容器化应用部署)、Compute Engine(虚拟机)、Cloud SQL(托管数据库)、BigQuery(数据仓库分析)和Vertex AI(AI/ML平台)六大核心服务,并贯穿讲解了IAM权限模型的核心地位。文章特别强调GCP的事后计费风险——预算警报并非硬性限制,最安全的控费手段是限制功能而非金额,必要时直接删除项目。gcloud CLI遵循"服务名+资源名+动作"的统一结构,掌握规律后上手新服务的学习成本大幅降低。整体目标是帮助初学者建立起GCP的全局地图,而非深入某一服务的细节。
对于AI与机器学习工程师而言,掌握云平台已经成为绕不开的核心技能。无论是AWS、Azure还是GCP,当一个项目从个人实验走向生产环境时,合规、安全、可扩展性等问题就会扑面而来,而云平台正是为简化这些复杂度而生。本文基于一份面向初学者的GCP速成教程,梳理出Google Cloud Platform最重要的几项服务、核心术语以及控制台UI与gcloud命令行(CLI)的实操要点。
从项目与计费账户开始
GCP的组织逻辑建立在"项目(Project)"这一最高层级的容器之上。一个项目可以拥有多个资源(Resources),而资源是各类服务(Service)的具体实例。创建项目时需要注意:项目名称不要求全局唯一,但由此生成的项目ID是全局唯一的——如果你用了"test"这种常见名称,系统会自动追加数字。很多命令行操作都需要指定项目ID而非名称,这一点务必分清。
另一个绕不开的前提是计费账户(Billing Account)。GCP上几乎所有服务都需要绑定支付方式,哪怕只收取几美分。教程中反复强调一个关键风险点:GCP采用事后计费模式,不像预充值那样设硬性上限。你用了多少资源,Google就在事后向你收取多少费用,即便账户余额不足,这笔钱依然算作欠款。因此养成及时删除闲置实例的习惯至关重要。
Cloud Storage:最简单的存储服务
Cloud Storage是上手GCP最直观的服务。它的核心概念是存储桶(Bucket)——一个存放文件和文件夹的空间。创建桶时需要指定一个全局唯一且永久的名称,这意味着一旦创建便无法更改。
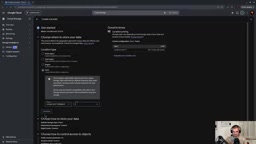
创建过程中会遇到"区域(Region)"这一重要术语,它决定了服务器的物理位置,直接影响延迟与合规性。你可以选择单一区域、多区域(最高可用性,适合EU合规场景),或更细粒度的"可用区(Zone)"。存储类别方面,Standard适合频繁访问的常规数据,Nearline用于一个月内的备份,Coldline对应季度级访问,Archive则用于长期归档——越往下延迟越高、成本越低。
一个容易混淆的细节是分层命名空间(Hierarchical Namespace)。如果不启用它,你创建的"文件夹"其实只是文件名的前缀,并非磁盘上真实的目录结构。对于存储带目录结构数据集的机器学习场景,启用这一选项会更合理。
命令行中创建桶同样简洁,遵循 gcloud storage buckets create gs://桶名 --location=europe-west4 的统一模式。
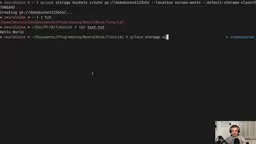
上传文件用 gcloud storage cp 即可完成。GCP CLI的命令结构高度一致:gcloud 服务名 资源名 动作,掌握这个规律后学习新服务会轻松许多。
Cloud Run:部署容器化应用
如果说Cloud Storage是"存东西",那Cloud Run就是"跑东西"——用于部署Docker容器、网站或Web应用。教程演示了两种部署路径:从源码直接部署,以及上传预构建Docker镜像后再部署。
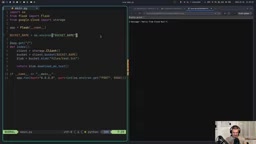
从源码部署只需一条 gcloud run deploy 命令,但首次运行会暴露一个典型问题:默认计算服务账户缺少构建容器的权限,导致部署失败。解决方法是进入**IAM与管理(IAM & Admin)**界面,为默认服务账户添加"Cloud Run Builder"角色。这也引出了GCP的核心概念——IAM是管理所有权限、策略、角色与服务账户的中枢。
更进阶的场景是让部署的应用访问其他服务。教程中构建了一个能从私有存储桶读取文件内容的Flask应用,关键在于为Cloud Run服务配置一个具备"Storage Object Viewer"角色的专用服务账户,而非依赖默认账户。整个流程涉及本地构建Docker镜像、推送到Artifact Registry、再从镜像仓库部署,权限的精细化配置是其中的难点。
Artifact Registry 是GCP托管的私有容器镜像仓库(类似Docker Hub的私有版),也支持存储Maven、npm等其他制品。在Cloud Run的进阶部署流程中,本地构建好的Docker镜像需要先推送到Artifact Registry,Cloud Run再从中拉取镜像进行部署。这一环节同样受IAM管控——服务账户需要具备对应仓库的读取权限,否则部署会因无法拉取镜像而失败。与直接从源码部署相比,预构建镜像的方式让构建过程与部署过程解耦,更适合CI/CD流水线场景。
服务账户(Service Account) 是GCP中代表"应用程序或服务"的身份,区别于代表真实用户的普通账户。Cloud Run中的每个服务都以某个服务账户的身份运行,该账户持有什么角色,服务就只能访问对应的资源。最小权限原则(Principle of Least Privilege)要求为每个服务创建专用账户并只授予必要权限,而非共用默认账户——这既降低了安全风险,也使权限审计更清晰。
Compute Engine与Cloud SQL
Compute Engine用于启动虚拟机(VM)。创建实例时右侧会实时显示每月与每小时成本,可通过切换区域、调整核心数与内存影响价格——最便宜的e2-micro预设约每月9美元。选择操作系统(默认Debian)、开放HTTP/HTTPS流量后即可创建,之后可通过浏览器SSH或命令行 gcloud compute ssh 连接。
Cloud SQL提供托管的MySQL或PostgreSQL数据库,在合规、安全、备份方面比本地自管更省心。教程作者坦言不喜欢它的图形界面(会用30天免费优惠干扰自定义实例创建),更推荐纯命令行操作。需要注意的是,连接实例前必须安装cloud-sql-proxy组件,这也是教程作者在Arch Linux的AUR安装包上踩过坑的地方——最终只有用官方默认安装方式才能跑通。
BigQuery与Vertex AI
BigQuery是GCP最知名的数据分析服务,本质是一个一站式数据仓库,地位类似Databricks或AWS SageMaker。教程演示了对公开数据集(如Stack Overflow问题库)运行SQL查询,并提示:查询界面会显示本次将处理的数据量(如1.98GB),而LIMIT子句并不会减少扫描量——这直接关系到计费。值得一提的是,BigQuery拥有独立的bq命令行工具,可用于创建数据集、加载CSV、执行查询,侧面反映了这项服务的分量。
Vertex AI则是AI/ML领域最重要的服务。教程给出两个方向:一是直接调用Google的生成式模型(如Gemini 2.5),并强调可强制EU数据驻留以满足合规要求(作者特别声明这不构成法律建议,需自行研究);二是本地训练scikit-learn模型后部署到Vertex AI作为API使用。后者流程较长——上传模型到存储桶、gcloud ai models upload注册模型、创建端点、再部署到端点,整个部署过程可能耗时数十分钟。
数据驻留(Data Residency) 指将数据的存储与处理限定在特定地理区域内,是欧盟《通用数据保护条例》(GDPR)合规的核心要求之一。Vertex AI支持将模型推理请求强制路由至欧盟区域节点,确保用户输入的提示词(Prompt)及模型响应不会离开欧盟境内的数据中心,从而帮助企业满足"数据不出境"的监管要求。需要注意的是,实现合规不仅靠选择正确的区域,还需要审查服务条款、数据处理协议(DPA)及内部数据治理流程,云平台的技术设置只是整体合规框架的一部分。
LIMIT子句不减少扫描量 这一BigQuery特性源于其底层的列式存储与全表扫描架构(Dremel引擎)。BigQuery在执行查询时会先完整扫描所有涉及的列,再对结果集截取LIMIT指定的行数——计费依据是扫描的数据字节数而非返回的行数。控制成本的正确方式包括:使用分区表(Partitioned Table)按时间或字段分区以缩小扫描范围、通过聚簇(Clustering)让相关数据物理相邻、或在查询前使用"本次将处理X GB"的预估提示来决策是否执行。
成本控制:预算、警报与硬限制
由于GCP的事后计费特性,成本管理是初学者必须重视的环节。教程给出几个关键认知:
- 预算与警报不是硬性上限。设置10欧元预算警报只会在达到50%、90%、100%时发邮件通知,且通知可能延迟,并不会自动停止消费。
- 新推出的**支出上限强制(Spend Cap Enforcement)**功能目前处于预览阶段,仅对部分服务可用,不能保证完全阻断成本。
- 真正安全的做法是限制功能而非成本——例如在Vertex AI中为某个模型设置每小时百万token的硬限制,因为这类限制不直接关联费用。
- 停止一切开销最彻底的方式是直接删除项目,这会立即终止计费(但此前产生的费用仍需结算)。
要排查费用来源,可以查看"API与服务"中正在处理请求的服务、IAM资产清单中的活跃资源,以及计费账户的消费概览——但后者数据可能有约24小时的延迟,不可完全依赖其实时性。
GCP计费数据约有24小时延迟的根本原因在于其计费管道的异步架构:资源使用量先由各服务上报至计费系统,再经过聚合、汇率换算、折扣计算等处理后才形成可查账单。这意味着凌晨突然飙升的费用可能要到次日才会反映在控制台中。为应对这一盲区,可以结合Cloud Monitoring设置基于资源指标(如VM CPU使用率、API调用次数)的实时警报,而不单依赖计费警报——资源异常往往比账单异常更早被指标层面的监控捕捉到。
小结
这份速成教程的价值在于用"动手学"的方式,帮初学者建立对GCP的整体认知:理解项目/资源/服务的层级关系,掌握控制台UI与gcloud CLI两套操作方式,熟悉Cloud Storage、Cloud Run、Compute Engine、Cloud SQL、BigQuery、Vertex AI六大核心服务,以及至关重要的IAM权限模型和成本控制机制。每一项服务都足以展开成独立的深度教程,但先建立起"知道有什么、知道去哪找"的全局地图,才是高效上手云平台的起点。
相关推荐

AI编程为何离不开Git?从版本回退到AI辅助命令全解析
Git是AI编程的必备工具。本文解析Git分布式版本控制在AI编程中的价值,包括应对AI幻觉的版本回退、分支管理等核心操作,以及如何用豆包、AI输入法等工具快速生成Git命令,帮助新手零基础入门。

拒绝AI胡编:一款"说不了谎"的求职信生成器是如何炼成的
一位开发者因AI求职信工具凭空捏造其Kubernetes经验和管理经历而屡遭拒信,于是打造了CoverCraft——通过代码计算评分、GitHub提交记录背书、对抗性审查与人工审批四重机制,构建一款"无法说谎"的AI求职信生成器。本文解析其对抗AI幻觉的工程设计。
Perplexity携手美国运通:为小企业主打造即用型AI技能库
Perplexity携手美国运通:为小企业主打造即用型AI技能库
Perplexity 联合美国运通推出面向小企业卡会员的即用型 AI 技能库,内置现金流预测、营销活动生成等预构建工作流,用户无需编写提示词即可让 AI 处理日常业务任务。