Google 反爬新招:goto 链接如何拦截搜索结果抓取
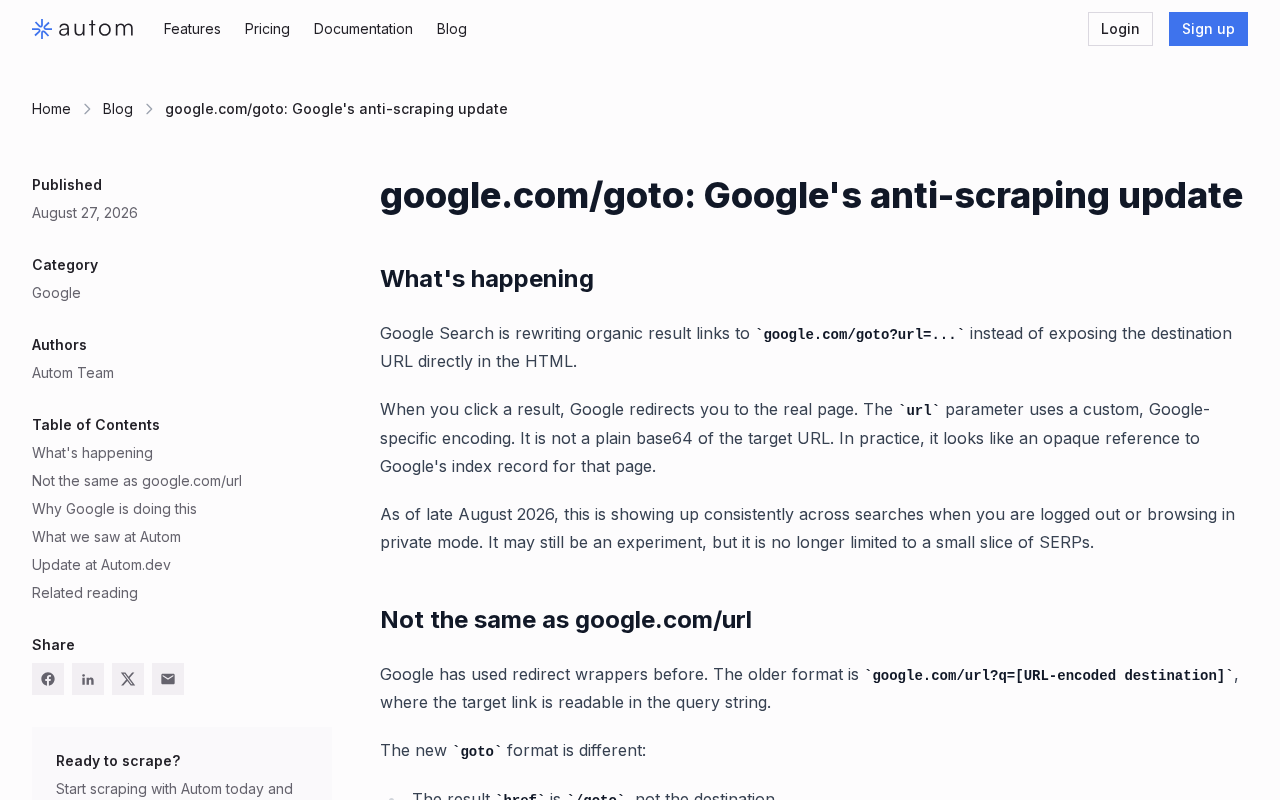
Google搜索引入/goto中转跳转链接,以抬高AI时代自动化爬虫的抓取门槛。
Google近期在搜索结果页面引入`google.com/goto`中转跳转机制,不再直接暴露目标网站的裸URL,而是通过服务端重定向层完成跳转。这一改动在用户体验上几乎无感,却大幅提升了自动化爬虫的抓取成本,迫使其处理动态生成、含签名参数的重定向逻辑。其背景是AI训练数据采集、RAG系统构建等需求激增,导致搜索结果页承受前所未有的自动化抓取压力。对SEO监控、竞品分析等依赖搜索数据的工具开发者而言,既有抓取管线可能需要重构;而从更宏观的视角来看,这是搜索巨头对数据主权的一次技术性重申,预示着随手抓取搜索结果的红利期正在收紧。
Google 搜索悄然变脸:/goto 跳转链接登场
搜索引擎与爬虫之间的博弈从未停止。近期,Google 在其搜索结果页面引入了一种新的链接跳转机制——google.com/goto,被开发者社区视为一次针对性极强的反爬虫(anti-scraping)升级。这条消息在 Hacker News 上引发热议,获得了近 300 点赞和上百条评论,反映出技术圈对这一变化的高度关注。
过去,Google 搜索结果中的链接往往可以被相对直接地解析——爬虫抓取页面 HTML,提取其中的目标 URL,就能批量获取搜索结果数据。而 /goto 跳转链接的出现,则在结果链接与真实目标地址之间插入了一层 Google 自有的中转层,让第三方直接从页面结构中提取干净链接变得更加困难。
/goto 链接的技术逻辑
从直链到中转跳转
所谓 /goto 链接,简单来说就是 Google 不再在搜索结果中直接暴露目标网站的裸 URL,而是把用户点击行为导向一个形如 google.com/goto 的中间地址,再由该地址完成到目标站点的重定向。
这种做法在浏览器体验上几乎无感——普通用户点击后依然能正常跳转到目标页面。但对自动化抓取程序而言,情况就不同了:它们需要额外处理这层重定向逻辑,甚至可能面对动态生成、带签名参数或依赖 JavaScript 执行的跳转地址,从而显著抬高抓取成本。
反爬虫的核心意图
这一改动的核心目的在于抬高机器化数据采集的门槛。近年来,随着大量 AI 训练数据采集、SEO 排名监控工具、以及各类第三方搜索数据服务的兴起,Google 搜索结果页正承受着前所未有的自动化抓取压力。通过引入中转跳转,Google 可以:
- 让简单的 HTML 解析失效,迫使爬虫模拟更完整的浏览器行为;
- 更精细地追踪与识别异常流量模式;
- 在必要时对可疑请求进行拦截或降级。
对于依赖搜索结果数据的工具开发者来说,这意味着原有的抓取管线可能需要重构。
为什么这件事值得关注
AI 时代的数据主权之争
这次更新的背景无法脱离当下的 AI 浪潮。搜索结果本质上是互联网内容的高质量索引,对训练大模型、构建检索增强系统(RAG)具有极高价值。当越来越多的 AI 产品试图绕过官方接口、直接抓取搜索页面时,Google 强化反爬机制既是保护自身核心资产,也是在重新划定数据使用的边界。
某种程度上,/goto 链接是搜索巨头对"谁有权大规模使用我的搜索数据"这一问题给出的技术性回答。它提醒整个行业:免费、开放地抓取搜索结果的时代正在收紧。
对开发者与工具生态的冲击
Hacker News 社区的激烈讨论反映了开发者群体的复杂心态。一方面,SEO 分析、排名追踪、竞品监控等合法业务高度依赖搜索结果数据;另一方面,Google 有充分理由防止其页面被无节制地采集。
这类反爬手段往往陷入"猫鼠游戏":平台加固,爬虫适配,平台再升级。/goto 链接不太可能成为终点,而更像是这场持久战中的又一回合。真正受影响最大的,往往是那些依赖轻量级抓取、缺乏资源持续对抗的中小型工具。
开发者应如何应对
对于受此影响的技术团队,可以考虑以下几个方向:
- 优先使用官方渠道:Google 提供的官方搜索 API 或 Programmable Search Engine 虽有配额与成本,但更稳定合规;
- 评估合规风险:大规模抓取搜索结果可能触及服务条款,需权衡法律与业务风险;
- 适配跳转逻辑:若确需解析,需要处理中转重定向,可能涉及执行 JS、跟踪 302 跳转等更复杂的流程;
- 关注生态动向:这类反爬机制变化频繁,建立对搜索页面结构变动的监控能力比一次性硬编码更重要。
结语:开放与封闭的再平衡
google.com/goto 看似只是一个不起眼的技术细节,却折射出搜索、数据与 AI 三者之间日益紧张的关系。当搜索结果成为 AI 训练与产品构建的"燃料",掌握入口的平台自然会收紧闸门。
对于依赖搜索数据的开发者而言,与其执着于对抗,不如提前思考数据获取的可持续路径。这场围绕数据的博弈,短期内不会有明确的赢家,但方向已然清晰:随手抓取的红利期,正在慢慢过去。
相关推荐

零基础用WorkBuddy做AI漫剧:技能包保姆级安装教程
零基础如何用WorkBuddy制作AI漫剧?本文详解WorkBuddy安装、Skill技能包导入与调用全流程,附剧本生成实操演示与人工修改技巧,帮你跑通AI漫剧从剧本到分镜的第一步。

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。

PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。