Google Gemini 4三连发:Hydrogen性价比逆袭与决策API
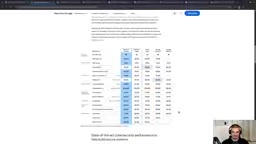
Google 以 Gemini 4 三档模型补齐产品线,轻量款 Hydrogen 在部分任务反超旗舰。
Google 短时间内接连发布 Gemini 4 Argon、Carbon、Hydrogen 三款前沿模型,形成从通用旗舰到轻量高性价比的完整梯度,其中 Carbon 与 Argon 的开发者 API 定价完全一致。官方基准之外,Arena 盲测显示 Anthropic 全家桶仍居前列,而同一推理档下 Hydrogen 的排名反超 Argon;作者自建基准则指出 Gemini 系列普遍「话痨」,Argon 回复长度几乎最啰嗦。在一次性提示词的 MOBA 小游戏实测中,Hydrogen 切到 X High 档后交出 Gemini 阵营最佳结果,甚至优于 Argon。此外,Google 推出支持音频模态的 Decisions API,在实时情绪与话题判断上形成差异化;视频模型 Omni 1.2 Flash 以低价补位短片段场景。
Google重回牌桌:Gemini 4 家族一口气补齐产品线
Google 最近的动作密度,让人很难再用「慢半拍」来形容它。据 YouTube 频道对近期发布的梳理,Google 在短时间内先后推出 Gemini 4 Argon、Gemini 4 Carbon,以及最新的 Gemini 4 Hydrogen,三款模型均被定位为前沿级别,在多数非 Anthropic 阵营的对比中占据上风。
这套组合的打法很清晰:Argon 对应 Opus 一类的通用旗舰,Carbon 承担更重的推理与复杂任务(类似 Fable 或 Astra 的定位),而 Hydrogen 则瞄准 Sonnet 甚至 Haiku 所处的轻量高性价比区间。说个细节,Carbon 与 Argon 在开发者 API 定价上完全一致——据视频中引用的价格信息,自 12 月 1 日起两者均为每百万输入 token 4 美元、每百万输出 token 20 美元。官方并未披露太多架构细节,只表示 Carbon 是在 Argon 基础上构建,因此两者是否为同一架构的不同推理配置,目前仍属推测。
基准之外的真相:Arena 榜单与「话痨指数」
官方 release notes 里的基准图,向来是「发布即领先」。视频作者提醒,这些数据看看就好——比如 Carbon 在自家图表里全面压过 Argon,而 Hydrogen 号称在多数基准上超过 Sonnet 与 GPT 6.1 Terra。
更有参考价值的是两类独立信号。
Arena 用户盲测:小模型反超大哥
在 Arena AI 这类用户不知情、纯靠体感打分的排行榜上,Anthropic 全家桶(Fable、Opus、Sonnet)依然占据 ELO 前列,Carbon 紧随其后。真正有意思的是:同一推理档位下,Hydrogen 的排名超过了 Argon。据视频作者的观察,在编码与 Web 开发这个细分榜上,这种「小模型打赢大模型」的现象尤其值得关注,因为该榜单往往最能反映模型的实际可用性。
Arena ELO 与盲测机制:Arena AI(通常指 LMArena,前身 Chatbot Arena)采用成对盲测的方式——用户在不知道模型身份的前提下对同一提示的两个回复投票,再用类似国际象棋的 Elo 评分系统累计排名。Elo 分数的本质是相对胜率:分差 100 分约对应 64% 的胜率。因此榜单反映的是「人类主观偏好」而非客观正确率,风格讨喜、格式清晰的模型容易获得虚高名次,而数学、代码等有唯一答案的任务则更适合用可验证基准衡量。这也解释了为何 Arena 排名与作者自建编码测试的结论会出现分歧。
自定义基准:Gemini 系列意外地「话痨」
作者用自建基准测试了模型的「yapping」程度——在没有 system prompt、纯裸 API 调用的条件下,统计口头禅、Markdown 格式化和回复长度。结果对 Gemini 不太友好:Argon 在回复长度上几乎是最啰嗦的模型,Carbon 也比 Opus 5 更长。口头禅维度上 Gemini 系列处于中游,不算最招人烦,但整体啰嗦程度排名靠前。作者的态度很直接:不喜欢话多的模型,而且通常 API 上话多,加了系统提示词也照样话多。
实测 MOBA 小游戏:Hydrogen X High 才是隐藏王牌
光看榜单不够,作者设计了一个一次性提示词的编码任务:用 Ursina 游戏引擎写一个 MOBA 概念验证,单角色带 Q/W/E/R 技能,要求「做得好看」,且不允许二次修 bug。
结果呈现出明显的分层:Fable 5.2 与 Opus 5.5 的产出动画流畅、观感精致,仍是第一梯队;Carbon 虽然加了小地图、视角更像 Dota,但模型本身像是几个多边形硬拼的;Argon 的表现则令人意外地差,场景混乱、难以辨认,作者甚至将其与 DeepSeek广告 的结果相提并论。
转折来自 Hydrogen。默认高推理档下,Hydrogen 的产出 bug 明显、几乎不可玩,是最差的一档;但切到 X High 推理后,它反而交出了 Gemini 阵营里最好的结果——Nexus、可用技能、平滑动画都齐了,只是角色造型仍然奇怪。作者还试了编排器模式(Argon 或 Carbon 做调度、Hydrogen 执行),其中 Carbon + Hydrogen 的组合效果接近 Hydrogen X High 单打。
这个结果指向一个反直觉的结论:在部分任务上,Hydrogen 的实际能力可能强于 Argon。而成本账本同样支持它——据视频给出的数据,Hydrogen 定价为每百万输入 150、输出 750(单位与前述一致),单看单价远低于 Argon,但完成整个任务的成本受推理档位影响,X High 档下单任务成本反而会超过 Argon 的常规档。作者自己的日常选择是:玩票性质的项目用 Hydrogen X High,只有任务极复杂时才切 Carbon;真正关键的工作仍然交给 Claude Fable 与 Opus。
推理档位与推理时计算(test-time compute):所谓 High、X High 等档位,指的是模型在生成答案前用于内部思考的 token 预算或采样次数。提高档位相当于在推理阶段投入更多算力,让模型多试、多检查,通常能显著改善多步任务的表现,代价是延迟与成本上升。这也解释了一个看似矛盾的现象:轻量模型在 X High 档下可能超过旗舰模型的默认档——因为前者把省下来的单价预算换成了更多思考步数。编排器模式(orchestrator)则是另一种思路:由强模型负责拆解任务和调度,小模型负责执行子步骤,用分工换取成本与质量的平衡。
Decisions API:音频输入才是差异化关键
Google 这次还推出了自家的决策模型 API。所谓决策模型,就是 Jeff 那类「系统一」模型:输出空间预先定义好,只做分类、二元判断或打分,响应极快。Gemini 决策模型的独特之处在于支持音频模态——这是 OpenAI 的对应产品做不到的,本地 Ollama 方案同样做不到。
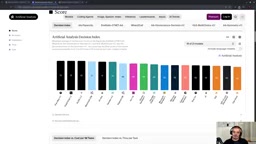
据 Artificial Analysis 的决策模型指数,Gemini Decision 1 的表现与 Jeff 基本持平,优于 GPT-6 Luna Decision 以及 Cloudflare 的 Clef 系列。
作者用同一套邮件分类任务横评了多个方案(本地运行的 Tef1 与 Nimble、Jeff 的托管 API、OpenAI 的 Decisions API 以及 Gemini):本地模型热启动后最快(约 1.2 秒),Jeff 约 2 秒,Gemini 约 3.4 秒,GPT 约 6.5 秒。速度不是 Gemini 的强项,音频才是。
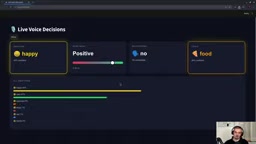
在演示应用里,作者边说边看模型实时输出:情绪、情感极性、是否在低语、话题分类。聊到披萨会识别为食物,发出特定声音能触发「悲伤」或「惊讶」,聊到某个话题时话题标签会跟着跳变。作者也坦承这套 demo 并不完美——提到「低语」时它判为是,但低语过程中也会时灵时不灵。真正有价值的是它打开的场景:对音频流做实时、低延迟的判断,这在过去需要先转写再推理,链路长得多。
决策模型(decision model)与「系统一」:这类模型不对自由文本做开放式生成,而是把输出空间预先限定为若干标签、布尔值或分数,本质上是一个高吞吐、低延迟的分类器。它与大语言模型的区别类似心理学中的「系统一」与「系统二」——前者快速直觉,后者慢速推理。工程上,决策模型通常基于小参数量模型微调,配合结构化输出(constrained decoding)保证结果必然落在合法集合内,因而能在毫秒到秒级返回。音频决策的关键难点在于端到端处理:传统链路要先做 ASR 转写再送入文本模型,会丢失语调、音量、语速等副语言信息,而原生音频输入可以保留这些信号用于情绪与意图判断。
Gemini Omni 1.2 Flash:便宜够用的短视频生成
最后一个发布是视频生成模型 Gemini Omni 1.2 Flash,可生成最长 15 秒的片段,带声音,720p 视频每秒定价七美分。作者用「沙滩上后空翻的狗」做了三次尝试,并追加了「腊肠犬」「空中吠叫」的提示:第一次狗只是在跳着接东西,第二次后空翻没做完,第三次勉强接近成功,音画基本对得上。作者自认对视频生成领域不算内行,结论也很克制——价格便宜,适合教育类等短片段场景,但稳定性还谈不上可靠。
综合来看,Google 这轮发布补齐了从旗舰到轻量的产品梯度,Hydrogen 在性价比与部分任务表现上甚至形成对 Argon 的内部竞争;Decisions API 的音频能力是真正拉开差距的一步;而 Omni 1.2 Flash 更像是低价补位。对开发者来说,选型逻辑正在变得微妙:不一定要用最贵的那一档。
背景补充
关于文中价格单位的说明:原文中 Argon 与 Carbon 的定价明确为「每百万输入 token 4 美元、每百万输出 token 20 美元」,而 Hydrogen 的「输入 150、输出 750」未标注币种与计量单位。按行业惯例推断,这更可能是每百万 token 的分数美元级别(即 0.15 美元与 0.75 美元),从而与「单价远低于 Argon」的表述一致;若按美元计则反而贵出数十倍,与上下文矛盾。阅读这类跨模型成本对比时,建议先统一「每百万 token」这一口径,并把推理档位带来的 token 消耗倍数一并计入,才能得到单任务真实成本。
相关推荐
Gemini Omni 1.2 Flash双榜第一:AI视频告别抽卡?
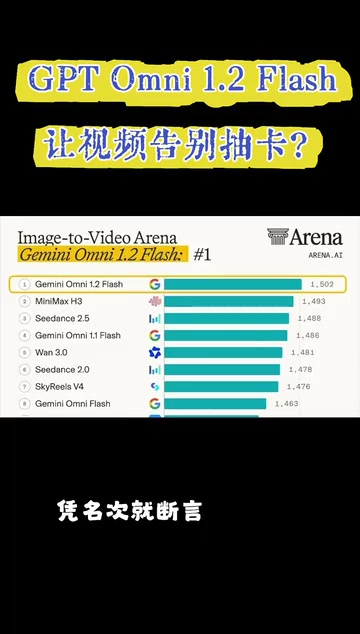
Google Gemini Omni 1.2 Flash 上线即登 Arena 文生视频、图生视频双榜第一。本文解析其15秒时长、逐轮可修改工作流、720p每秒0.07美元降价三成等升级,并指出快速运动、复杂物理等场景仍需改进,榜单名次不等于实际创作体验。
Design Extract:提取网站设计风格,让Claude Code照着写页面
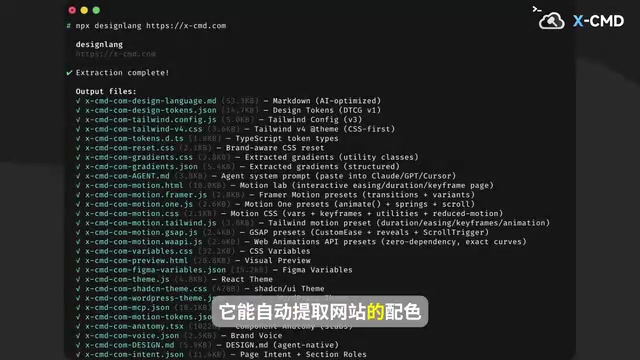
Design Extract 是一款网站设计风格提取工具,能自动提取配色、字体、布局和动画,生成 Tailwind CSS 配置、Shadcn UI 主题和 Figma 变量,并通过 MCP 让 Claude Code 等 AI 编程工具按参考网站风格写页面。
深潜六鳃鲨与泰坦尼克号数字孪生:深海探索如何改写科学
国家地理深海团队在亚速尔群岛首次从潜水器标记六鳃鲨并记录其捕食行为,同时泰坦尼克号用70万张扫描图像建成数字孪生,揭示冰山损伤与断裂真相。