Google Genie 4世界模型发布:更真实、可实时编辑

Google发布Genie 4世界模型,主打更真实生成、自然语言实时编辑、音频与Gemini 3.8 Flash底座。
Google发布Genie 4世界模型,用于AI生成可交互体验,带来四项更新:更真实的世界生成、自然语言实时编辑、音频生成能力,以及基于Gemini 3.8 Flash构建。文章指出,其中实时编辑最具变革性——它将传统“生成—预览—重新生成”的离散流程压缩为连续交互,用户可在世界运行中用一句话即时修改场景,更贴近真实的调试与玩法设计过程。音频补全了多模态沉浸感,Gemini 3.8 Flash的低延迟则支撑实时交互需求。文章认为,世界模型的竞争焦点正从生成质量转向可控性与实时性,Google押注的“交互式生成”形态将世界模型从内容工具变为创作环境本身。
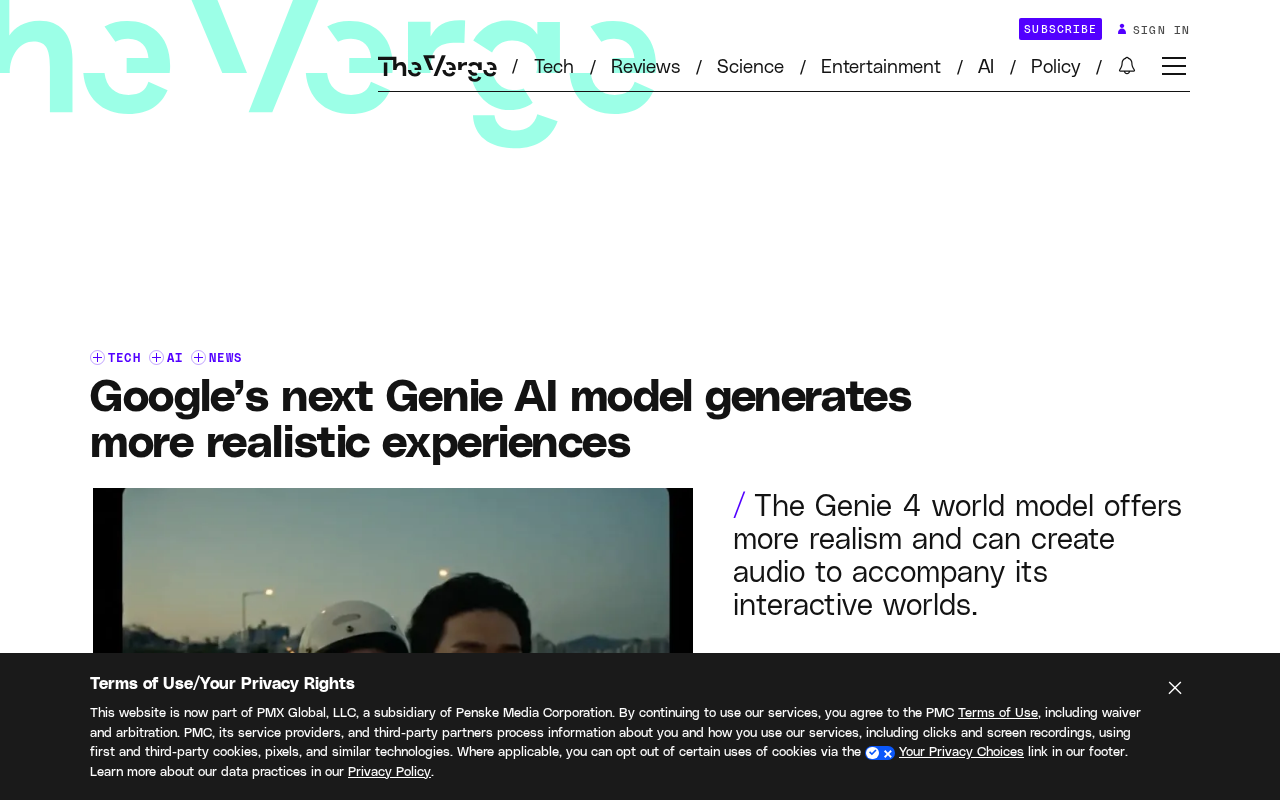
Google 今日发布了其 Genie 4 世界模型,用于通过 AI 生成交互式体验。据官方介绍,该模型带来四项主要更新:生成更真实的世界、允许用户通过自然语言提示实时更新体验、能够生成音频,并在底层使用 Gemini 3.8 Flash 提供支持。
四项核心升级:从“生成”走向“可编辑的交互世界”
Genie 系列一直定位于“世界模型”——不只是生成一段视频或一张图,而是生成用户可以交互、探索的动态环境。Genie 4 的更新延续了这一方向,但重点从“能不能生成”转向“生成得有多真、多可控”。
官方列出的四项更新中,最直观的是更真实的世界生成。这意味着模型在物理一致性、场景细节和动态表现上有所提升,让生成的交互体验更接近真实世界的观感。对于游戏原型、模拟训练、内容创作等场景,真实感直接决定了生成内容能否被实际使用。
第二项更新是自然语言实时编辑。用户可以在体验运行过程中,用一句话提示就能更新当前世界,而不需要重新生成整个场景。这改变了传统“生成—预览—重新生成”的线性流程,把编辑能力嵌入到交互过程本身。
第三项是音频生成能力。此前世界模型多聚焦于视觉层面,音频的加入让生成的体验从“可看可交互”扩展到“可听”,对于沉浸感和场景完整度的补全意义明显。
第四项则涉及底层架构:Genie 4 基于 Gemini 3.8 Flash 构建。这说明 Google 正在将其世界模型能力与自家的 Gemini 模型体系打通,借助 Gemini 的多模态理解与生成能力来支撑更复杂的交互式生成任务。
世界模型(World Model)这一概念源自强化学习与认知科学,指的是智能体对环境动态的内部表征——它能根据当前状态和动作预测下一状态,从而支持规划与决策。近年来,这一术语被生成式AI领域借用,指代能够生成可交互、可探索三维动态环境的模型,代表性工作包括Google DeepMind的Genie系列、OpenAI的Sora(部分被视为世界模拟器雏形)以及各类可玩视频生成研究。与普通视频生成模型不同,世界模型强调动作条件性(action-conditioned)与长时一致性:用户的每个操作都应引发环境合理且连贯的变化,而非播放一段预设画面。这一区别决定了世界模型在游戏原型、机器人仿真、具身智能训练等场景中的潜在价值。
实时编辑为何是关键一步
在四项更新中,自然语言实时更新体验最值得关注。它改变的不只是操作方式,而是创作范式。
传统生成式内容的流程是离散的:输入提示、等待生成、查看结果、不满意则调整提示重新生成。每一步之间都有等待和试错成本。实时编辑把这一过程压缩为连续的交互——用户看到什么,就能直接描述想改什么,模型即时响应。
这种能力对交互式体验的意义尤其大。世界模型生成的环境本质上是动态的、持续运行的,如果编辑只能在生成前进行,那么运行中的场景一旦偏离预期就只能推倒重来。实时编辑让“边运行边调整”成为可能,更接近真实的内容调试和玩法设计过程。
扩散模型与自回归生成模型的实时性瓶颈是理解“实时编辑”难点的背景。主流图像/视频生成多基于扩散过程,需多次迭代去噪,单次生成往往耗时数秒至数十秒;即便采用蒸馏加速,连续交互场景下的低延迟仍是挑战。此外,视频生成还需维持时序一致性——帧与帧之间不能出现闪烁或物体“漂移”。当用户用自然语言在运行中修改世界时,模型必须在保持既有场景上下文的同时局部响应修改指令,这涉及条件生成、增量更新与缓存复用等技术。Gemini 3.8 Flash中“Flash”后缀通常意味着针对推理速度优化的轻量版本,其低延迟特性正是支撑实时编辑与交互式生成的前提。
音频与底层模型:补全体验的两个维度
音频生成看似是功能补充,实则是沉浸感拼图中缺失的一块。视觉上的真实感再高,没有匹配的声音环境,交互体验仍会显得单薄。Genie 4 加入音频生成,意味着模型输出的不再只是画面,而是包含声音的完整场景。
底层采用 Gemini 3.8 Flash 则透露出 Google 的产品策略:世界模型不是孤立的技术演示,而是嵌入 Gemini 生态的能力模块。Flash 系列通常主打效率与响应速度,这与实时编辑、交互式生成对延迟的敏感需求相吻合。
多模态生成中的音视频对齐是此处值得了解的背景。为动态场景生成匹配音频,远不止“配一段背景音”:模型需要理解画面中的事件(如脚步、碰撞、环境风声)并生成时间上同步的声音,这在技术上称为音视频同步生成(audio-video joint generation)。近年来的研究开始将音频作为与视频并列的输出模态联合建模,使声音随画面事件实时触发。对交互式世界模型而言,音频还需响应用户操作——例如开门声应随交互即时出现。这要求音频生成具备与视觉生成相当的实时性与条件响应能力,也解释了为何底层模型的速度优势对音频功能同样关键。
世界模型的竞争焦点正在转移
Genie 4 的更新方向反映出一个行业趋势:世界模型的竞争正在从“生成质量”转向“可控性与实时性”。生成一段逼真的场景已经不够,能否在运行中理解并执行用户的修改意图、能否输出多模态的完整体验,正在成为新的分水岭。
Google 将自然语言实时编辑作为核心卖点,实际上是在押注“交互式生成”这一形态。当用户可以用对话的方式持续塑造一个动态世界,世界模型就从内容生产工具变成了创作环境本身。这一方向能否落地为广泛可用的产品体验,还要看实际生成质量与响应速度的表现,但方向本身已经清晰。
相关推荐
Cursor AI实战:用AI IDE加速编程的效率与成本权衡
深入解析 Cursor AI IDE 的界面布局、Agent/Plan/Debug/Ask 四种模式、模型选择与 Git 上下文集成,并结合实操演示讨论其订阅成本与直连 Claude 的性价比权衡。
免费落地页设计规则库:Claude Code与Cursor实测指南
Claude Code 与 Cursor 可用的免费落地页设计技能 Landing Page Design 介绍:MIT 协议、近 9000 星,先问 offer/受众/行动再规划 12 区块,字体与间距均为硬约束,配套 Redesign 技能改造存量页面,附动效技能下架与星数不代表质量的提醒。
Cursor总写错代码?问题可能出在上下文而非提示词
Cursor反复写错代码,问题可能不在提示词而在上下文。本文解析如何通过补充相关文件、完整报错与预期结果,配合先计划、小步改、跑测试的流程,减少AI编程错误,同时提醒代码审查仍是开发者的责任。