Google Research 推出 Harness2:递归智能体框架引关注

Google Research 发布 Harness2,探索智能体控制框架的递归嵌套。
Google Research 发布名为 Harness2 的新项目,核心概念是「递归智能体挂载」,即让智能体系统在运行时嵌套调用自身的控制框架(harness)。文章指出,当前主流 Agent 框架多为单层控制结构,当任务需要子智能体时,便面临上下文继承、权限边界与错误回溯等问题,递归 harness 试图系统性地回应这些挑战。不过该项目公开信息极为有限,仅有一条 Hacker News 链接且零评论,无法确认其形态是论文、代码库还是技术博客,因此分析多基于命名与领域常识推断。文章认为,若设计成熟,递归架构可能简化任务树型应用,并推动 LangChain、AutoGen 等框架从扁平编排转向分层控制,但递归深度控制与可观测性仍是落地难点。
Google Research 推出 Harness2:递归智能体框架引关注
什么是 Harness2?
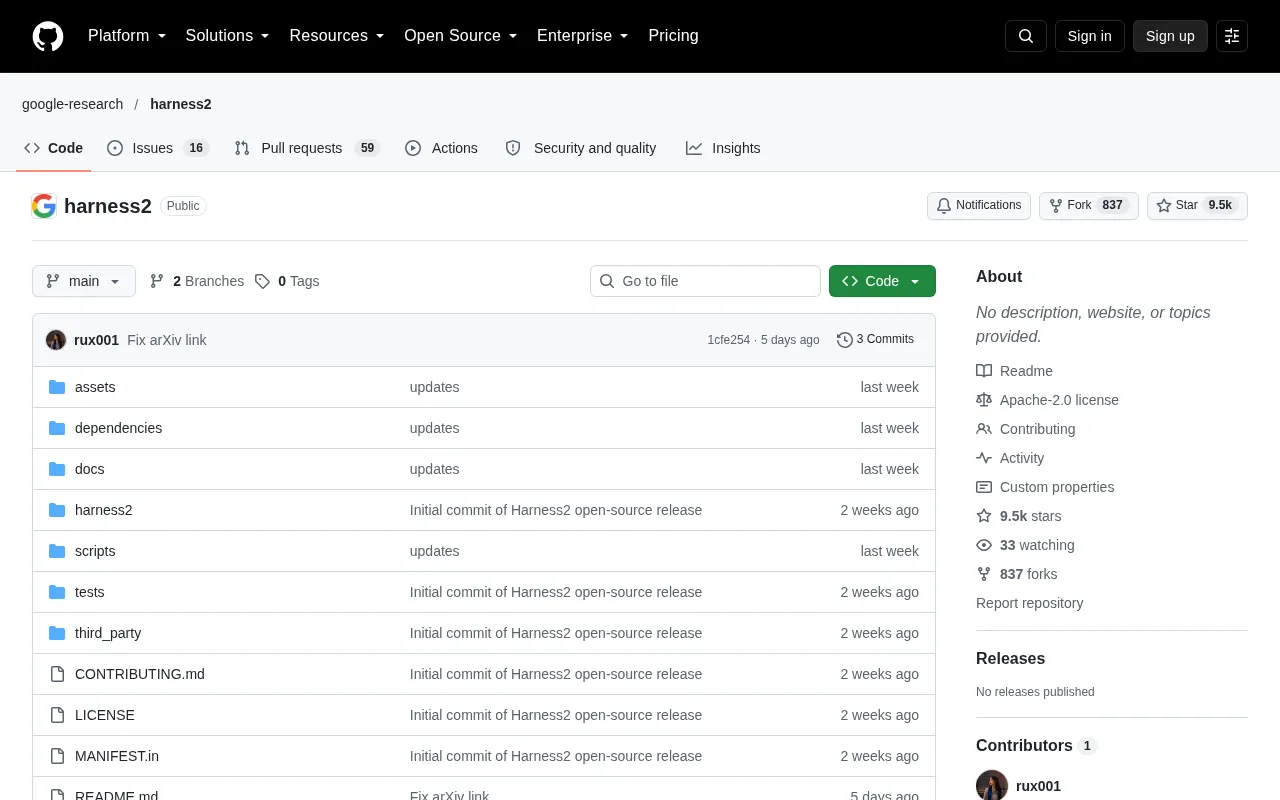
Google Research 近日发布了名为 Harness2 的新项目,其核心概念是「递归智能体挂载」(Recursive Agent Harnessing)。该消息在 Hacker News 上出现后,虽然初始讨论量不大(5 分、0 条评论),但「递归」与「智能体」的组合仍然值得关注——这两个词在当下 AI 工程语境中各自都承载着大量未解的难题。
Harness 一词在 AI 系统语境中通常指代围绕模型构建的外围控制框架:包括工具调用、状态管理、错误恢复以及多轮任务的编排逻辑。而 Harness2 将这个框架本身推向了「递归」的维度,暗示其设计触及了智能体系统如何调用、嵌套乃至改进自身 harness 的层次问题。
Harness(挂载/控制框架) 在 LLM 与智能体工程中,指模型之外的一层软件基础设施,负责把「一次模型调用」组织成「可完成任务的系统」。典型职责包括:
- 工具调用:把函数、API、检索器暴露给模型,并解析其调用意图;
- 状态管理:维护对话历史、中间结果与任务进度;
- 错误恢复:捕获解析失败、工具异常并重试或降级;
- 编排循环:决定何时继续、何时终止、何时交由人工。
常见实现如 ReAct 循环、OpenAI 的 function calling 封装、LangChain 的 AgentExecutor 都属于 harness 范畴。它的质量往往比换用更强的基座模型更能决定智能体的实际可靠性,因此「递归地挂载 harness」意味着让这套控制层自身具备层次化结构,而非仅是提示词技巧。
递归智能体:为什么这个方向重要
智能体系统的「套娃」难题
当前主流的 Agent 框架大多采用单层控制结构:一个调度器负责规划、调用工具、观察结果并继续下一轮。但当任务复杂度上升到需要「子智能体」时,问题就出现了。子智能体如何继承父级的上下文?它该拥有多大的自主权?出错时责任如何回溯?
递归智能体挂载试图系统性地回答这些问题。从命名可以推断,Harness2 关注的不是单个 agent 的能力提升,而是 agent 与 harness 之间形成嵌套关系后的整体行为。这类设计在理论上能够让系统在处理分层任务时更加自然——例如一个负责写代码的 agent 可以递归地委托子任务给更专门的 harness,而不必把所有逻辑塞进一个扁平的提示词循环里。
子智能体(sub-agent) 指由主智能体在运行过程中动态创建或调用的下级智能体,用于把复杂任务分解为更窄职责的子任务,例如「检索子智能体」「代码审查子智能体」。与普通工具调用不同,子智能体本身拥有自己的规划循环与上下文,因此会带来几个工程问题:
- 上下文继承:子智能体应接收父级的完整对话,还是仅接收提炼后的任务说明?前者成本高,后者易丢失约束;
- 权限边界:子智能体可调用的工具集是否需要收窄,以避免越权操作;
- 结果回溯:子智能体失败时,错误信息如何向上传播并被父级消化。
主流框架如 AutoGen 的 GroupChat、CrewAI 的层级流程都在不同程度上处理这些问题,但多数仍是固定层级,而非运行时递归生成。
与现有范式的差异
递归结构在传统软件工程中并不新鲜,但在 Agent 语境下,它引入了几个特有挑战:状态在递归层级间的传递成本、终止条件的判定、以及递归深度失控时的风险控制。Harness2 的具体实现细节目前公开信息有限,但从 Google Research 的发布渠道来看,这更可能是一个研究性质的原型或概念框架,而非即用型产品。
提一嘴,仅凭 Hacker News 上的一条链接,无法确认 Harness2 是论文、开源代码库还是技术博客。这个信息缺口意味着本文的分析更多基于命名与领域常识的推断。
递归深度控制 是递归式智能体架构必须直面的工程约束。在传统递归函数中,深度由调用栈与显式计数器管理;而在智能体场景下,每一层递归都意味着一次或多次额外的模型调用,成本与延迟随深度呈乘法式增长。若终止条件设计不当,可能出现子智能体不断派生新子任务、迟迟不收敛的情况,即所谓的「递归失控」。常见缓解手段包括:设置最大深度与最大总调用预算、要求子任务必须比父任务更具体、在每层引入独立的验证器判断是否已可交付结果。可观测性同样关键——需要把嵌套调用链以树状 trace 形式记录,否则调试几乎无从下手。
对开发者的潜在意义
对于正在构建 Agent 系统的团队而言,Harness2 值得关注的地方在于它可能提供的抽象模式。如果递归 harness 的设计足够清晰,它有望简化那些「任务树」型应用的实现——比如自动化研究助手、多阶段代码生成流水线,或者需要逐层分解的复杂数据分析流程。
另一个值得留意的信号是 Google Research 对这一方向的投入。递归 agent 架构如果被证明有效,可能会影响后续框架(如 LangChain、AutoGen 等生态)的设计取向,促使它们从扁平编排走向分层控制。
待观察的问题
公开信息不足是目前最大的障碍。Harness2 的实际能力、评估方式以及与 Google 其他 Agent 工作的关系都尚未明确。Hacker News 上零评论的状态也说明社区尚未形成有效讨论。
对于想要跟进这一项目的读者,建议直接关注 Google Research 的官方发布渠道,并留意是否有配套论文或代码仓库放出。递归智能体的概念虽吸引人,但工程落地中的递归深度控制、调试可观测性等问题,仍需要具体的实现细节来验证。