Google Scholar引用更新为何总是滞后?学者必知的真相

Google Scholar引用滞后数月属正常机制,早期研究者无需焦虑,应交叉使用多平台核查。
本文针对「arXiv可见引用却未反映在Google Scholar计数中」这一新晋研究者常见困惑,系统解释了背后的工作机制。Google Scholar依靠爬虫定期抓取而非实时更新,引用关系的解析涉及元数据匹配、PDF解析和版本合并等多个环节,任一环节的偏差都可能造成延迟。NeurIPS等会议论文从arXiv预印本到正式版本的转变,还会导致引用数暂时分散在多个记录中。根据学术社区经验,三到六个月的更新延迟属于正常范围。文章建议研究者交叉使用Semantic Scholar、Scopus等多平台核查,主动维护个人学术档案,并将精力聚焦于持续产出有价值的研究,而非频繁刷新引用数字。
一个困扰新晋研究者的常见疑问
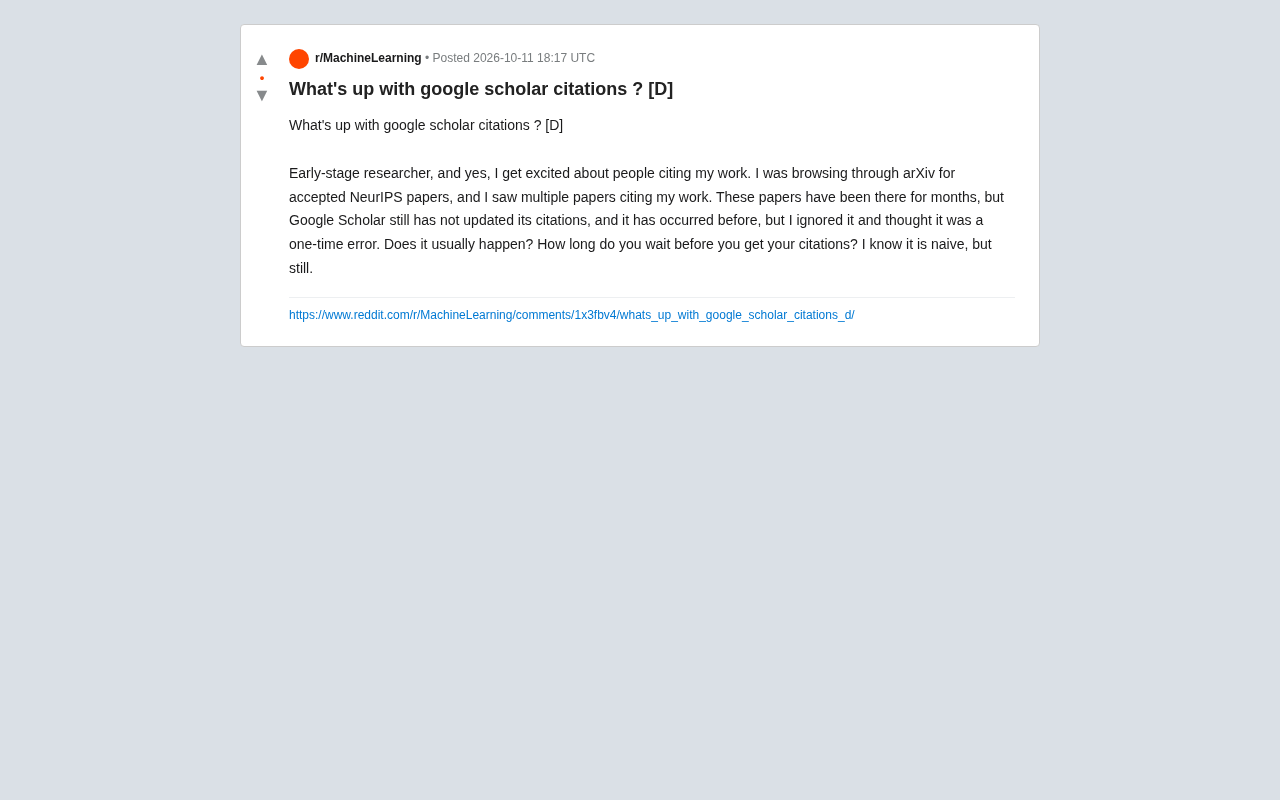
对于刚进入学术界的研究者来说,看到自己的论文被引用是一件振奋人心的事。然而,一个在Reddit机器学习社区引发讨论的问题道出了许多人的困惑:明明在arXiv上能看到多篇已被NeurIPS接收的论文引用了自己的工作,而且这些论文已经挂了好几个月,但Google Scholar上的引用数却迟迟没有更新。
这位早期研究者坦言,这种情况此前也发生过,当时他以为只是偶发错误便没在意,但当问题反复出现时,他开始怀疑这是否是Google Scholar的常态。这个问题看似琐碎,却折射出学术计量工具背后的运行机制,值得深入探讨。
Google Scholar的索引机制与滞后原因
Google Scholar并非实时更新的数据库。它依靠网络爬虫定期抓取学术网站、出版商页面、机构仓储以及arXiv等预印本平台的内容,再通过算法解析参考文献、匹配引用关系。这一流程决定了引用计数天然存在延迟。
为什么arXiv上能看到引用,Scholar却没收录?
arXiv上的论文虽然公开可见,但Google Scholar对预印本的引用解析存在时间差。爬虫需要先抓取到施引论文,再准确识别其参考文献列表中的条目,并将其与被引论文的记录关联起来。这个解析过程并不总是即时完成,尤其当论文的元数据格式不规范、PDF解析出错或存在多个版本时,引用关系可能被延迟识别甚至遗漏。
版本更替带来的混乱
NeurIPS等会议论文往往经历从arXiv预印本到正式会议版本的转变。当同一篇论文存在多个版本时,Google Scholar可能将引用分散计入不同的记录条目,导致主记录的引用数看起来偏低。等到系统完成版本合并后,引用数才会"突然"跳升。
DOI(数字对象标识符)是解决版本混乱问题的重要机制。正式发表的会议论文和期刊文章通常会被赋予唯一的DOI,使不同数据库能够精确识别和关联同一篇论文的不同版本。然而arXiv预印本使用独立的arXiv ID体系,与正式出版版本的DOI并不自动关联。Google Scholar依靠标题、作者名、摘要相似度等启发式算法进行版本合并,准确率有限。当论文标题在投稿过程中被修改、或作者名字的拼写格式不一致时,系统可能无法识别两个条目属于同一作品,导致引用数永久分散在不同记录中。这也是建议研究者主动维护个人主页、手动合并重复条目的根本原因。
引用更新通常需要多久?
根据学术社区的普遍经验,Google Scholar的引用更新周期并不固定,从几周到几个月不等。一些研究者反馈,会议论文正式发表后,引用数的集中更新可能滞后三到六个月。影响更新速度的因素包括:
- 施引论文的发布渠道:正式出版商页面通常比预印本更快被收录
- 元数据质量:标题、作者、DOI等信息越规范,匹配越准确
- 爬虫抓取频率:热门期刊和会议的抓取优先级可能更高
- 引用格式的一致性:非标准的引用写法容易被漏算
因此,看到arXiv上有人引用却未反映在Scholar计数中,在数月的时间窗口内属于正常现象,不必过度焦虑。
研究者应该如何理性看待引用数据
不要依赖单一计量工具
Google Scholar的覆盖面广但精度有限,而Scopus、Web of Science、Semantic Scholar等平台各有侧重。交叉比对多个来源,能更全面地掌握论文的真实影响力。Semantic Scholar尤其在计算机科学领域对arXiv预印本的引用追踪较为敏捷,可作为补充参考。
Semantic Scholar由艾伦人工智能研究所(Allen Institute for AI)开发,专门针对计算机科学和生物医学等领域进行深度优化。它不仅追踪引用关系,还提供「高影响力引用」(Highly Influential Citations)的识别功能,能区分论文被引用是作为核心方法、还是仅作背景参考,信息粒度比单纯的引用计数更丰富。Scopus和Web of Science则以正式出版的期刊论文为主要收录范围,对于尚未正式出版的会议预印本覆盖相对有限,但其数据审核更为严格,常被用于机构评估和基金申请中的引用核查。了解不同工具的数据来源与侧重,能帮助研究者在不同使用场景下选择最合适的参考依据。
主动维护个人学术档案
认领并完善Google Scholar个人主页,确保论文记录准确、版本正确合并,有助于系统更准确地归集引用。定期检查是否存在重复条目或归属错误的记录,并及时手动合并。
把注意力放回研究本身
引用数的增长本质上滞后于学术贡献的产生。与其频繁刷新计数,不如将精力投入到后续研究和与同行的交流中。被NeurIPS论文引用,本身已经说明工作获得了领域内的认可,这比一个尚未更新的数字更有意义。
结语
Google Scholar引用滞后是其工作机制的固有特性,而非系统故障。对早期研究者而言,理解这一点能缓解不必要的焦虑。引用数迟早会补上,真正重要的是持续产出有价值的研究。学术影响力的构建是一场长跑,而非对实时数字的追逐。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。