Google开源EmbeddingGemma2:文字与图片同处一个向量空间

Google开源多模态EmbeddingGemma2,可将文字和图片映射到同一768维向量空间,实现自然语言直接搜索照片。
EmbeddingGemma2是Google最新开源的多模态Embedding模型,能将文字、图片、音频和视频统一转换为768维向量,使一句话可以直接与图片做相似度比较,实现自然语言图片搜索。实验显示,在300张无任何标签的动物照片中,输入「会飞的动物」即可准确召回蝙蝠图片。工程实践中有三个关键要点:一是照片向量应提前计算存储,搜索时仅需将查询文字Embed后做点积排序;二是跨模态分数整体偏低(通常在0.6-0.76之间),不应设固定门槛过滤,看排名即可;三是模型支持基于Matryoshka表示学习的向量截断,压缩到256维仍保留约95%的搜索质量,但截断后必须重新归一化,实际可用维度需结合自身数据测试。
一个没有标签的照片搜索实验
B站UP主Steven用一组有趣的实验开场:300张来自公开数据集Animals with Attributes 2的动物照片,没有任何文字标签、文件名或分类信息。在搜索框里输入「会飞的动物」,排在最前面的9张全是蝙蝠,有的在飞、有的倒挂在树上。继续输入「黑白色的动物」,结果出现了斑马、熊猫和一只身上有黑点的豹。
关键在于,这些照片本身并不携带颜色信息,模型是直接「看」照片的内容判断出来的。这正是Google最新开源的多模态Embedding模型——EmbeddingGemma2——的能力所在。
文字和图片放进同一个空间
Embedding模型的基本逻辑是:把一句话变成一串数字,意思接近的两句话,它们对应的向量方向也接近。EmbeddingGemma2在此基础上做了扩展——它不只读文字,还能看图片,并支持音频和视频,把这些不同模态的内容都转换成768个数字。
文字和图片各有自己的Encoder,但输出的都是同一个空间里的768维向量。这意味着一句话可以直接和一张图片做比较。Steven用五种动物(老虎、熊猫、长颈鹿、海豚、大象)各10张照片做了可视化:把768维压缩成2D后,每种动物各自聚成一堆;再把三句文字放进去,每句最接近的三张照片都指向正确的动物。
不过他特别提醒,2D地图只是示意图,真正的距离计算必须用完整的768维向量。
Embedding模型将内容转换为高维向量的技术,其核心是让语义相似的内容在数学空间中距离也相近。EmbeddingGemma2采用的多模态架构属于「双塔模型」(Dual Encoder)的变体:文字通过语言Encoder处理,图片通过视觉Encoder(通常基于ViT,即Vision Transformer)处理,两条通道各自独立编码后,输出到同一个共享的向量空间。这种对齐能力来自对比学习训练——训练时让「配对」的文字和图片向量尽量靠近,让「不配对」的尽量远离。OpenAI的CLIP模型是这类方法的早期代表,EmbeddingGemma2则是基于Gemma 2语言模型架构、经过多模态对比训练后的最新版本。768维的输出维度是一个工程权衡:维度越高表达能力越强,但存储和计算成本也越高;768维是目前业界在精度与效率之间常见的折中选择。
实际搜索:分数为什么这么奇怪
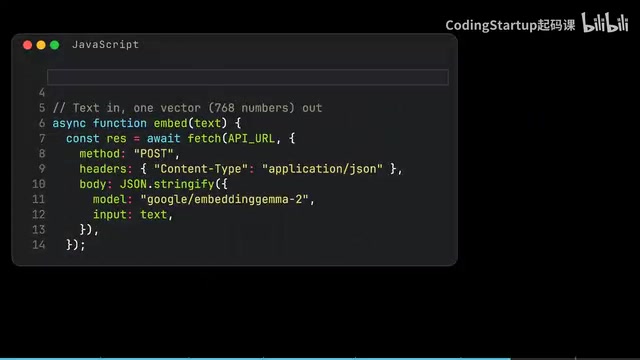
Steven把EmbeddingGemma2部署在自己的DGX Spark上,它提供与OpenAI格式兼容的API。流程并不复杂:300张照片的向量提前算好存在JSON里(每一项只有照片位置和768维向量,没有任何文字说明),搜索时只需把输入文字Embed成query向量,再和每张照片的向量做点积(Dot Product)。
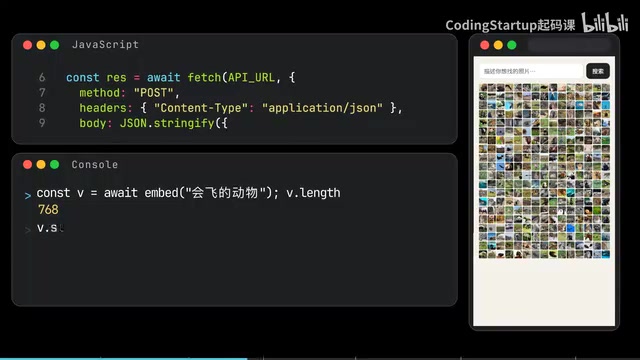
由于向量长度被归一化为1,点积就等于余弦相似度。然而运行「会飞的动物」时,一个反直觉的现象出现了:如果设定分数门槛大于0.8,结果一张照片都显示不出来。
把300张照片的分数排在一条轴上看,最高的一张蝙蝠只有0.756,全部照片挤在0.6到0.76之间。相比之下,两张蝙蝠照片之间的相似度高达0.951,甚至一张蝙蝠和一张海豚也有0.781,比「正确文字对正确照片」的分数还高。
跨模态分数普遍偏低的根源
原因在于:文字和图片虽然共享同一个向量空间,但它们各自聚集在不同的区域。所以文字对图片的分数会整体偏低。这给出一个重要的实践启示——不要用固定的数字门槛来过滤跨模态检索结果,看排名就行。去掉门槛后对分数从高到低排序取前十,前九张依然全是蝙蝠;搜「在水里游泳的动物」则返回河狸、河马、海豚和一只泡在水里的灰熊,排序完全正确。
这种文字向量与图片向量在共享空间中仍然「分区聚集」的现象,在多模态检索领域称为「模态间隙」(Modality Gap)。即使经过对比学习对齐,不同模态的向量在高维空间中仍倾向于占据不同的锥形区域,而非完全混合分布。这一现象在2022年的研究论文《Mind the Gap》中被系统分析,其成因与Encoder结构差异、训练数据分布以及高维空间的几何特性都有关联。实践中的处理方式除了「只看排名」之外,还可以对同一模态内的分数做归一化(Per-query normalization),或专门为跨模态检索训练一个轻量的重排序模型(Reranker)来校正分数分布。
把向量切短,省三倍空间
EmbeddingGemma2一个值得关注的特性是支持向量截断。每张照片768个数字,若每个数字用4字节存储,100万张照片约需3GB。而该模型在训练时会把最重要的信息放在向量的最前面(这正是Matryoshka表示学习的思路),因此可以只保留前256个甚至前128个数字。Google表示,用256维搜索仍能保留约95%的质量。
实现上只需一个shorten函数用slice取前n个数字。但要注意:切短之后向量长度不再是1——前256维的长度只有约0.709,因此必须把每个数字除以长度重新归一化。query和所有照片向量都切到256维后,数据量缩小三倍(100万张从3GB降到约1GB),前9张结果与768维完全一致。
继续切到128维时,松鼠、狐狸和河马挤了进来,蝙蝠只剩7张。Steven给出的建议很务实:切到多短,要用你自己的数据去试,没有放之四海而皆准的答案。
Matryoshka表示学习(Matryoshka Representation Learning,MRL)得名于俄罗斯套娃,其核心思想是在训练时同时优化多个维度子集的表现,迫使模型把最具区分度的信息优先编码到向量的最前几个维度。传统Embedding模型若只截取前256维,质量往往大幅下降,因为重要信息均匀分散在所有维度中。MRL训练则通过多尺度损失函数解决了这个问题,使得前128维、前256维、前512维各自都能作为完整可用的向量独立使用。这一特性对生产环境非常实用:可以先用短向量做粗筛,再用完整768维对候选结果重排序,在精度与速度之间灵活取舍。Google在text-embedding-004等模型中也采用了这一技术,EmbeddingGemma2将其延伸到了多模态场景。
小结
EmbeddingGemma2把文字和图片转换成同一个空间的768维向量,让一句话可以直接检索照片。工程实践上有三个要点:照片向量提前算好、搜索时只需Embed查询文字再做点积排序;跨模态分数普遍偏低,应看排名而非固定门槛;想省空间可截断向量,但切完必须重新归一化。对于需要构建图文检索、以图搜图或自然语言搜图的应用场景,这是一个值得上手实验的开源工具。
相关推荐

Codex入门指南:OpenAI编程智能体与ChatGPT有何不同
Codex是OpenAI推出的AI编程智能体,能自主阅读、修改代码并执行测试。本文解析Codex与ChatGPT的核心区别,以及开发者为什么要学习这类AI编程工具。

Gemini Agent发布:Argon模型太强不敢放出,AI圈新动态盘点
Google发布办公通用智能体Gemini Agent,支持Gemini 4 Argon与Claude Opus 5.5,但Argon因太强暂不开放。本文盘点Odyssey 3世界模型、OpenAI营收、Arena融资等一周AI圈动态。

Sophos借OpenAI Daybreak把威胁响应时间压缩96%
Sophos首席技术官披露,借助OpenAI Daybreak项目和自研安全智能体,其MDR业务平均威胁响应时间从38分钟压缩至89秒,降幅达96%。本文解析其规划-执行-观察闭环架构及AI护栏松绑的意义。