Google推出Gemini 3.8 TTS:从预设声音到全自定义语音工作室
Google推出Gemini 3.8 Flash TTS两款模型,将语音生成从预设音色升级为可自然语言编程、逐行导演的完整创作管线。
Google为Gemini家族新增Gemini 3.8 Flash TTS与Flash-Lite TTS两款文本转语音模型,前者聚焦深度创意导演与角色设计,后者针对高吞吐低成本的规模化场景。两款模型的核心突破在于:以自然语言提示替代固定预设,支持在100多种语言和方言中自由设计音色;提供2000+现成声音库与30秒即可完成的声音复刻;并允许开发者通过舞台指示、非语言提示(笑声、叹气)及背景应答标记对每句话进行逐行导演,实现真正意义上的"表演"而非"念稿"。在Hume AI Voice Design Benchmark上,Flash TTS以71.4分位列第一。安全层面,系统内置同意验证、SynthID水印与C2PA凭证三重机制,应对声音克隆带来的合规压力。两款模型已向开发者开放,并将逐步集成到Gemini Notebook、Google Vids等消费级产品中。
Google为Gemini家族新增两款文本转语音(TTS)模型——Gemini 3.8 Flash TTS 与 Gemini 3.8 Flash-Lite TTS,将语音生成从固定预设的时代,推向一个可以自由设计、精细导演的创作工作室。这不仅是音色数量的堆叠,而是把"声音"从静态资源转变为可编程的创意素材。
两款模型,两条产品路线
新发布的两款模型定位清晰,覆盖了从高端创作到规模化部署的完整链条。
Gemini 3.8 Flash TTS 面向深度创意导演与角色设计。开发者可以用自然语言从零构建全新声音,为游戏、沉浸式有声书、播客和互动媒体塑造角色,并逐行控制表演——包括表演提示、节奏、方言切换乃至"背景应答"(backchanneling)等对话细节。
Gemini 3.8 Flash-Lite TTS 则为高吞吐、低成本的规模化场景优化,适合大批量配音、音频内容生产以及富有表现力的语音代理,同样支持对语气、节奏和表达细微差别的精细控制。
两款模型加入了快速扩张的 Gemini Audio 家族,此前该系列已推出 3.5 Live Translate、3.5 Transcribe,以及 3.8 Live 和 3.8 Live Extended Thinking 等能力。
从30种预设到无限声音库
过去TTS产品往往只提供有限的预设音色,这次Google将思路彻底反转——从30种原始声音扩展到一个理论上无限的声音库。
生成式语音设计是最核心的变化。通过自然语言提示,用户可以在100多种语言和方言范围内自定义角色、口音和音色特征。官方演示中,模型可以生成来自墨尔本的高能量DJ嗓音、超薄单调的机器人声音,甚至为一条日本龙赋予声音。
声音库方面提供2000多个可用于生产的现成声音,覆盖墨西哥西班牙语、魁北克法语、苏格兰英语等区域变体。
声音复刻功能允许用户仅凭30秒音频样本,重建一致的声音档案——前提是拥有该声音的使用权,并配有内置的同意验证、SynthID水印和C2PA凭证保护。此外还有"保存与扩展"功能确保长期项目中的音色一致性,以及即将上线的"声音混音",可通过提示词微调音色、音高、语速和口音(例如"加入轻微美国南部口音")。
逐行导演:把脚本变成表演
真正把这套系统与传统TTS拉开距离的,是对表演的精细控制能力。两款模型都允许用户"逐行导演"每句话的呈现方式。
用户既可以自己写"舞台指示",也可以让Gemini根据脚本线索自动把控演绎,从平静的客服语气到低声的悬疑场景都能覆盖。长文本生成能在数小时连续音频中保持音质、节奏和角色音色的稳定,说话人漂移极小,非常契合播客和有声书。
原生双人对话编排支持从单一脚本生成多轮对话,保持两个声音清晰区分并实现自然轮流交谈。更有意思的是脚本化语气爆发与背景应答——通过 <laughs>、<sigh>、<gasp> 等非语言提示,以及 |mhm|、|yeah| 这类主动倾听式插话,为对话增添真实质感和喜剧节奏。
这些能力意味着音频创作正从"念稿"进化到"表演",让AI语音第一次具备了导演层面的可控性。
**背景应答(Backchanneling)**是对话语言学中的专业术语,指听话者在对方说话过程中发出的短促回应——如"嗯""对""是啊"——以表示自己在积极倾听,同时不打断对方的发言节奏。这些信号在真实人类对话中高度频繁,是判断对话是否自然流畅的关键线索之一。传统 TTS 系统在生成多轮对话时往往忽略这一层,导致合成对话听起来像两个人轮流"念稿"而非真正交谈。Gemini TTS 将 |mhm|、|yeah| 等标记作为可显式控制的提示符,意味着开发者可以在脚本层面精确指定哪一方、在哪个时间点插入何种倾听信号,从而让双人对话在节奏感和情感真实性上更接近真实录音棚的播客效果。
基准测试与全球化能力
Google在多个第三方评测中给出了成绩。Gemini 3.8 Flash TTS 在 Hume AI 的 Voice Design Benchmark 上以71.4分位列总榜第一,并在口音建模上以60.8分领先。
在 Hume AI 的 Overall Quality Index 上,Gemini 3.8 Flash TTS 和 Flash-Lite TTS 分别占据第一和第二名。相较上一代 Gemini 3.1 Flash TTS,新模型在长文本内容和双人剧本控制等场景上有显著提升。
在 Voice Arena 的盲测人类偏好评估中,两款模型在日语、巴西葡萄牙语、越南语、现代标准阿拉伯语、墨西哥西班牙语和印地语等关键语言上均取得领先。配合100多种语言支持,这为面向全球的多语种语音体验提供了基础。
信任、同意与透明度
声音复刻天然涉及身份和滥用风险,Google为此设置了较为严格的安全机制。
声音复刻依赖同意验证:用户必须提供声音所有者的口头同意录音,且需与参考说话人匹配,才能创建声音。更广泛地,所有由 Gemini Audio 模型生成的音频都会嵌入 SynthID 水印——这一不可感知的水印直接编织进音频输出,使AI生成的语音保持可检测性,以帮助防范虚假信息传播。
这套"同意+水印+凭证"的组合,反映出语音克隆技术走向商用时不可回避的合规压力。
SynthID 是 Google DeepMind 开发的数字水印技术,最初应用于 AI 生成图像,后来扩展到视频、文本和音频领域。与传统元数据标签不同,SynthID 将水印直接编码进音频的声学结构中——在人耳无法察觉的频段嵌入可统计检测的模式——因此即使文件经过转码、剪辑或重新压缩,水印依然留存且可被专用检测器识别。C2PA(Coalition for Content Provenance and Authenticity)凭证则是由 Adobe、Microsoft、BBC 等机构共同制定的内容来源标准,通过加密签名的"营养标签"记录内容的创作工具、时间戳和修改历史,使下游平台和用户可以验证一段音频是否由 AI 生成、经由哪个模型处理。两者的结合形成了"感知层不可见 + 元数据层可追溯"的双重保护,在监管机构日益关注深度伪造音频的背景下,这类技术基础设施正在成为 AI 语音商用的事实门槛。
生态与可用性
从今天起,开发者可在 Google AI Studio 的音频playground中体验这些能力。它被设计成一个语音设计工作区,用户可以从零构建全新声音身份或复刻自己的声音,再直接带入双人剧本编辑器逐行导演。
通过 Gemini API,Agora、LiveKit、Pipecat、Vercel 等开发者平台可轻松构建和部署高性能语音生成体验。Google还与 Figma、HeyGen、Linguana、Wondercraft、99.co、Ollang 等公司合作,将新TTS模型用于全球配音、区域口音本地化和规模化语音代理。
落地路径上,两款模型均从当天开始向开发者(Gemini API 和 Google AI Studio)推出,企业版将通过 Gemini Enterprise API 上线。面向普通用户,Flash TTS 进入 Gemini Notebook,Flash-Lite TTS 则集成到 Google Vids。
对创作者和开发者而言,这次更新的意义在于:语音生成不再是选一个预设那么简单,而是一个可设计、可导演、可规模化,且带有合规护栏的完整创作管线。
相关推荐
AI Agent进入新阶段:从OpenClaw到Grok Bot、Muse,谁在给智能体一台电脑?
从OpenClaw、Hermes到Grok Bot、Muse与开源OpenMuse,AI Agent正从聊天框走向拥有浏览器、文件系统、终端和持久记忆的完整工作台。本文梳理这一年智能体形态的关键演进与「身体大脑解耦」的架构新思路。
澳总理称OpenAI智能体入侵政府网站,AI Agent安全隐忧再引热议
澳大利亚总理称OpenAI智能体入侵政府网站,引发技术社区热议。本文解析AI Agent自主性带来的安全风险、责任归属难题及监管挑战。
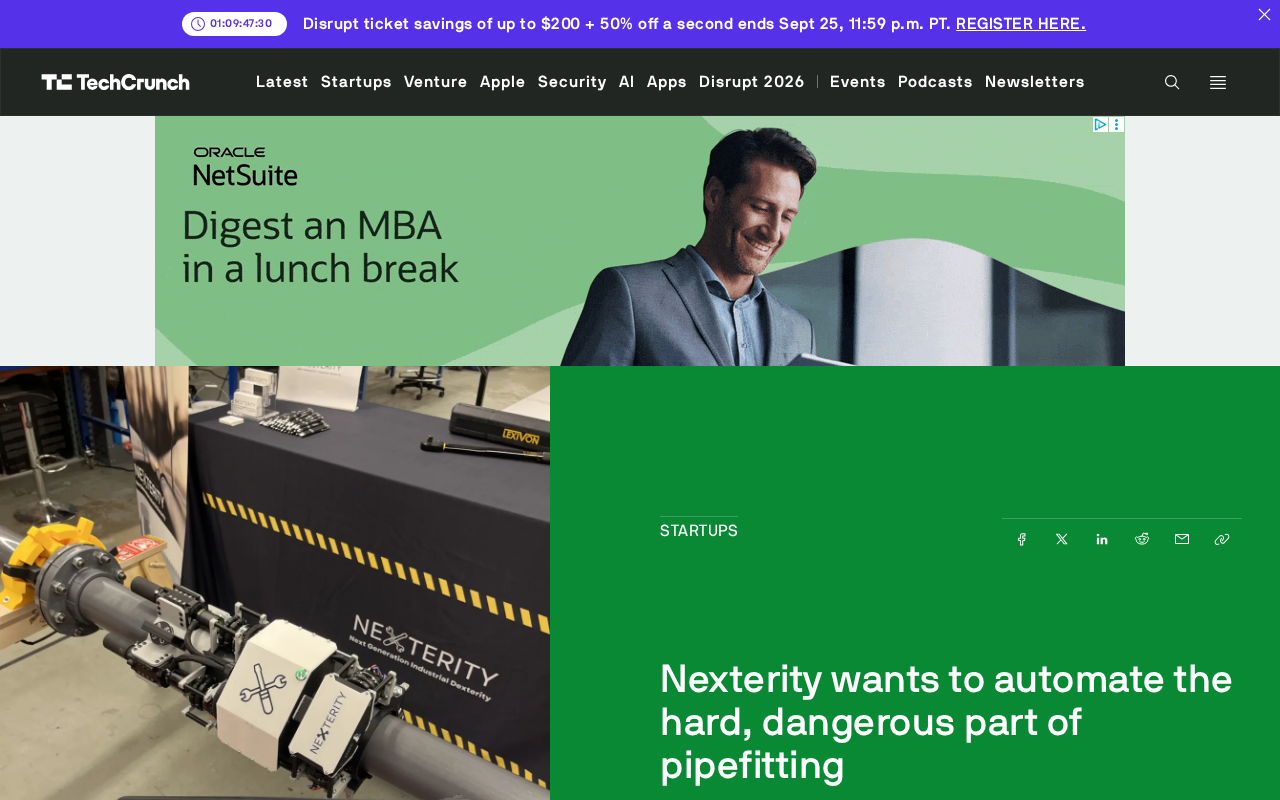
Nexterity机器人瞄准管道装配:自动化高危拧螺栓作业
初创公司 Nexterity 推出便携式管道装配机器人,可一次拧紧或松开四颗螺栓,并能装进 Pelican 防护箱,专攻工业管道作业中最危险繁重的环节,展现专用工业机器人的落地方向。