构建防泄漏的糖尿病再入院预测模型:10万次就诊的实战指南
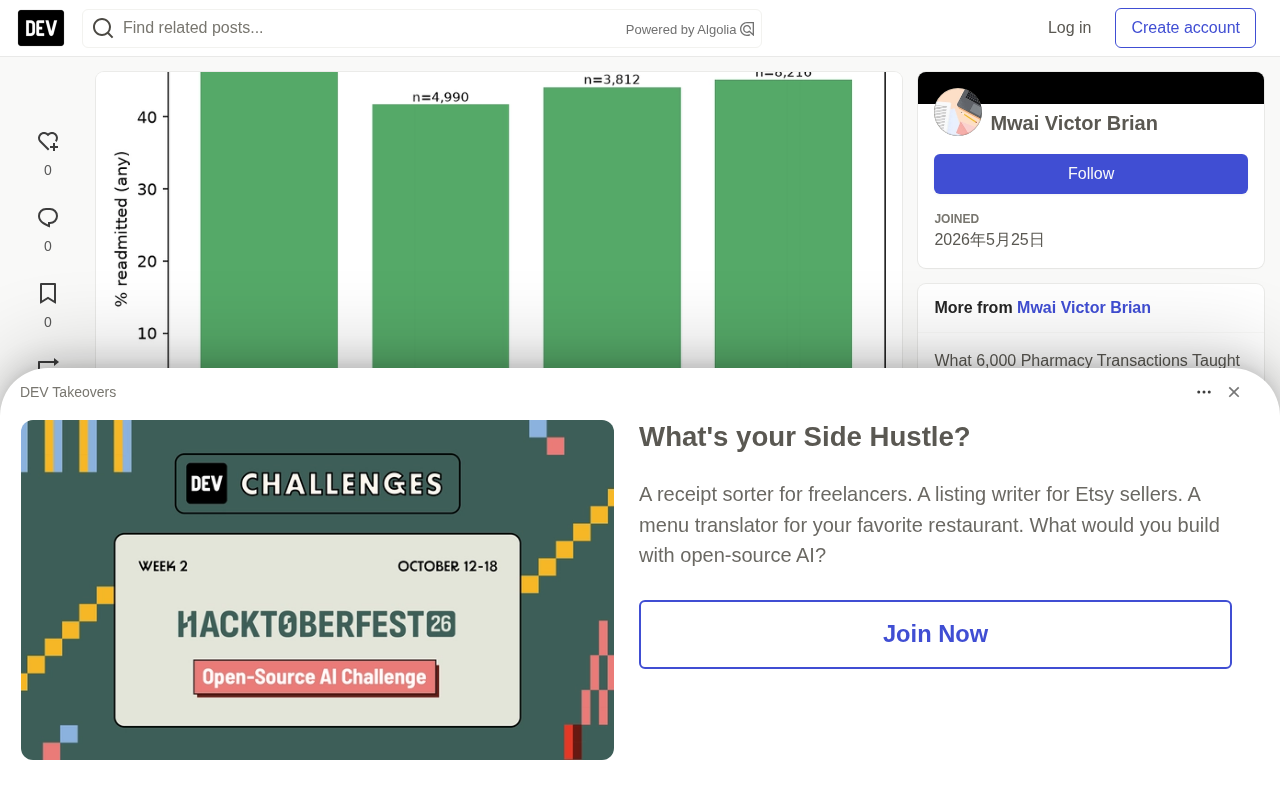
临床作者以糖尿病再入院数据集完整演示了问题定义、患者分组切分与诚实评估的建模流程。
文章基于 UCI 糖尿病再入院数据集(101,766 次住院、71,518 位患者),完整走了一遍建模流程,但核心不在调参,而在问题定义、数据切分与诚实评估。作者强调按患者分组切分(46.2% 的行来自重复入院患者,朴素随机划分会让 41.6% 的测试就诊来自模型已见过的患者)、保留“未做检查”的临床语义、在出院前时点定义特征并逐列排查泄漏。模型对比显示逻辑回归(ROC-AUC 0.679)与梯度提升(0.691)无实质差别,信号主要来自过去一年住院次数。在 70% 敏感度阈值下需标记 56.8% 的出院患者,校准良好,但模型仅基于 1999–2008 年美国数据,外推需本地验证。
医院再入院对医疗系统是沉重负担,对糖尿病患者尤其如此——出院后不久再次入院,往往意味着血糖控制、用药衔接或随访环节存在漏洞。如果能提前识别高风险患者,就能把有限的随访资源用在刀刃上。一位有临床背景的作者用UCI公开的Diabetes 130-US Hospitals数据集(101,766次住院记录,来自130家美国医院)完整走了一遍建模流程,但整个过程的核心不在调参,而在如何定义问题、切分数据和诚实地评估。
先理解你的数据行:每次就诊不等于每位患者
数据集有101,766行,但只对应71,518位患者,重复入院的患者贡献了46.2%的行。这个事实直接决定了评估设计:如果同一位患者的就诊记录同时出现在训练集和测试集,模型会部分“记住”这个人,而不是学到可泛化的规律。作者检查发现,朴素随机划分会把6,791位患者同时放进两个集合,测试集中41.6%的就诊来自模型已经见过的患者。因此,按患者分组切分不是可选项,而是必须。
数据加载的陷阱:None和缺失值不是一回事
数据集用?标记缺失值,但在HbA1c和葡萄糖列中,文本None表示“未做该检查”,这是一个真实的临床类别。pandas默认会把None转成缺失值,作者的数据中因此丢失了所有96,420条“未做葡萄糖检查”的记录。正确的加载方式是na_values=['?']配合keep_default_na=False,保留临床含义。此外,整数编码里也藏着缺失:入院类型5、6、8分别代表不可用、NULL和未映射,覆盖了10.2%的就诊,需要用数据集自带的ID映射文件转成缺失。
pandas 的缺失值解析机制:默认情况下,read_csv 会将一组预定义字符串(如 'NA'、'NULL'、'None' 等)自动识别为缺失值。通过设置 keep_default_na=False 可以禁用这一行为,再配合 na_values=['?'] 精确指定哪些字符串应被视为缺失。在医学数据中,区分“未做检查”与“数据缺失”至关重要:前者是真实的临床状态,携带信息;后者是数据录入问题。保留 None 作为分类水平能让模型利用“未检查”这一行为模式,而空值则须通过插补处理。这是数据加载阶段常见但容易被忽视的语义陷阱。
定义结局和预测时点:比选模型更重要
readmitted列有三个值:<30(30天内)、>30(更晚)和NO。作者拆成两个独立的二分类任务,绝不混用:任意再入院(主任务,阳性率47.1%)和30天再入院(次任务,阳性率11.4%)。预测时点固定在住院结束、出院之前。同时移除了2,423条以死亡或临终关怀结束的就诊,数据也证实所有1,652条死亡结局都被标为NO,如果保留会让模型学到无意义的规则。
逐列排查泄漏:出院 disposition 只能用来定义队列
目标泄漏是医疗模型无声的杀手。作者为每个变量写了纳入或排除的理由。出院处置(discharge disposition)只在定义队列时使用,不作为预测变量,因为它在住院最末端才确定。付款方代码(账单数据,缺失40%)和体重(缺失97%)被排除。主诊断代码被归为九个粗粒度临床类别,前提假设是出院前工作诊断已知。次诊断代码通常在出院后由编码员最终确定,第一版模型没有纳入。代码里还加了一条断言:任何禁止列进入特征矩阵就立即报错。
目标泄漏(Target Leakage) 指在训练特征中混入了预测时点之后才可获得或与结局直接相关的信息,导致模型在验证集上表现虚高而部署后失效。常见表现包括:使用出院后确定的编码、包含结局本身的衍生变量、或直接使用账单结算数据。排查方法是先明确预测时点,再逐列追问“该信息在该时点是否已知”。本例中,剔除死亡或临终关怀就诊、排除次诊断代码、限制出院 disposition 仅用于队列定义,都是防止泄漏的具体措施。在代码中加入断言禁止列进入特征矩阵,是一种可执行的防泄漏保障。
用Pipeline和患者分组切分保证评估诚实
作者用StratifiedGroupKFold按患者分组做80/20训练/测试切分,同时保持再入院率平衡(两边都是0.471),并断言患者零重叠。所有需要学习的预处理都放在scikit-learn的Pipeline和ColumnTransformer里:中位数插补、标准化、独热编码并合并稀有类别(min_frequency=100,handle_unknown='infrequent_if_exist')。任何变换都没有在测试数据上拟合过,交叉验证时也一样。
outer_split = StratifiedGroupKFold(n_splits=5, shuffle=True, random_state=42)
train_idx, test_idx = next(outer_split.split(X, y, groups))
assert not set(groups.iloc[train_idx]) & set(groups.iloc[test_idx])   # zero shared patients
StratifiedGroupKFold 是 scikit-learn 中用于分组交叉验证的拆分器,它在保持各折目标变量分布(stratified)的同时,确保同一组(如同一患者)的所有样本只会出现在一个折中(group)。其分组依据由 groups 参数指定,因此需要在调用 split 时将患者标识传入。在重复就诊数据中,这会强制训练集与测试集的患者集合互斥,避免模型通过“记住”个体而非学习规律来虚高评估分数。它适用于需要报告可靠泛化性能的场景,但可能增加折间方差,因此常配合固定的随机种子使用。
基线和模型:准确率会骗人
多数类基线达到约52.9%的准确率,却一个再入院患者都没识别出来——这提醒我们准确率不是临床指标。逻辑回归的测试集ROC-AUC为0.679(患者级bootstrap 95%置信区间0.670–0.687),PR-AUC为0.651,而阳性率是0.471。训练集交叉验证非常稳定(0.672 ± 0.003)。直方图梯度提升模型达到ROC-AUC 0.691(95% CI 0.683–0.700),训练成本约10秒。
提升模型真的比逻辑回归强吗?作者认为没有实质差别:置信区间重叠,AUC只提升0.013,在相同敏感度下特异度只提高2.3个百分点。信号主要来自一个近乎单调的特征——过去一年的住院次数。打乱该特征会让ROC-AUC下降0.075,影响约是其他特征的四倍。考虑到透明度,作者最终保留逻辑回归。
阈值与校准:抓七成再入院要随访一半出院患者
决策阈值在折外训练预测上选择,而不是测试集上,规则是:在敏感度至少70%的前提下取最高阈值,得到0.428。在该阈值下,测试集敏感度0.697、特异度0.547、精确率0.579,会标记56.8%的患者。规则从训练集(70.0%)迁移到新患者(69.7%)几乎无损。诚实的解读是:要抓住七成再入院,团队需要随访超过一半的出院患者。
校准曲线紧贴对角线。平均预测风险0.469,实际观察0.471,校准斜率1.05,每个十分位都在观察率的5个百分点以内。对出院团队来说,校准很重要:一个“60%风险”的标签应该意味着大约十个人里有六个真的会回来。在这个人群里,模型做到了。
校准(Calibration) 衡量模型预测概率与实际观察频率的一致性,与区分度(如 AUC)不同。一个区分度高但校准差的模型可能把风险排序排对,却给出误导性的绝对概率。常用检查包括校准曲线、校准斜率(理想为1)和平均预测风险与实际观察率的对比。在临床决策中,校准直接影响阈值选择:如果模型预测“60%风险”而实际只有40%的人再入院,则基于该概率的资源分配会错位。Platt 缩放、等渗回归等方法可用于事后校准,但若校准良好,可简化部署沟通。
给初学者的几条建议
- 头几个小时花在数据和问题上,而不是算法上。
- 选特征之前,先写下预测时点。
- 患者有重复记录时,按患者切分。
- 把所有学习型变换放进Pipeline。
- 报告PR-AUC、校准和阈值表,不要只报准确率。
- 明确模型不能做什么:这个模型用的是1999–2008年美国数据,没有本地验证不能用于其他地区的患者护理。
完整代码、图表和报告在GitHub:https://github.com/Mwaivictor/diabetes-readmission-prediction。数据集来自Clore、Cios、DeShazo和Strack(2014),UCI机器学习库,CC BY 4.0(DOI 10.24432/C5230J)。原始研究:Strack等(2014),BioMed Research International。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。