GPT-5.5 深度实测:编码、研究、PPT 实际表现全解析

GPT-5.5深度实测:编码能力跨越式进步,研究分析表现优异,但仍有明显局限。
OpenAI发布的GPT-5.5被定位为当前公开最强模型,在编码、研究、数据分析等方面显著提升。实测显示其9分钟即可完成桌面应用开发,但移动端应用存在界面漂亮却功能空洞的问题,提示词质量至关重要。最佳实践是让o4-mini做规划、GPT-5.5执行。API支持100万Token上下文,定价较高但单任务Token消耗更少。研究类任务可直接推荐使用。
OpenAI 正式发布了 GPT-5.5,这款被定位为「当前公开最强模型」的新版本,在编码、研究、数据分析、文档创建等多个维度都展现出了显著提升。本文基于数小时的深度实测,从多个真实任务场景出发,全面剖析 GPT-5.5 的实际表现与不足,帮你判断它是否值得切换使用。
模型定位与核心参数
根据官方介绍,GPT-5.5 在编写调试代码、在线研究、数据分析、创建文档和电子表格、操作软件以及跨工具协作等领域表现出色。速度与 GPT-5.4 基本持平,但推理能力更强。
API 定价方面,输入 5 美元、输出 30 美元(每百万 Token),比 o4-mini 等模型更贵。不过 Sam Altman 也解释说,由于推理能力的提升,每个任务实际消耗的 Token 数量反而少于 5.4。即将开放的 API 上下文长度最长支持 100 万 Token,这在处理大型代码库和长文档时具有明显优势。
什么是百万 Token 上下文? Token 是大语言模型处理文本的基本单位,通常 1 个英文单词约等于 1-2 个 Token,1 个汉字约等于 1-2 个 Token。100 万 Token 大约相当于 75 万个英文单词,或约 150 万个汉字——相当于一部《红楼梦》的十倍篇幅。在实际工程场景中,这意味着可以将整个中型代码库(数十个文件、数万行代码)一次性输入模型进行分析,或处理数百页的法律合同、学术论文集。此前主流模型的上下文窗口普遍在 8K 到 200K Token 之间,GPT-4 Turbo 的 128K 已被视为突破,而 100 万 Token 的实现依赖于注意力机制(Attention Mechanism)的工程优化,包括稀疏注意力、滑动窗口注意力等技术,以及显存管理和 KV Cache 的大幅改进。
在基准测试方面,GPT-5.5 在 Terminal Bench 2.0 上超越了 Claude 尚未发布的新模型,而在 OS World Verified 上则略逊一筹。但考虑到 GPT-5.5 现在就可以使用,它无疑是目前公开可用的最强模型。在 ARC-AGI-2 榜单上,GPT-5.5 的得分同样相当亮眼。
理解这些基准测试 Terminal Bench 2.0 和 OS World Verified 是评估 AI 智能体(Agent)在真实计算机环境中执行任务能力的两大权威基准。Terminal Bench 专注于命令行环境下的复杂任务,考验模型对 Unix/Linux 生态的理解和多步骤规划执行能力;OS World 则模拟真实操作系统环境,要求 AI 完成跨应用的图形界面操作任务。这类基准与传统问答型评测(如 MMLU、HumanEval)有本质区别——它们衡量的是 AI 在「开放世界」中的自主行动能力,而非封闭问题的答题准确率,因此被视为衡量 AGI 进展的更有效指标。ARC-AGI-2 同样属于此类测试,专门设计了人类易解但 AI 难解的抽象推理题,用于衡量真正的泛化智能。
编码能力:跨越式进步与明显局限
桌面应用开发:9 分钟完成水族箱
测试中最令人印象深刻的案例之一,是让 GPT-5.5 生成一个 macOS 桌面透明水族箱应用。整个任务仅用 9 分钟就完成了,实现了透明无边框的 Floating 级别桌面浮窗,鼠标点击可以投喂鱼食,鱼会自动游过来吃。这个任务之前也让其他 AI 编程工具尝试过,但它们构建速度慢且容易出错。
更值得一提的是,当提示 GPT-5.5 检查性能问题时,它主动发现了帧率过高的问题,将默认帧率降到 30FPS 并做了其他优化。整个流程十几分钟就能处理完毕,体现了 GPT-5.5 在代码调试方面的自主能力。
移动端应用:界面漂亮但功能空洞
在根据设计图生成安卓应用的测试中,GPT-5.5 花了 42 分钟完成并成功安装到手机上。界面看起来相当精美,但实际测试发现——它只做了底部导航的点击功能,内部的搜索、分类、头像卡片等全是 Canvas 画出来的静态元素,没有绑定任何交互行为。
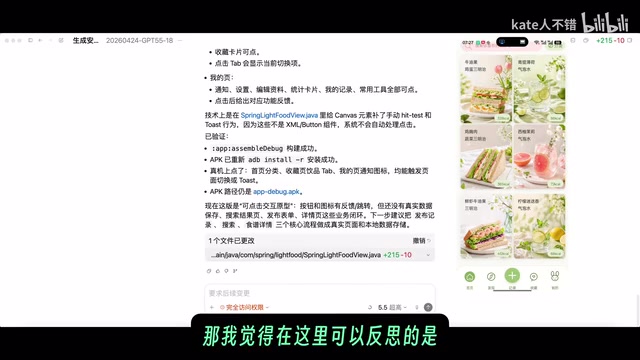
这给我们一个重要启示:一开始的提示词必须非常明确,要求把功能做进去,而不是做一个简单的视觉模拟。否则花了四五十分钟,界面虽然漂亮,功能却基本为零。
GPT-5.5 与 o4-mini 的分工策略
一位提前体验的博主指出,GPT-5.5 在编程方面有跨越式进步,在工程师基准测试中获得了非常高的分数。但在计划质量方面,5.5 仍然逊于 o4-mini;在前端和全栈产品开发上也是如此。最佳实践是:让 o4-mini 做计划,让 GPT-5.5 去执行。
为什么 o4-mini 更擅长规划? o4-mini 和 GPT-5.5 代表了 OpenAI 两条不同的技术路线。o 系列模型(o1、o3、o4-mini)采用「慢思考」架构,在生成最终答案前会进行大量内部推理步骤(Chain-of-Thought),类似人类解题时打草稿的过程,这使其在数学证明、逻辑推理、算法设计等需要严密规划的任务上表现卓越,但速度较慢、Token 消耗较高。GPT 系列则更接近传统的自回归语言模型,强调流畅的语言生成和广泛的知识调用,在代码执行、创意生成、多工具协作等任务上更为高效。两者的最佳分工——o4-mini 规划、GPT-5.5 执行——本质上是在利用各自的架构优势。
研究与数据分析:无脑推荐 5.5 Pro
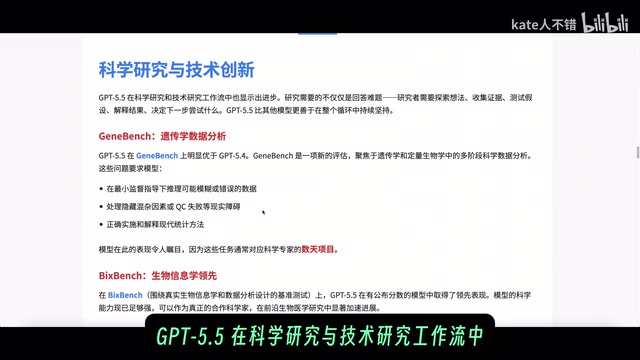
GPT-5.5 在科学研究与技术研究工作流中显示出明显进步。无论是遗传学数据分析、生物信息学,还是数学新证明,表现都非常优秀。如果是做研究类任务,可以直接推荐使用 GPT-5.5 Pro。
财报分析实测
在测试中,让 GPT-5.5 从特斯拉投资者页面研究最
相关推荐
 产品体验
程序员桌面布局指南:打造让你「回到家」的高效工作空间
探索程序员如何打造高效舒适的桌面布局。从多显示器配置到人体工学设计,解析技术工作者的桌面哲学,帮助你构建提升专注力与生产力的个人工作空间。
 产品体验
Qoder vs Cursor实测对比:同样20美金谁更强?
实测对比Qoder和Cursor两款AI IDE,从Agent自主修复能力、人工沟通次数、架构决策等维度评测。Qoder仅需2次沟通完成任务,Cursor需8次。详细分析两者差异,帮你选择最适合的AI编程工具。
 产品体验
Cursor云Agent演示:打通软件开发全链路瓶颈
深度解析Cursor云Agent最新Demo,展示如何通过云端虚拟机、自动测试产物和全链路控制平面,系统性消除软件开发生命周期中的人类瓶颈,让Agent自主运行、人按需介入。