GPT-5.6曝光:Agent编程token效率提升54%意味着什么

事件概述
OpenAI CEO Sam Altman 近日透露,即将发布的 GPT-5.6 在智能体编程(agentic coding)场景下的 token 使用效率相比前代提升了 54%。这一消息目前公开信息尚少,但对于长期依赖 AI 编程工具的开发者来说,这个数字背后藏着不少值得深挖的技术含义。
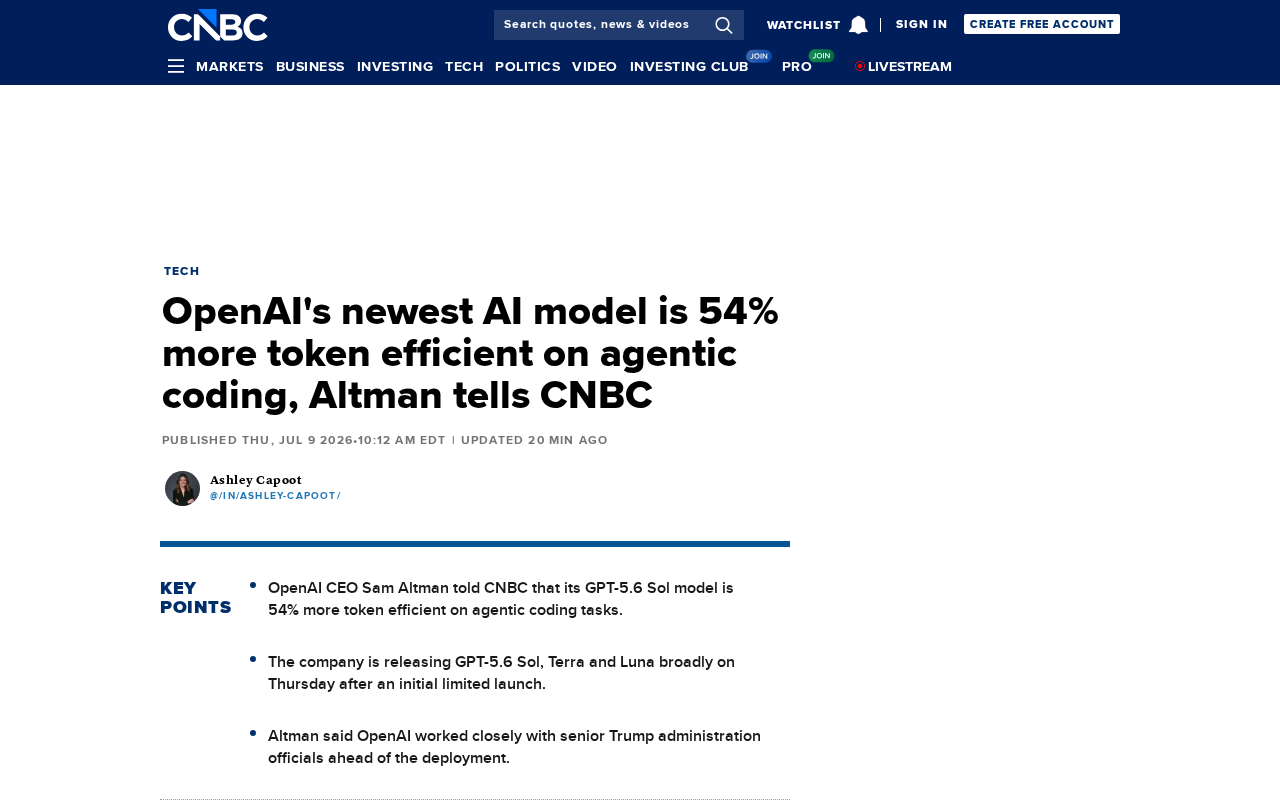
所谓「token 效率提升 54%」,简单来说就是:完成同样一个编程任务,新模型消耗的 token 数量减少了近一半。这不仅意味着更低的调用成本,也可能带来更快的响应速度和更充裕的上下文窗口利用空间。
什么是 Token? Token 是大语言模型处理文本的基本单位,并非简单等同于字符或单词。在英文中,一个 token 大约对应 4 个字符或 0.75 个单词;中文由于编码方式不同,通常一个汉字对应 1-2 个 token。OpenAI 的 GPT 系列使用 BPE(Byte Pair Encoding)分词算法——这一算法最初由 Philip Gage 于 1994 年作为数据压缩方案提出,后被引入 NLP 领域用于子词切分,其核心思想是迭代合并语料库中出现频率最高的字节对,在字符级与词级表示之间取得平衡。GPT 系列实际使用的是改进版 tiktoken 分词器,在多语言和代码场景下表现更优。理解 BPE 有助于开发者优化 Prompt 设计,例如避免不必要的特殊符号,以降低 token 消耗。模型的上下文窗口限制(如 128K tokens)、API 定价(按输入/输出 token 分别计费)以及推理延迟,都直接与 token 数量挂钩,这也是「token 效率」成为核心竞争指标的根本原因。
为什么 Token 效率对 Agent 编程至关重要
Agent 编程的成本痛点
与传统的一问一答式代码补全不同,agentic coding(智能体编程)指的是模型能够自主规划、多步执行、调用工具、读取并修改多个文件,甚至进行自我调试的工作模式。Claude Code、Cursor Agent、OpenAI Codex 等工具都属于这一范畴。
从技术架构来看,agentic coding 并非单一模型调用,而是一套完整的「感知-规划-执行」循环系统。典型架构包含以下核心组件:任务分解器(将复杂需求拆解为子任务)、工具调用层(读写文件、执行命令、搜索代码库)、记忆管理模块(维护跨步骤的工作状态)以及自我校验机制(运行测试、分析错误并迭代修复)。业界常见的 ReAct(Reasoning + Acting)框架是这类架构的典型实现范式——由 Yao 等人于 2022 年提出,其核心创新在于将链式思维推理与外部工具调用交织在同一序列中,形成「思考→行动→观察」的循环。相较于纯推理或纯工具调用,ReAct 让模型在每次工具调用前先用自然语言阐明意图,显著提升了长任务的可解释性和容错能力。然而,每轮「思考」本身会产生大量 token 开销,这正是 token 效率优化的主要攻关方向之一。
这种工作模式最大的问题是 token 消耗极其惊人。在每一个执行循环中,模型需要将所有历史操作记录、当前代码状态、工具返回结果全部打包进上下文——这正是 token 消耗呈指数级增长的根本原因。面对一个复杂的重构任务,Agent 往往需要反复读取项目文件、分析上下文、生成方案、执行操作、验证结果,每一步都在不断累积 token 开销。对于按量计费的 API 调用而言,成本会迅速攀升,许多开发者都有过「一个下午烧掉几十美元」的经历。
54% 效率提升意味着什么
如果 Altman 所言属实,GPT-5.6 将 token 效率提升 54%,对开发者的直接影响包括:
- 成本近乎腰斩:同样的编程任务,API 费用可能从 $10 降至 $5 以下
- 更长的有效工作链:在相同上下文预算下,Agent 可处理更大规模的代码库或执行更多步骤而不「超支」
- 响应更快:生成的 token 更少,通常意味着推理时间缩短
对于依赖 AI 编程工具进行日常开发的团队来说,这种效率跃升可能直接改变工具的经济可行性和使用边界。
效率提升可能来自哪里
更精炼的输出表达
Token 效率的提升往往不只是模型「更聪明」,还可能源于训练层面的系统优化——例如让模型学会更简洁地表达推理过程、削减冗余思考步骤、避免重复读取已知信息。GPT 系列在推理模型的迭代中,已愈发强调「有效推理」而非「冗长推理」。
值得注意的是,OpenAI 在 o 系列推理模型(o1、o3 等)中已引入**「思考预算」(Thinking Budget)机制**,可动态控制内部推理链的长度。这一机制的本质是在「推理深度」与「计算成本」之间提供可调节的权衡旋钮——对于简单编程任务可压缩思考链,对复杂架构设计则允许充分推理。Anthropic 在 Claude 3.7 Sonnet 中也实现了类似的「扩展思考」(Extended Thinking)模式,允许用户设定思考 token 上限。这与 GPT-5.6 声称的 token 效率提升在技术逻辑上一脉相承,从整体上提升 token 使用效率。
工具调用策略的精准化
Agent 编程中有相当大一部分 token 开销来自工具调用和结果反馈。如果模型能更精准地判断「读哪些文件」「一次读多少」,避免盲目扫描整个项目,就能显著减少无效 token 的浪费。这很可能是 GPT-5.6 在工程层面的重点改进方向之一。
上下文管理机制的升级
Agent 在长任务中如何压缩、归纳和检索历史上下文,同样是效率的关键变量。上下文压缩(Context Compression)是当前 LLM 工程领域的热门研究方向,主要技术路径包括:滑动窗口(丢弃最早的历史信息)、摘要压缩(用模型生成对话历史的摘要替代原文)、KV Cache 复用以及 RAG 检索增强(按需检索相关上下文而非全量输入)。
其中 KV Cache(键值缓存)值得特别说明:在 Transformer 自回归生成过程中,每个新 token 的注意力计算需要访问所有历史 token 的 Key 和 Value 矩阵,KV Cache 通过将已计算的 K/V 向量缓存在显存中,将推理复杂度从 O(n²) 降至 O(n)。在 agentic 场景下,若 Agent 多轮调用共享同一段系统提示或代码上下文,服务端的 Prompt Cache(OpenAI、Anthropic 均已推出此功能)可复用这部分 KV Cache,对调用方直接体现为 token 费用折扣(通常为 50%–90%),与模型层面的 token 效率提升形成叠加效应。
更激进的研究方向如 Mamba 等状态空间模型则试图从架构层面彻底解决长上下文的效率瓶颈。Mamba 由 Albert Gu 和 Tri Dao 于 2023 年提出,通过选择性状态空间对序列信息进行压缩性编码,推理时的计算复杂度和显存占用均为 O(1),而非 Transformer 的 O(n)。然而,当前纯 SSM 架构在语言建模质量上仍与 Transformer 存在差距,业界更多探索 Mamba-Transformer 混合架构(如 Jamba)以兼顾效率与质量。更优秀的上下文压缩策略,可以让模型在不丢失关键信息的前提下,大幅减少每次调用所携带的 token 量。
需要保持的审慎态度
目前这条消息的公开信息依然有限,社区讨论也尚未铺开。关于版本命名,「GPT-5.6」这一表述值得关注:历史上 OpenAI 曾以 GPT-3.5-turbo、GPT-4-turbo、GPT-4o 等方式发布中间版本,这类版本通常针对推理效率、成本或特定能力进行优化,而非全面升级基础模型。这种「小步快跑」的发布节奏与 Anthropic 的 Claude 3.5 系列、Google 的 Gemini Flash 系列策略趋于一致,反映出头部 AI 公司越来越注重在「旗舰能力」与「部署经济性」之间寻求最优平衡。具体版本命名仍需以 OpenAI 官方发布为准。
此外,「token 效率提升 54%」是一个需要仔细审视的指标:
- 这是在特定 benchmark 上测得的结果,还是综合场景的平均表现?
- 效率提升是否以牺牲代码质量或任务成功率为代价?
- 对比的基线版本是 GPT-5 还是更早的模型?
在没有完整技术报告的情况下,这些问题都无从确认。厂商在推介新模型时往往倾向于展示最有利的指标,对单一数字保持理性判断始终是必要的。
对开发者的实际意义
当前 AI 编程工具市场已形成三层竞争格局:底层模型层决定智能上限与成本基线,有 GPT 系列、Claude、Gemini、DeepSeek广告 等;中间层 IDE 集成层决定开发者日常交互体验,有 GitHub Copilot、Cursor、Windsurf 等;顶层自主编程 Agent 层承接端到端复杂工程任务,有 Claude Code、Devin、OpenHands 等。值得关注的是,这三层之间的边界正在模糊——Anthropic 直接推出 Claude Code 绕过 IDE 厂商触达开发者,OpenAI 的 Codex CLI 同样采取命令行直连策略;与此同时,开源生态中的 OpenHands、SWE-agent 等项目以 SWE-bench 等标准基准为竞技场,形成对商业产品的有效压力。
在这一背景下,token 效率不仅是技术指标,更是商业竞争的核心筹码——效率更高的模型可以在相同成本下完成更复杂的任务,在「每美元交付价值」这一维度上建立差异化优势。
对于开发者而言,这一趋势意味着:
- AI 辅助编程的门槛将持续降低,个人开发者也能负担得起复杂的 Agent 工作流
- 工具选型时应关注「单位任务成本」而非单纯的 token 单价,效率高的模型即使单价略贵,综合算下来往往更划算
- 大型代码库的自动化处理将变得更可行,为遗留系统重构、大规模迁移等场景打开新的可能
如果 GPT-5.6 的这一改进能在真实开发场景中得到兑现,将进一步巩固 AI 编程工具在软件工程流程中的核心地位。我们期待 OpenAI 后续释出更详尽的技术文档和第三方评测,以验证这一说法的实际效果。
核心要点
核心要点
相关推荐

AgentCore 实战:为智能体接入自定义工具与 MCP 服务器
DebuggerCafe 教程演示如何为 Amazon Bedrock AgentCore 智能体接入自定义工具与 MCP 服务器,突破默认工具集限制,并分析工具契约设计、MCP 复用价值及扩展后的工程注意事项。

816B参数只拿39分?开源大模型参数竞赛的性价比真相
Meta 816B Muse Spark Open 在 Artificial Analysis 仅得39分,180B Qwen3.8-Flash-Next 却拿到40分。本文解析11个开源权重模型的参数与分数关系,探讨激活参数、量化体积与部署成本的真实影响。

空中机械臂:无人机从「看」到「改」的下一步
从Reddit讨论出发,分析空中机械臂(Aerial Manipulator)的技术难点、潜在应用场景与落地瓶颈,探讨无人机从环境感知走向物理操作的关键挑战。