GPT-5.6实测:农场自动化、数学突破与端到端AI执行能力解析

当AI走出屏幕,走向物理世界
过去几周,全球用户开始测试全新 ChatGPT 中的 GPT-5.6 模型。与以往版本最大的不同在于——这一代模型的能力不再局限于屏幕之内,而是开始在真实的物理世界中产生影响。从北海道的农场,到纽约的家庭创业,再到波兰数学家的研究突破,GPT-5.6 正在展示一种全新的 AI 应用范式。
据来源视频介绍,此次发布的模型家族包含 Sol、Terra 与 Luna 三个成员,分别覆盖不同的应用场景。三个名称对应「太阳、大地、月亮」的宇宙意象,暗示其覆盖范围从高能推理到日常辅助的完整生态——这种模型家族化策略已成为头部AI实验室的主流路线:Google(Gemini Ultra/Pro/Flash)、Anthropic(Claude Opus/Sonnet/Haiku)均采用类似分层架构,以不同参数规模和推理成本匹配不同场景需求,避免单一模型在性能与部署成本之间的两难取舍。
行业背景:为何所有头部实验室都走向模型家族化? 大型语言模型的推理成本与参数量大致呈线性关系,单一超大模型在高并发场景下的API调用成本往往令中小企业望而却步。通过将模型家族化,实验室可以用轻量级模型(如Flash/Haiku/Luna)承接高频、低复杂度的日常任务,将重型模型(如Ultra/Opus/Sol)保留给需要深度推理的专业场景,从而在整体推理成本与用户体验之间取得最优平衡。这一策略的本质是「按需分配算力」,而非技术上的妥协。
算力经济学的深层逻辑: 从推理成本结构来看,GPT-5.6三模型家族的战略意义远不止于产品线划分。Transformer架构于2017年由Google Brain团队在论文《Attention Is All You Need》中提出,其核心机制——多头自注意力(Multi-Head Self-Attention)——的计算复杂度与序列长度呈O(n²)关系,这直接导致推理成本随上下文窗口扩大急剧攀升。以典型场景为例,一次调用千亿参数级别旗舰模型的成本,可能相当于调用百亿参数轻量模型的10-20倍;以A100 GPU为参照,一个1000亿参数的模型处理单次推理请求需约80GB显存,而百亿参数级别模型仅需约20GB,受益于KV Cache优化和INT8/INT4量化技术,轻量模型的实际吞吐量往往可达旗舰模型的5-10倍。当日均API调用量达到数亿次规模时,这种成本差异将直接决定商业模式的可持续性。正因如此,Sol(对应旗舰推理)、Terra(对应专业任务)、Luna(对应日常辅助)的三级划分,既是技术路线图,也是商业模式设计——让不同付费意愿的用户各得其所,同时最大化整体算力利用率。
贯穿所有案例的核心,是模型「一次性完成端到端任务」的能力跃升。
农场自动化:北海道的物联网实践
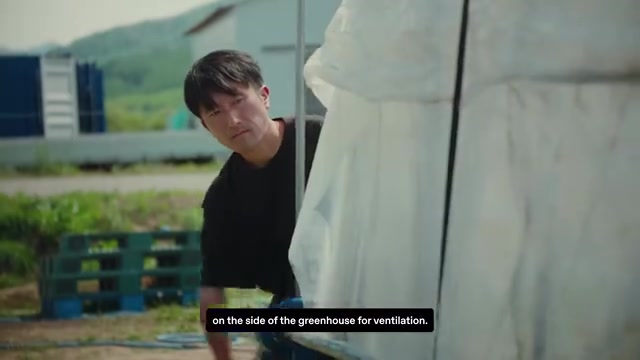
视频中最引人注目的案例来自日本北海道的农民 Hiroki。他借助 GPT-5.6 实现了温室大棚门的自动开合控制——这并非一个简单的软件任务。
GPT-5.6 全程充当跨越软硬件的工程顾问:首先告知 Hiroki 需要采购哪些硬件设备,接着指导他为树莓派(Raspberry Pi)完成接线,最后一步步协助完成电机安装。
关于树莓派与物联网门槛: 树莓派是一款由英国树莓派基金会开发的单板计算机,自2012年发布以来已售出超过5000万台,售价约35美元,却能通过GPIO(General Purpose Input/Output,通用输入输出)引脚直接连接传感器、电机等物理设备。GPIO接口包含40个引脚,支持数字输入输出、PWM(脉宽调制)、I2C、SPI、UART等多种通信协议,遵循ARM处理器的BCM(Broadcom)编号规范,工作在3.3V逻辑电平,是连接软件世界与物理世界的核心桥梁。
值得注意的是,GPIO引脚本身最大输出电流仅约16mA,不足以直接驱动电机。树莓派的GPIO生态系统在物联网教育领域已形成完整的知识图谱:继电器模块作为高压隔离器件,通过电磁感应原理将GPIO的3.3V低压控制信号转换为对220V交流或12V直流电机的开关控制,本质上是「以小信号控制大功率」的安全隔断方案;H桥驱动芯片(以L298N为代表)则提供更精细的PWM调速能力,通过改变脉冲占空比实现电机转速的线性控制,同时支持正反转换向。这两种方案在DIY社区已有大量开源库支持(如RPi.GPIO、gpiozero),但精确的接线顺序、上下拉电阻的配置、GPIO编号系统(BCM编号 vs BOARD编号的区分)等细节,仍是初学者最常犯错的雷区——这两层硬件知识的叠加组合,正是普通用户面临最大门槛的根源所在:任何一个环节的错误接线,都可能导致树莓派损毁甚至安全事故。
物联网硬件调试的隐性成本: 以一个典型的温室自动化项目为例,仅GPIO接线调试环节就涉及至少三类常见故障模式:其一是逻辑电平不匹配(5V设备直连3.3V GPIO引脚导致芯片损毁);其二是浮空引脚(未配置上下拉电阻导致随机电平跳变,引发电机异常抖动);其三是地线回路断开(多设备共地不当导致信号干扰或设备无响应)。这三类问题在专业嵌入式工程师看来是基础常识,但对于缺乏电气背景的农业从业者而言,每一项都需要专业指导才能识别和排除。AI作为随时可用的「电气工程顾问」,其价值在此场景中尤为突出。
AI作为跨领域知识整合者的深层价值: 一个完整的温室自动化项目涉及的知识栈包括:电气工程(电机驱动、继电器选型、电流/电压匹配)、嵌入式系统(GPIO编程、实时调度)、Linux系统管理(权限配置、进程守护)、Python/C编程,以及具体传感器的通信协议(I2C/SPI/UART)。这些知识原本分散在数十本技术手册中,需要数年工程实践才能融会贯通。物联网项目通常要求开发者同时掌握电气原理、嵌入式编程、Linux系统配置和具体硬件规格,这正是过去需要嵌入式工程师才能胜任的工作。AI在此场景中的价值在于将这些知识即时语境化——不是给出通用答案,而是针对Hiroki具体选购的硬件型号、具体的接线状态,给出可执行的精准指导。AI充当「跨软硬件工程顾问」的价值,本质上是将原本分散在多本专业书籍和多年实践经验中的知识,按需、即时地汇聚到一个对话界面——一个原本需要专业知识的物联网项目,就此变成普通农民也能独立完成的操作。
Hiroki 对新旧模型的差异做了精准总结:旧模型需要反复多轮交互、持续纠错;而新模型支持「一次性提示」(one-shot prompt)——Codex 会自行读取数据库、主动调用各类工具、理解最终目标并独立实现。他称之为「难以置信的改变」。
小企业的智能助手:从混乱输入到精致输出
五分钟"大脑倾倒",换来完整商业仪表盘
第二个案例来自纽约一对经营早餐麦片生意的夫妇,以及 Three Wishes 团队的 Jake。Jake 展示了他向模型下达的指令:
「我总是先说,请为自己设定一个端到端完成任务的目标。请用历史发布数据来指导仪表盘本身。使用 Three Wishes 的品牌元素,特别是新品牌……」
这段被现场评价为「我见过最混乱的思维流」的输入,恰恰映衬出 GPT-5.6 的核心优势——它能将一段冗长、零散的口头描述,自动转化为完整的执行计划,主动拉取相关数据与品牌资产,最终输出精致可用的仪表盘、演示文稿或电子表格。
值得注意的是,这种「容忍模糊输入并自动补全意图」的能力,在技术上依赖于模型对上下文意图的深度推断,而非简单的指令匹配。这与传统RPA(机器人流程自动化)工具要求输入严格结构化的逻辑有着根本区别——传统RPA工具如UiPath、Automation Anywhere,依赖预定义的规则和精确的UI元素定位,本质上是「录制-回放」的自动化脚本:一旦界面元素位置变化或输入格式不符预期,流程便会中断报错。
从RPA到AI Agent:自动化范式的代际迭代: 传统RPA于2000年代兴起,其技术底座是屏幕抓取(Screen Scraping)和规则引擎——通过识别UI元素的绝对坐标或XPath路径来模拟人工操作。这种「脆性自动化」的本质缺陷在于对环境变化零容忍:一次软件界面更新就可能导致整个自动化流程崩溃,维护成本极高。RPA厂商的应对策略通常是引入「图像识别」容错层,但这只是治标之策,根本无法理解任务语义。
与此形成对比的是,基于LLM的AI Agent引入了语义理解层作为缓冲:即使输入格式改变、界面元素移位,模型依然能通过语义推断定位意图,动态调整执行路径。这从根本上解决了传统RPA的脆性问题——也解释了为何Gartner在2024年将「AI增强型自动化」列为十大战略技术趋势之首,以及为何2024年后众多RPA厂商(包括UiPath、Blue Prism)开始将LLM能力整合进自身产品线。从底层架构来看,这一演进的本质是将「规则匹配层」替换为「语义推理层」:前者依赖人工穷举所有可能的输入变体,后者通过训练习得对意图的泛化理解,因而天然具备对未见输入的容错能力。基于大语言模型的AI Agent实现了从「刚性自动化」到「弹性自主化」的跨越:模型不仅能容忍格式变化,还能在输入模糊时主动推断用户意图、动态选择工具链。
意图推断的技术机制:提示工程与语义压缩 模型处理「混乱输入」的能力,在技术层面源于预训练阶段对海量人类自然语言的统计建模——模型学会了将表面杂乱的语言信号映射到底层的结构化意图。这一过程类似于信息论中的「语义压缩」(Semantic Compression):从冗余的自然语言表达中提取最小充分统计量(即任务的核心意图与约束条件),再展开为可执行的行动序列。Jake那段「最混乱的思维流」,对模型而言本质上是一段包含任务目标(仪表盘)、数据源(历史发布数据)、风格约束(品牌元素)和执行模式(端到端)的结构化信息——只是以人类习惯的非正式方式表达出来。这正是LLM区别于传统NLP系统的核心能力:后者依赖明确的语法结构,前者能从语用层面(Pragmatics)理解说话者的真实意图。
用户的感叹颇具代表性:「这感觉像是通常只有市值数十亿美元的大公司才能构建的东西,而我们现在就能得到?我拥有了自己定制的软件系统。」这句话点出了 AI 生产力工具对中小企业的真正价值——把原本高不可攀的定制化软件能力彻底平民化。
攻克三年未解的数学难题
最具分量的案例来自波兰数学家 Bartosz。他为同一个数学问题钻研了整整三年,始终无法突破。尝试 Codex 5.6 之后,局面发生了根本性转变。
Bartosz 表示,Codex 提出了一个「全新的思路」,帮助他推翻了这三年来一直试图证明的猜想。技术层面的关键在于:GPT-5.6 能够将复杂问题分解为并行工作流,由多个智能体(Agents)分别求解不同的子问题。
值得关注的是,「推翻一个已研究三年的猜想」本身就具有重要价值——它避免了研究者继续沿错误路径投入时间。AI在此扮演的角色类似于「外部评审者」:因为不带有研究者的路径依赖和确认偏误(Confirmation Bias),反而更容易识别思路的根本性缺陷。
认知科学背景:为何AI能突破人类研究者的思维定势? 确认偏误(Confirmation Bias)是认知心理学中记录最为充分的系统性偏差之一,指人们倾向于寻找、解释和记忆与自身既有信念相符的信息,而无意识地忽略反证。丹尼尔·卡尼曼(Daniel Kahneman)在《思考,快与慢》中将其归类为「系统1思维」的典型缺陷——直觉驱动的快速判断容易被既有框架锚定。在长期科研工作中,研究者往往会对自己投入大量时间的假设产生情感依附,导致对否定性证据的敏感度显著下降,这一现象在心理学上也被称为「沉没成本谬误」的认知延伸。更深层的神经科学研究表明,前额叶皮层在长期专注于单一假设时会形成「注意力隧道效应」(Attentional Tunneling),主动抑制与当前心智模型相悖的信息处理——这是大脑节省认知资源的进化优化,却在需要范式突破的创造性工作中成为障碍。AI在此场景中的优势不仅在于算力,更在于其「无路径依赖」的特性——模型不会因为某个猜想「已研究三年」而赋予它额外的权重,这与贝叶斯推理的客观先验原则高度契合,也与人类同行评审的作用机制高度互补,而非单纯替代。
多智能体并行架构的技术底座: 多智能体(Multi-Agent)架构是当前大模型落地复杂任务的关键技术路径,其核心思想源自分布式计算——将一个复杂问题拆解为多个子任务,由相互独立的「智能体」并行处理,再由协调层汇总结果。
数学证明场景中的搜索空间覆盖: 数学证明在计算复杂度理论中属于典型的「宽搜索空间、高验证成本」问题:可能的证明路径往往是指数级的,而验证单条路径的正确性需要严密的逻辑推演。人类研究者受限于线性思维和工作记忆容量(心理学研究表明,人类工作记忆的平均容量约为「7±2」个信息组块,由George Miller于1956年在《神奇的数字7±2》中首次量化提出),通常只能串行探索2-3条主要路径。多智能体框架的核心突破在于将搜索过程并行化:不同智能体可同时探索代数变换、几何解释、构造性证明等完全不同的证明路径,由协调层(Orchestrator Agent)负责评估各路径的进展,动态分配计算资源给最有希望的方向。
这一机制在形式上高度接近蒙特卡洛树搜索(Monte Carlo Tree Search,MCTS)——正是AlphaGo击败人类围棋冠军所依赖的核心算法思想的延伸应用。MCTS由Rémi Coulom于2006年正式提出,后经DeepMind在AlphaGo(2016)和AlphaZero(2017)中的工程化应用而广为人知,其核心四步循环——选择(Selection)、扩展(Expansion)、模拟(Simulation)、反向传播(Backpropagation)——构成了对指数级搜索空间的有效近似采样方案。MCTS通过随机采样模拟未来状态,在「探索新路径」与「利用已知优势路径」之间动态平衡(即经典的Exploration-Exploitation权衡),从而在围棋博弈树的指数级分支中高效定位最优走法。值得注意的是,OpenAI在o1/o3系列模型中引入的「思维链扩展计算」(Chain-of-Thought Scaling),以及DeepMind在AlphaProof中针对数学证明的应用,均体现了这一搜索思想的延伸:通过在推理时投入更多计算资源来探索更广的解空间,而非仅依赖参数规模的提升。
形式化验证与AI数学推理的技术边界: DeepMind的AlphaProof将数学证明问题转化为形式化证明(Formal Proof)任务,依托Lean、Isabelle等定理证明器作为验证后端——模型生成的每一步推导都由证明器进行机械化验证,杜绝了「幻觉式证明」(Hallucinated Proof)的风险。这与GPT-5.6的多智能体框架形成互补:前者以形式化验证保证严格性,后者以语义理解和并行探索提升覆盖广度。在Bartosz的案例中,AI提供的「全新思路」仍需数学家本人进行严格验证,这正是当前阶段人机协作的理性分工——AI负责快速扫描解空间、提出假设方向,人类负责形式化验证与最终判断。
数学证明的解空间与围棋棋局具有深刻的结构性相似之处:均面临指数爆炸的分支因子,且单条路径的验证成本极高。多智能体框架借鉴了这一思想,用并行化替代串行搜索,本质上是用算力换取对解空间的更广覆盖。在数学证明场景中,多智能体并行处理显著提升了求解效率与解空间的覆盖广度。OpenAI、Anthropic、Google DeepMind等头部机构均在2024年后将多智能体框架列为核心研究方向,这一架构也是AI从「单轮问答工具」进化为「自主执行系统」的底层基础设施。
核心跃迁:真正的端到端自主执行
综合三个案例,GPT-5.6 最本质的进步可以概括为「自主的端到端执行能力」。
理解「端到端」的技术意义:「端到端」(End-to-End)概念源自机器学习领域,其历史脉络有清晰的里程碑:2012年AlexNet在ImageNet竞赛中以端到端卷积网络击败手工特征工程方法,标志着这一范式的正式确立;2016年WaveNet以端到端方式生成高质量语音,淘汰了传统TTS的分段式流水线;2017年Transformer将端到端范式推广至序列建模。最早由Yann LeCun等人在卷积神经网络的图像识别研究中系统阐述,端到端方法指模型直接从原始输入映射到最终输出,中间无需人工设计的分步特征工程——传统机器学习流水线需要人工提取特征(如边缘检测、颜色直方图)再送入分类器,而端到端模型将特征提取与分类决策融合为一体,由梯度下降自动优化整个映射函数。
应用于AI Agent时,这一概念经历了从「感知端到端」到「行动端到端」的重要延伸:模型的输出边界从token序列扩展到真实世界的状态变化。这也与Yann LeCun所倡导的「世界模型」(World Model)概念在工程层面的早期实现相呼应——Agent需要对环境状态建立内部表征,并在此基础上规划行动序列。模型不仅能回答「怎么做」,还能自主调用外部工具(代码执行器、数据库、API)、感知执行结果并动态调整策略,直到任务完成。这与传统「聊天机器人」的本质区别在于:后者只是信息传递,前者是真正的任务执行者。
这一跃迁在技术上依赖于函数调用(Function Calling)和工具使用(Tool Use)能力的成熟。OpenAI于2023年6月正式引入Function Calling,允许模型以结构化JSON格式输出「函数调用意图」,再由外部系统实际执行并将结果返回给模型——这一机制的核心突破在于将模型从「文本生成器」转变为「意图解析器」:模型负责理解目标、规划步骤、选择工具,执行层由确定性代码完成,两者各司其职。
Function Calling的技术演进脉络: 2023年6月Function Calling引入后,经历了两次关键升级:其一是Parallel Function Calling(并行函数调用),允许模型在单次响应中同时发起多个工具调用,显著降低多步骤任务的总延迟——例如同时查询天气API和日历API,而非串行等待;其二是Tool Choice强制模式(Force Mode),允许调用方强制模型必须使用特定工具,提升了系统的可控性与可预测性,这对于需要严格审计的企业场景尤为关键。在此基础上,2024年引入的Structured Outputs功能进一步保证了函数调用参数的JSON Schema合规性,将工具调用的可靠性从「尽力而为」提升至「强制保证」——这一技术积累,与代码解释器、浏览器、文件系统等工具协同,共同构成了GPT-5.6实现「一次性完成端到端任务」的工程基础设施。
ReAct框架:Agent推理与行动的统一范式 Function Calling的工程落地,在学术层面对应的是2022年由谷歌研究院提出的ReAct(Reasoning + Acting)框架。ReAct将LLM的推理过程(Thought)与外部工具调用(Action)交织为统一的序列:模型先生成内部推理轨迹(类似「我需要先查询数据库,然后计算汇总」),再输出对应的行动指令,执行结果作为观察值(Observation)反馈给模型,驱动下一轮推理。这一「思考-行动-观察」的循环,正是当前所有主流AI Agent框架(LangChain、LlamaIndex、AutoGen)的核心架构原型。相比于纯粹的链式推理(Chain-of-Thought),ReAct引入外部知识源使模型能够突破参数记忆的局限,动态获取最新信息;相比于纯粹的工具调用,推理轨迹的显式化大幅提升了Agent行为的可解释性与可调试性——这两点共同决定了它成为生产级AI Agent架构标准的原因。
业界将这一能力跃迁称为从LLM(大语言模型)到LAM(大行动模型,Large Action Model)的转变——Rabbit等公司率先推广这一术语,强调模型能够直接操作GUI界面、调用OS级API,实现感知-规划-执行的完整闭环。LAM与LLM的根本区别在于:LLM的输出终止于文本,而LAM的输出终止于现实世界的状态改变;前者是信息传递者,后者是行动执行者。这一能力边界的进一步外延,正是GPT-5.6与早期版本最根本的代际差异所在——也是AI从「辅助工具」演进为「自主代理」的关键里程碑。
无论是主动读取数据库、独立调用工具,还是理解最终目标并自行规划路径,模型都展现出从「被动响应」到「主动完成」的转变。用户因此得以从繁琐的多轮调试中解放出来——过去需要不断纠错、补充、迭代,如今一次完整表述即可直达结果。
正如视频所总结的:「使用 5.6,你能做的事情比你想象的要多得多。」
从工具到生产力伙伴
从北海道的温室大棚,到纽约餐桌上的麦片生意,再到波兰的数学研究前沿,GPT-5.6 展示的不只是模型性能的提升,更是 AI 应用形态的深层演进。当 AI 能够自主完成端到端任务、并开始影响物理世界时,它的角色便从单纯的「工具」升级为真正的「生产力伙伴」。
说一下,以上案例均来自官方宣传视频,实际的模型能力边界、稳定性及在更广泛场景下的表现,仍有待第三方测试与更多用户的长期验证。但无论如何,GPT-5.6 所指向的方向——让 AI 真正落地、在现实世界创造可见价值——代表了当前大模型技术发展的重要趋势。
核心要点
核心要点
相关推荐
ChatGPT Space 发布:团队协作与 Pages 新功能解析
ChatGPT Space 是 OpenAI 推出的团队协作新功能,核心包含 Pages 页面、实时协作和 Slack/Google Drive 数据同步。本文解析其隐私设计、多平台集成与从对话到文档的完整工作流,帮助团队理解如何用 AI 统一项目管理与内容创作。

用AI Agent将Apache Spark UDF迁移到GPU加速
NVIDIA 开发者博客介绍如何用 AI Agent 将 Apache Spark UDF 重写为 GPU 加速版本,涵盖可迁移算子的判断标准、Agent 改写与验证流程,以及结果一致性、CPU-GPU 传输开销等落地陷阱。

Zed 编辑器 v0.40.4-rc2 发布:无需升级即可使用启动额度
Zed 编辑器发布 v0.40.4-rc2 候选版本,核心改动是允许用户在不升级付费计划的情况下使用启动额度(usage credits)调用 AI 功能,降低试用门槛。