AI真的能解数学难题吗?理性看待大模型科研突破

又一个"未解难题"被AI攻克?先别急着信
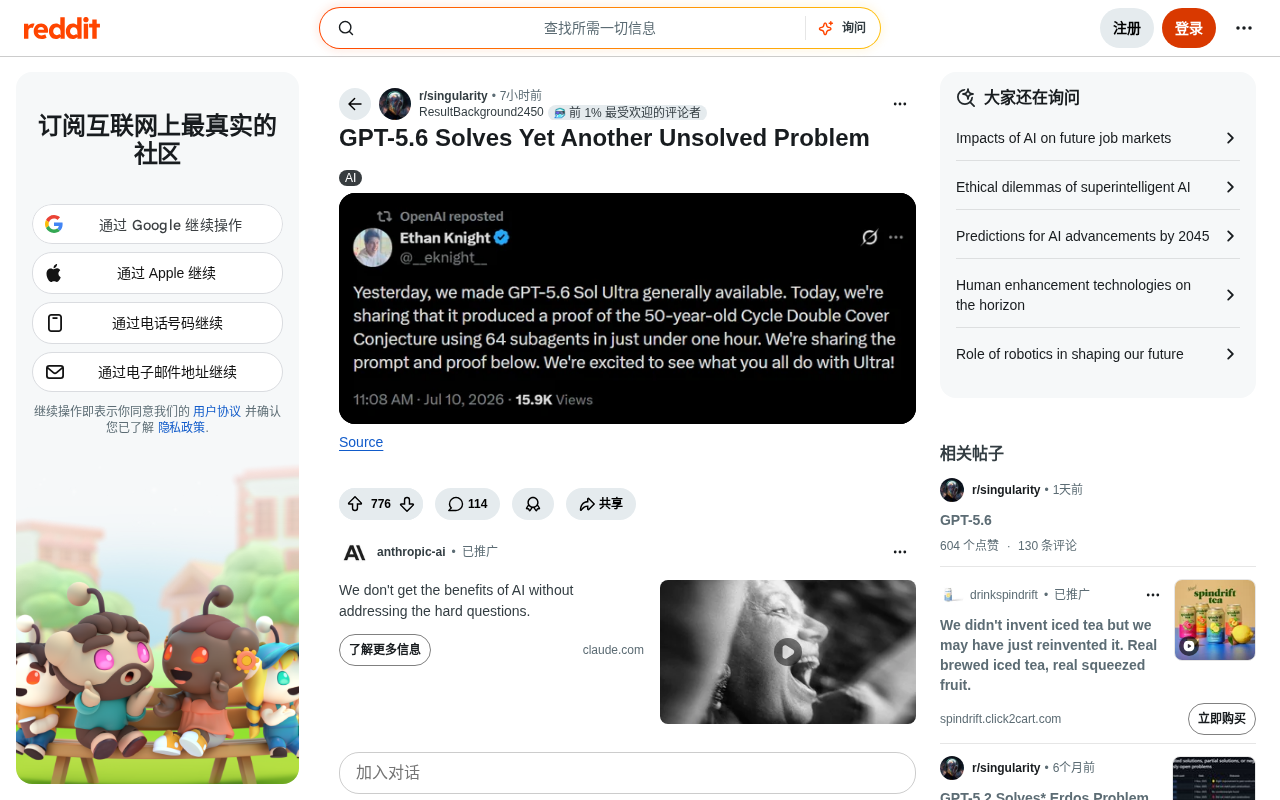
近日,Reddit社区流传一则引发热议的消息:"GPT-5.6 Solves Yet Another Unsolved Problem"(GPT-5.6又解决了一个未解难题)。这类标题往往能迅速点燃公众的想象力——大语言模型是否已经具备了突破人类知识边界的能力?
然而,作为长期观察AI领域的从业者,我们需要在兴奋之余保持一份清醒。此类声明频繁出现,但真正经得起学术审查的案例却屈指可数。本文将借这一话题,深入探讨大模型在数学与科研问题求解上的真实能力边界。
大模型"解题"究竟意味着什么
数学界对"解决未解难题"有严格定义
首先需要厘清一个关键概念:所谓"解决未解问题",在数学界有着极为严格的标准。一个真正的突破需要同时满足三个条件:问题本身是学界公认的开放问题、给出的证明逻辑严密无误、且能通过同行评审的检验。
很多在社交媒体上广泛传播的"AI攻克难题"案例,实际上属于以下几种情况:模型重新推导了已知但相对冷门的结论、给出看似合理实则存在逻辑漏洞的"证明",或是在人类专家大量引导下完成了部分推理步骤。这些成果的价值不容否定,但与"独立解决世界级难题"有着本质区别。
从AlphaProof到大模型推理:差距有多大
AI在数学领域确实取得了实质性进展。DeepMind的AlphaProof在国际数学奥林匹克(IMO)中达到银牌水平,OpenAI和Google的模型也在形式化证明上展现出潜力。这些系统通常结合了强化学习、形式化验证工具(如Lean)以及大规模搜索策略,而不仅仅依靠语言模型的"直觉"。
值得深入理解的是,形式化证明系统(如Lean、Coq、Isabelle)的工作原理与大语言模型有着根本差异。形式化系统要求每一个推理步骤都符合预先定义的公理体系,由计算机对每个推导环节进行机械化验证,不存在任何语义模糊或"跳步"——任何无效推导都会被系统直接拒绝。AlphaProof正是以Lean为后端验证工具,将神经网络的"猜想能力"与形式系统的"验证能力"结合,才实现了可信的数学推理。相比之下,对话式大模型输出的一段"证明文字",是基于统计模式生成的自然语言,无法保证每个步骤在逻辑上严格成立。两者的可信度完全不在同一量级。
为什么这类突破声明需要格外谨慎
幻觉问题在数学场景中尤为致命
大语言模型最广为人知的缺陷就是"幻觉"——以极其自信的口吻输出错误内容。要理解这一问题的根源:大语言模型的训练目标是最大化对下一个token(文字片段)的预测概率,本质上是一种极其复杂的"文本续写"机制。模型在训练中学会了什么样的数学表述"听起来合理",却无法真正区分"表述流畅的命题"和"逻辑上严格成立的命题"。这意味着模型完全可能生成一段结构完整、术语规范、语气笃定的"证明",但其中某个关键步骤实际上偷换了前提或跳过了必要条件。在数学证明这种对严谨性要求极高的场景,一个微小的逻辑跳跃或未经验证的假设,就足以让整个"证明"彻底失效。
更棘手的是,模型生成的错误证明往往在表面上极具说服力,普通读者甚至部分专业人士都难以第一时间察觉问题所在。这也是为什么Reddit等社区的截图声明,在未经权威验证之前,只能作为一条待考察的线索,而非可信的结论。
"GPT-5.6"版本号本身就存疑
"GPT-5.6"这样的版本命名也值得留意。OpenAI官方的产品命名体系与社区传言的版本号常有出入,网络上不乏基于臆测乃至调侃的内容。在缺乏官方发布说明、技术报告或可复现证据的情况下,对特定版本能力的断言应保持审慎态度。
理性认识AI的科研辅助价值
科研加速器,而非独立研究者
当前阶段,将大模型定位为"科研加速器"或"智能辅助工具"更为准确。它们能够快速检索文献、提出候选思路、辅助验证推导,甚至在结构化问题上提供启发性思路。已有数学家公开表示,AI在探索数学猜想、检查计算过程中提供了切实帮助。
但从"辅助人类思考"到"独立取得原创性突破",中间还有相当长的路要走。真正的科研突破需要问题定义、方法创新、严格验证的完整闭环,而这恰恰是当前大模型最薄弱的环节。
判断AI突破新闻真伪的实用框架
面对层出不穷的"AI攻克难题"消息,可以从以下几个维度进行独立判断:
- 是否有可复现的证据:论文、代码、形式化证明文件比单张截图可信得多;
- 是否经过同行评审:权威期刊或学术会议的认可是重要的可信门槛;
- 是否有独立第三方验证:多个来源交叉确认远比单一声明可靠;
- 发布渠道的权威性:官方技术报告与匿名社区帖子的分量截然不同。
结语:理性围观AI,才是真正的科技素养
"GPT-5.6解决又一未解难题"这样的标题,折射出公众对AI能力的高度期待,也暴露了信息传播中普遍存在的夸大倾向。我们既不应盲目否定AI在科研领域的真实进步,也不该被未经验证的耸动标题所左右判断。
真正值得持续关注的,是AI与人类协作解决复杂问题的可持续路径,以及形式化验证等工具带来的可靠性提升。在这个快速演进的领域,保持理性与批判性思维,或许才是我们面对每一则"重大突破"时最应具备的素养。
核心要点
相关推荐
B站最细Codex保姆级攻略:从安装到实战全解析
B站最细Codex保姆级攻略:从应用商店安装到日常工作模式配置,用真实咖啡馆项目演示文件整理、数据提取、仪表盘制作等实战任务,教你用计划模式和桌面宠物高效使用Codex。

体渲染中的外观补偿:为何RGB准确无法保证密度正确
体渲染研究揭示:完美复现外部RGB视图的体数据仍可能存在密度错误。外观补偿机制使中心密度翻倍、L2误差超14.52%时外部射线仍不变,密度恢复依赖外观容量、空间分辨率与测量设计。

TMLE与AIPW的样本分割选择:交叉拟合与重复分割的影响
一项TMLE与AIPW模拟研究发现,样本分割方式显著影响区间覆盖率:样本内拟合倾向得分可使覆盖率跌至0.12-0.48,双nuisance交叉拟合则恢复至0.91-1.00;近正性下AIPW优于未加权TMLE,重复划分降低划分依赖但使区间更保守。