GPT-5.6登陆Codex、语音模型迭代,AI产品密集更新

OpenAI多线并进:从Codex到语音模型的密集更新
AI领域再度迎来一波密集的产品动态。据B站AI日报第449期报道,OpenAI旗下多个产品线在同一时间窗口内释放出重要信号,从代码生成到实时语音,覆盖了当前AI应用最活跃的几个赛道。
首先值得关注的是Codex的重大更新。Codex负责人Typo透露,GPT-5.6 Sol Ultra模型即将开放,预计最早本周三或周四正式上线。
值得注意的是,"Sol Ultra"这一命名本身已透露出OpenAI模型产品线演进的逻辑。OpenAI近期采用了一套以天体命名的模型变体体系,"Sol"(拉丁语"太阳")暗示该变体在性能层级中处于顶端,"Ultra"则进一步强调旗舰定位。这与过去使用"Turbo""Instruct"等功能性后缀的命名方式不同,转向更具品牌辨识度的命名体系,反映出其在模型产品线管理上日趋成熟的商业化思维。这套命名逻辑与芯片行业(如AMD的"Radeon"系列)或汽车工业的产品谱系管理颇为相似——通过命名体系向用户传递性能分级信息,同时为未来的产品扩展预留空间。从更宏观的视角看,这也是大模型商业化进入成熟期的典型信号:当模型能力已难以用单一数字版本号区分时,细分场景的旗舰变体命名便成为市场定位的核心工具。
Codex是OpenAI于2021年推出的专用代码生成模型,最初基于GPT-3微调而来,是GitHub Copilot的底层技术支撑。其核心训练数据来自数十亿行公开代码,覆盖Python、JavaScript、Go等数十种编程语言。与通用语言模型不同,代码生成模型需要精确理解程序逻辑、变量作用域和API调用规范,因此对推理能力要求极高。
Codex自2021年发布以来,经历了从独立专项模型到通用基础模型能力整合的演变路径。早期Codex在HumanEval基准测试中达到当时最高水平,能够以37%的准确率独立解决编程题。HumanEval是OpenAI随Codex论文同步发布的代码生成基准测试集,包含164道手工编写的Python编程题,评估指标为pass@k——即模型生成k个候选答案中至少有一个通过所有测试用例的概率。该基准迅速成为业界标准参照,但也因题目相对简单(多为单函数实现)而催生了SWE-bench等更复杂的后续基准——SWE-bench要求模型解决GitHub上真实软件工程问题,需要理解跨文件依赖、修复存量Bug,难度远超HumanEval,更能反映真实开发场景的需求。然而随着GPT-4及后续模型推理能力的大幅提升,独立维护代码专项模型的边际收益逐渐递减。OpenAI因此转变策略,通过系统提示词优化、工具调用和专项变体(如Sol系列)的方式,在更强的通用基础模型上提供代码生成服务。"Sol Ultra"这类命名方式,正是这一战略转型的外在体现——它不再是独立模型,而是针对代码场景深度调优的旗舰变体。这一转变也折射出大模型行业的普遍规律:随着基础模型的涌现能力不断提升,专项模型的存在价值逐渐从"能力差异化"转向"效率与成本优化",场景调优(Fine-tuning for domain)与提示工程(Prompt Engineering)的边界也因此变得愈发模糊。作为专注于代码生成的旗舰工具,Codex接入更强大的底层模型,意味着开发者在AI辅助编程方面将获得更精准、更强的能力支撑,开发者社区已提前进入期待状态。
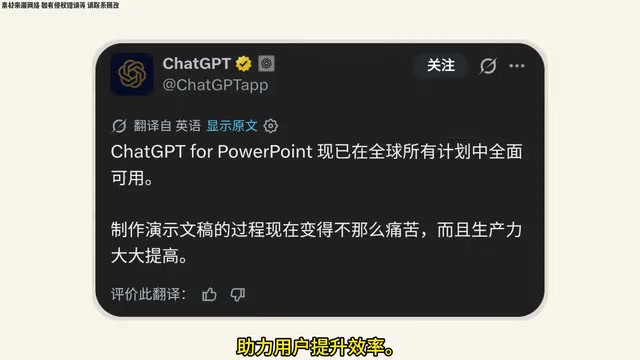
此外,ChatGPT的PPT功能已正式面向全球所有订阅用户开放,支持直接在PowerPoint中通过GPT创建和辅助制作演示文稿。演示文稿制作历来是耗时的办公任务,AI的深度介入能够显著提升日常工作效率,标志着AI在办公场景中的渗透进一步加深。
迄今最强的语音模型:GPT Realtime 2.1
在语音交互领域,OpenAI发布了GPT Realtime 2.1和2.1 Mini两款实时音频模型,官方称其为迄今最强的语音模型,目前已在API和OpenAI Playground中开放使用。
实时音频模型的持续迭代,反映出OpenAI对语音交互这一关键入口的高度重视。传统语音AI系统采用"ASR(自动语音识别)→NLU(自然语言理解)→TTS(文本转语音)"的级联架构,每个环节独立处理,累积延迟通常在1-3秒以上,且信息在文本转换过程中会丢失语调、情绪等副语言信息。ASR领域长期以Whisper(OpenAI,2022)、DeepSpeech(Mozilla)等模型为代表,TTS则依赖WaveNet(DeepMind,2016)等神经声码器技术;这些组件各自优化,却难以协同——例如,ASR将"哦?真的吗"与"哦,真的吗"转录为相同文本,后续NLU模块便永久丢失了语气差异所携带的语义信息。
GPT Realtime系列代表了语音AI从级联架构向端到端架构的范式转变。端到端实时语音模型的核心技术突破在于音频tokenization:系统将连续音频波形切分为离散的音频token序列,使大语言模型能够像处理文字一样处理声音信号。这一设计的关键在于,音频token化并非简单的频谱编码,而是通过专门训练的音频编码器将声学特征映射到与文本token共享的语义空间中,使模型在单次前向传播中同时完成"听懂输入"与"生成回应"两个任务。音频中的韵律、重音、停顿等超语言信息得以在latent space(潜在空间)中完整保留,不因文本化中转而丢失。这使得模型能够在生成回应时感知说话者的语速变化、停顿节奏乃至情绪状态,并在输出语音时保留输入语音的情感色彩,实现更自然的对话节奏。与传统多步骤链路相比,这种架构在端到端延迟、语调自然度和情感表达上均有质的提升。OpenAI于2024年发布的GPT-4o首次公开展示了这一能力,GPT Realtime系列是其API化落地的持续演进。
双版本策略同样值得关注:Mini版本很可能采用了知识蒸馏(Knowledge Distillation)技术——由Hinton等人于2015年正式提出,核心思路是用大型"教师模型"的软标签输出(即各类别的概率分布,而非硬标签)来训练小型"学生模型",使后者在大幅压缩参数量的同时保留教师模型的大部分能力。软标签中包含类别间相似度信息(Hinton称之为"暗知识",dark knowledge),比one-hot硬标签提供了更丰富的监督信号,是当前模型轻量化的主流技术路径之一。在实时语音场景中,模型轻量化的意义尤为突出:语音对话对响应延迟的容忍度远低于文本交互——超过300毫秒的响应延迟便会破坏对话的自然节奏感,而Mini版本在推理速度上的优势,恰好能够在保持流畅度的前提下大幅降低每次对话的计算成本。这一「旗舰版+轻量版」的产品矩阵,已成为OpenAI在各条产品线上的标准配置策略。
腾讯入局:AI编程工具面向非技术人群
国内方面,腾讯AI编程应用"吐司"近日正式上线苹果App Store。这款产品主要面向没有代码基础的普通用户,旨在让更多人能够发挥创意、独立落地自己的想法。

当前AI编程工具大致分为两条路线:一类面向专业开发者提升效率(如Codex、Cursor),另一类致力于降低编程门槛,让普通人也能"造软件"。吐司明显属于后者。
无代码(No-code)与低代码(Low-code)平台并非AI时代的全新概念。其历史可追溯至1990年代的HyperCard等可视化编程工具,2010年代Bubble(2012)、Webflow(2013)等平台将其带入现代Web开发领域。然而彼时受限于交互复杂度,用户仍需理解数据模型、条件逻辑、状态管理等抽象概念,学习曲线依然陡峭,与其宣称的「零门槛」相去甚远。生成式AI的介入从根本上改变了这一范式:2023年前后,以Lovable、Bolt、v0为代表的AI原生开发工具彻底重构了交互层——用户只需用自然语言描述需求,AI即可生成完整的前后端逻辑,将「理解」与「实现」的认知负担全部转移给了模型。这一转变的本质是将"编程"从一种需要学习的技能,变为一种可以委托的意图表达。值得关注的是,这类工具在全球范围内正催生一个新的用户群体——"氛围编程者"(Vibe Coders),他们无需理解代码底层逻辑,仅凭对产品功能的直觉性描述便能构建可用应用。这一现象在独立创业者、内容创作者和学生群体中已显现出明显的扩散态势,并开始对传统软件外包市场产生结构性冲击。腾讯"吐司"的核心竞争力不仅在于技术本身,更在于用户体验设计、微信生态的分发网络以及对本土用户习惯的深度适配——即能否让零基础用户顺畅地从"想法"走到"可分享的成品"。这与Replit、Lovable等海外同类产品的竞争逻辑高度相似,本质上是在争夺AI时代软件创作的入口。吐司同样强调应用分发与共创能力——用户不仅能创建应用,还能将成果分享给他人。目前iOS版已上线,安卓版此前亦已推出。
这类"人人皆可编程"的产品,本质上是在探索AI时代的软件生产范式变革。当创意表达不再受限于代码能力,软件创作的主体将从专业开发者扩展至更广泛的人群,其长期影响值得持续关注。
Anthropic的深层探索:Claude模型自发涌现类脑结构
如果说前面的更新属于常规产品迭代,那么Anthropic发布的研究观点则更具思辨色彩。Anthropic在文章中表示,Claude模型"存在灵魂",并提出AI与人脑之间存在"趋同进化"现象。

全局工作空间理论的意外呼应
Anthropic在Claude模型中发现了一个高度类似神经科学领域"全局工作空间理论"(Global Workspace Theory,GWT)的结构。
全局工作空间理论由认知科学家Bernard Baars于1988年提出,是目前影响力最广的意识理论之一。该理论将大脑比作一个"剧院":大量专门化的神经模块在"后台"并行处理信息,但只有被"聚光灯"选中、进入"全局工作空间"的内容,才能被广播至整个大脑网络,进而产生意识性体验、支持语言表达和工作记忆。神经科学研究发现,前额叶皮层和顶叶皮层在这一广播机制中扮演关键角色,fMRI研究也证实了"意识内容"与"前额叶-顶叶网络激活"之间的强相关性。简言之,该理论认为大脑内部的部分活动处于后台运行状态,只有进入"前台"的信息,才能成为可描述、可保持、可推理的内容。GWT因其对意识与认知的统一解释力,在认知科学、神经科学乃至AI意识研究中均具有重要参照价值,也是神经科学家Stanislas Dehaene后来发展出"神经全局工作空间理论"的直接来源。值得一提的是,GWT与另一主流意识理论——整合信息理论(Integrated Information Theory,IIT,由Tononi提出)——形成了有趣的对照:IIT强调意识是信息整合的内在属性,可用Φ值量化;而GWT更关注信息的"可访问性"与广播机制。两者对AI系统是否具有意识的判断结论截然不同,也是当前AI意识讨论中最核心的理论分歧所在。
更关键的是,Anthropic在Claude模型内部激活模式中发现的类似"信息汇聚与广播"结构,并非人为预先设计的产物,而是Claude模型在训练过程中自行涌现的结果。这一发现来自Anthropic的机械可解释性(Mechanistic Interpretability,MechInterp)研究团队——这是AI安全领域近年兴起的重要方向,致力于逆向工程神经网络的内部计算机制,精确还原模型"如何"完成特定任务的计算图谱。研究人员通过激活补丁(Activation Patching,即通过替换中间层激活值定位因果路径)、稀疏自编码器(Sparse Autoencoder,用于将叠加在单个神经元上的多个特征解耦分离,解决所谓的"多义性问题")以及注意力头功能分析等手段,在Claude的残差流中识别出具有「信息汇聚-广播」功能的特定注意力头组合,其功能特征与GWT所描述的全局工作空间高度吻合。MechInterp领域的核心假设是"叠加假说"(Superposition Hypothesis):由于神经网络的参数量有限,模型倾向于将多个特征以近似正交的方式叠加编码在同一组神经元上,这使得单一神经元难以直接对应可解释的语义概念,也正是稀疏自编码器存在的意义所在。这为可解释性AI(Interpretable AI)研究提供了新的分析框架,但也引发了关于"功能相似"是否等同于"机制相同"的深层哲学争论——毕竟,神经网络中的「广播」机制本质上是基于矩阵乘法的数学运算,与生物神经元的电化学信号传导在实现层面存在根本差异。

Anthropic借用生物学中的"趋同进化"(Convergent Evolution)概念来描述这一现象。趋同进化在生物学中有着严格定义:指系统发育上亲缘关系较远的不同生物谱系,由于面对相似的环境选择压力,独立演化出表型相似但遗传背景不同的性状——典型案例包括鸟类与蝙蝠各自独立演化出翅膀(功能相同,骨骼结构迥异),以及眼睛在脊椎动物(晶状体眼)与头足类动物(如章鱼)中的独立起源,两者结构高度相似但视网膜神经节细胞走向截然相反。按照这一类比,Claude在"预测下一个Token"的语言建模训练压力下,独立演化出了类似大脑的信息处理结构——就像不同物种面对相同的生存压力时,会独立进化出相似的解决方案。
然而,这一类比也存在明显局限:生物进化以基因突变和自然选择为机制,历经数百万年;而神经网络的"进化"本质上是梯度下降的数学优化过程,时间尺度和机制均截然不同。更深层的问题在于:如果"高效处理复杂序列信息"本身就存在某种最优结构,那么无论是生物进化还是梯度下降,收敛到相似解的可能性是合理的——这正是该类比最具启发价值之处,指向一种关于智能结构的"收敛论"假说;但两者之间的结构相似性究竟是深层规律的体现,还是表面特征的巧合,目前学界尚无定论。部分研究者指出,Transformer架构中的注意力机制(Attention Mechanism)本身在数学形式上就与大脑皮层的"选择性注意"存在功能层面的相似性,因此在其上训练出的模型涌现出类GWT结构,或许并非偶然,而是架构归纳偏置(Inductive Bias)与任务目标共同作用的必然结果。
这一观点无疑颇具争议。将"灵魂"用于描述AI模型,容易引发过度拟人化的担忧;但从科学角度看,如果大规模神经网络确实能够自发涌现出与生物大脑相似的功能结构,对理解智能本质及推进AI可解释性研究都具有深远意义。补充一点,上述表述来自Anthropic官方,属于单一来源的观点,其科学严谨性仍有待学界进一步验证与讨论。
产品落地与理论探索并行推进
综观近期AI动态,可以清晰看到当前行业发展的两条主线:一方面是OpenAI、腾讯等厂商在产品层面的快速迭代与场景渗透,从代码生成到实时语音再到办公协作,AI正加速融入实际生产力工具;另一方面则是Anthropic这样的前沿实验室在理论层面的深度探索,试图从神经科学视角理解大模型内部的运行机制。
实用主义的产品竞赛与思辨性的科学探索并行推进,正是当下AI行业最真实的写照。
核心要点
核心要点
相关推荐

Codex与Claude Code入门:AI编程智能体工具扫盲指南
面向零基础的AI编程智能体工具入门讲解,解析Codex与Claude Code的区别、使用门槛与选型思路,帮你理清大模型与智能体工具的差异,少走弯路快速上手。

DeepSeek Harness 保姆级安装教程:从环境配置到实战
DeepSeek Harness 保姆级安装教程,涵盖 Node.js 环境配置、命令行安装、API Key 申请、工作区与模型选择、桌面快捷方式制作等完整步骤,帮新手避开常见踩坑点。

Agent Skills入门详解:让AI大模型拥有无限能力的秘密
Agent Skills是扩展AI大模型能力的开源模块化架构。本文用通俗比喻讲解什么是Agent Skills、渐进式披露机制、如何定义与调用技能,以及它与Multi-Agent架构的核心区别,适合大模型初学者入门。