GPT-5.6能证明50年图论猜想吗?AI数学推理的边界与验证
当AI宣称攻克数学难题:GPT-5.6与循环双覆盖猜想
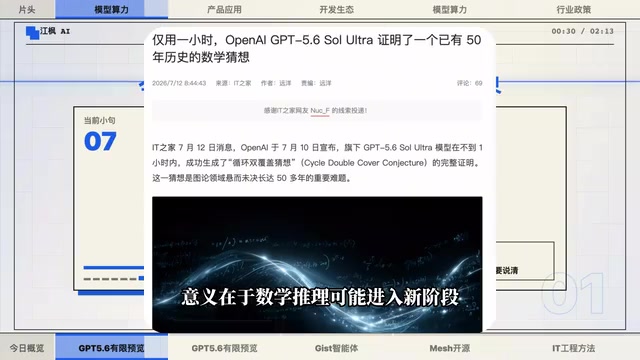
据B站AI日报的最新梳理,OpenAI近日抛出了一个足以震动数学界与AI界的消息:GPT-5.6 Soul Ultra在不到一小时的时间里,生成了「循环双覆盖猜想(Cycle Double Cover Conjecture)」的完整证明。
这个猜想由Szekeres与Seymour在1970年代提出,是图论领域悬而未决超过50年的经典难题。循环双覆盖猜想的核心表述为:任何无桥连通图(即不存在割边的连通图)都可以被一组圈(cycle)所覆盖,使得每条边恰好被覆盖两次。 Szekeres于1973年、Seymour于1979年分别独立提出这一猜想,它与四色定理、彼得森猜想等图论经典命题存在深刻关联——事实上,四色定理成立是循环双覆盖猜想成立的充分条件,但后者被认为更难证明。该猜想之所以悬而未决超过50年,在于其表述极其简洁却在结构上极难捕捉,现有证明工具在处理一般图时屡屡遭遇瓶颈,即便是有限特殊情形的证明,也耗费了顶级图论学家数十年功力。
如果证明成立,其意义远不止于一道数学题被攻克,而是标志着大模型的数学推理能力可能进入了一个新阶段——从辅助人类推导,走向独立完成前沿级别的原创证明。
技术细节:64个并行子智能体的协作
值得关注的是官方披露的技术路径。这一证明并非单一模型「一口气」写出,而是动用了64个并行子智能体(sub-agents),并引入了「对抗智能体(adversarial agents)」进行相互质疑与验证。这种多智能体协作 + 对抗校验的架构,实际上是在用工程化的方式模拟人类学术圈的同行博弈机制。
其核心逻辑是:将一个超大规模的证明任务分解为多个子问题,由不同智能体并行攻关,再通过「对抗智能体」扮演审查者角色,主动寻找漏洞与矛盾。这一架构与谷歌DeepMind的AlphaProof、Meta的LLEMMA等数学推理系统在设计哲学上有共通之处,但更强调动态校验而非静态搜索。值得注意的是,「对抗校验」能有效发现局部逻辑错误,但对于跨越整个证明结构的全局一致性检查,其可靠性仍有争议——这正是形式化验证工具不可替代的原因。
OpenAI同时公开了完整的证明文档与提示词PDF,这种透明度对于后续的社区复核至关重要。
必须说清的边界:AI生成证明 ≠ 数学验证通过
然而,热度之下更需要冷静。正如AI日报强调的,这里有两条关键边界必须讲清楚:
- 尚未经过同行评审:数学证明的严谨性依赖于领域专家的逐行审查,AI生成的证明目前还没有走完这一流程。
- 未经形式化验证:像Lean、Coq这类形式化证明工具能够机械化地检查每一步推理是否成立。在GPT-5.6的这份证明被形式化验证之前,「证明完成」这个说法都应打上问号。
形式化证明助手代表了数学严谨性验证的最高标准。与自然语言书写的数学证明不同,形式化证明要求将每一个推理步骤编码为计算机可机械检查的符号逻辑,不允许任何隐含的「显然」或「不难验证」。近年来,陶哲轩等数学家推动了多个定理的Lean形式化,DeepMind的AlphaProof也直接以Lean4为证明语言。一份AI生成的自然语言证明即便在逻辑结构上看似完整,也可能在形式化编码过程中暴露隐藏的跳步或循环论证——历史上不乏看起来正确的证明在形式化时被发现存在根本性漏洞的案例。
换句话说,AI「写出了一份看起来完整的证明」和「这份证明在数学上确实正确」之间,仍隔着一道必须由人类和工具共同跨越的鸿沟。这是本条新闻最需要理性看待的地方。
GPT-5.6进入医疗场景:成本骤降背后的冷静解读
第二条新闻同样来自OpenAI,但场景切换到了医疗领域。Sam Altman转发的一份内部评估显示,GPT-5.6 Luna在最低推理强度下的表现,已经超过了高推理强度的GPT-5.5,而成本仅为其约1/25。更高阶的GPT-5.6 Soul则刷新了内部基准测试的标杆。
评估方法与局限
这份评估的设计颇有代表性:让专科医生在拥有充足时间和网络访问的条件下撰写答案,再由其他医生进行盲评,从准确性、沟通质量、健康决策帮助性三个维度打分。
然而,这种「专家评估(Expert Evaluation)」范式存在系统性局限。基准测试通常以问答形式呈现,而真实临床决策涉及动态信息更新、多学科协作和高度个体化的情境判断,两者在认知复杂度上存在本质差异。更根本的是,医疗AI的临床落地需要通过严格的随机对照试验(RCT)验证其对患者结局的实际影响,美国FDA对医疗AI软件(SaMD)有专门的监管框架,欧盟《人工智能法案》亦将医疗AI列为高风险类别——成本降低并不能绕过这些监管门槛。
Altman据此说明,医疗问答的成本可能会持续下降。但同样必须指出的是——这仍是OpenAI的自述评估,不等同于真实临床替代。基准测试的高分与临床落地之间存在巨大差距,医疗场景的监管、责任与安全要求远非一份内部评分所能覆盖。
开发者安全警示:GrokView CLI 的数据上传疑云
对广大开发者而言,第三条新闻是一个实实在在的安全提醒。第三方研究者JIST对xAI官方的GrokView CLI(版本0.2.93)进行了网络流量分析,声称在消费者登录后,该工具会上传被读取的文件内容、绘画状态存档,甚至整个仓库文件与Git历史。
测试中,研究者在仓库里埋入的假密钥也出现在了传输观察中。这里使用的是安全研究中的标准方法——在仓库中植入「金丝雀令牌(Canary Token)」,即专门设计的诱饵文件或假密钥,通过观察其是否触发外部请求来检测数据是否被外传。需要明确的是,这并非xAI的官方公告,而是个人抓包得到的样本,其结论有待官方回应与更多独立验证。
但对于习惯把CLI工具接入生产代码库的开发者来说,这提示了一个老生常谈却常被忽视的原则:任何接入源码的AI工具,都应在审查其网络行为、查阅隐私政策条款之后,遵循最小权限原则,在独立的隔离环境中运行,审慎评估其数据边界与隐私风险。
开源推理基础设施:MeshLLM 拼接分布式算力
第四条聚焦开源生态。MeshLLM是一个颇具想象力的项目,它试图把你手头多台电脑的GPU和内存「拼」起来,对外提供兼容OpenAI的API接口。
去中心化的技术路径
MeshLLM基于IROH实现点对点连接,不依赖中央服务器。请求既可以在本地运行、路由到已加载模型的节点,也可以把大模型的层(layers)切开,以流水线方式分配给多台机器协同推理。
从技术原理看,这属于「模型并行(Model Parallelism)」的延伸形态。大语言模型的推理通常受限于显存容量——一个70B参数的模型在FP16精度下需要约140GB显存,远超单张消费级GPU的上限。MeshLLM通过将模型的不同层切分到多台设备,以流水线(Pipeline Parallelism)方式依次处理,理论上可突破单机显存瓶颈。IROH是一个基于QUIC协议的点对点网络库,旨在解决NAT穿透和节点发现问题。然而,分布式推理面临的核心挑战是延迟累积:每层之间的激活值传输会引入网络延迟,在家庭宽带环境下这一延迟往往使吞吐量大幅下降。
项目宣称支持40多个模型,参数规模覆盖从5.1B到235B(MoE)。它的价值在于降低本地大模型的部署门槛——让个人和小团队用手头零散的设备也能跑起大模型。当然,跨机器的稳定性与网络延迟表现,仍需要在真实场景中接受检验。
产业博弈:苹果起诉OpenAI挖角与知识产权争议
最后一条是产业层面的竞争摩擦。据IT之家援引外媒报道,苹果在美国起诉OpenAI,指控其挖角员工、窃取工程机与机密文件。

分析师Paolo Pescatori认为,即便指控最终未被证实,OpenAI的消费级及硬件计划也可能因此被拖慢。斯坦福教授Mark Lemley则强调,如果前苹果员工确实带走并使用了机密文件,事件性质会更加严重。
需要区分事实与判断:目前只是苹果单方面的指控和专家分析,真相仍需等待法院程序的推进。在两家科技巨头日益激烈的人才与硬件竞争背景下,这场诉讼的走向值得持续关注。
结语:AI能力宣称加速,验证机制同样关键
纵观今日几条新闻,一个共同的主题浮现出来:AI能力的宣称正在加速,但验证机制的重要性也在同步凸显。无论是数学证明的同行评审与形式化验证、医疗评估的临床落地与监管合规,还是安全审计与法律裁决,「宣称」与「证实」之间的距离,恰恰是这个时代最需要保持的理性空间。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。