GPT-5.6三模型架构解析:Sol/Terra/Luna定价与性能全览

GPT-5.6:从单一模型到三模型架构
根据网络公开信息与B站UP主DP的汇总分析,OpenAI已正式公告GPT-5.6的发布计划。你可能没注意到,本文涉及的价格、模型命名等细节多来自网络传闻与个人推测,最终仍以官方文档为准。
与以往的单一模型发布不同,GPT-5.6最大的变化在于它并非一个模型,而是三个模型的组合——分别命名为 Sol(太阳)、Terra(地球)、Luna(月亮)。这种以天体命名的分层策略,暗示了三个模型在能力与定位上的梯度关系:Sol 定位旗舰,Terra 面向日常,Luna 处理轻量任务。
这种多模型架构反映了当前大模型厂商的共同趋势:不再追求「一个模型打天下」,而是通过差异化定位,让用户根据任务复杂度选择合适的算力档位,在性能与成本之间取得平衡。事实上,Anthropic的Claude系列(Haiku/Sonnet/Opus)、Google的Gemini系列(Flash/Pro/Ultra)均已采用类似设计。
这种架构背后的核心工程逻辑是模型蒸馏(Model Distillation)。蒸馏技术由Geoffrey Hinton等人于2015年在论文《Distilling the Knowledge in a Neural Network》中系统化提出,其核心洞察在于:神经网络输出层的概率分布(而非仅仅是最终的one-hot标签)包含了大量关于类别间关系的隐含信息。例如,对于手写数字识别任务,教师模型对"7"的预测输出中,"1"和"9"的概率往往高于其他数字,这种微小的概率差异就携带了"7与1、9形状相似"的结构化知识——这正是Hinton所称的暗知识(Dark Knowledge)。在大语言模型时代,蒸馏技术已演化出序列级蒸馏(Sequence-Level KD)、特征级蒸馏(Feature-Level KD)以及基于RLHF的偏好蒸馏等多种形态。其基本原理是用大型「教师模型」(Teacher Model)生成的软标签(Soft Labels)或中间层特征,来训练更小的「学生模型」(Student Model)。与直接从头训练小模型相比,蒸馏后的学生模型能够吸收教师模型的暗知识——即隐藏在概率分布中的类间相似性信息——从而在参数量大幅缩减的情况下保持较高性能。在大语言模型领域,蒸馏通常还结合了强化学习与人类反馈(RLHF)以及合成数据生成:旗舰模型先生成大量高质量推理轨迹和答案,再以此为监督信号微调小模型。这正是 Terra 能以 50% 的价格实现接近旗舰能力的技术根基——它本质上是站在 Sol 肩膀上的高效压缩版本。
思考强度:新增Max与Ultra两档
除了模型数量的变化,GPT-5.6在「思考强度」(Reasoning Effort)层面也进行了扩展。以往的 Low、Medium、High、X-High 四档得到保留,并在此基础上新增了 Max 和 Ultra 两个更高档位。
Reasoning Effort 本质上是控制模型「思维链」(Chain of Thought)深度的参数。思维链推理由 Wei 等人于 2022 年在论文《Chain-of-Thought Prompting Elicits Reasoning in Large Language Models》中正式提出,核心发现是:让模型在给出最终答案前先输出中间推理步骤,可以大幅提升复杂数学和逻辑问题的准确率。值得注意的是,研究者还发现了一个关键的"涌现能力"(Emergent Ability)门槛:CoT推理能力只在参数量超过约100B的超大规模模型中自发涌现,小模型即使使用相同的提示格式也几乎无法受益,这也从侧面解释了为何需要先有强大的旗舰模型,再通过蒸馏传递推理能力给轻量模型。OpenAI 的 o 系列模型(从o1开始)进一步将这一思想内化为训练目标,通过强化学习让模型自主学习何时需要深入推理、何时可以快速响应,形成了动态分配推理预算的能力——这与早期"固定步骤CoT提示"有本质区别,也形成了「思考Token」(Thinking Tokens)机制——模型在回复用户前会先在内部进行大量推理,这些推理步骤对用户不可见,但消耗真实算力。Reasoning Effort 参数本质上是控制这个内部推理预算(Budget)的旋钮:档位越高,模型被允许消耗的思考 Token 上限越大,对超长数学证明、多步代码调试等任务的解题能力越强,但每次请求的延迟(Latency)和 Token 成本也相应线性乃至超线性增长。Max 与 Ultra 两档的加入,意味着对于极端复杂的推理任务,开发者现在拥有了更大的「算力旋钮」可以拧,也标志着 OpenAI 正在将极端算力推理能力作为独立产品维度开放给开发者。
这一推测并非空穴来风。据DP考证,官方 GitHub 上的 Codex CLI 0.143.0 版本中,已明确出现了 5.6 的三个模型及 Max 思考强度;同时有文章说明 Ultra 模式将出现在 Codex 中。一张疑似 Codex 的截图里出现了「5.6 + Sol + Ultra」的组合,与前述线索相互印证。
对开发者而言,更高的思考强度意味着模型处理复杂推理任务时可投入更多算力,但也会带来更高的延迟与成本,需根据实际场景权衡取舍。
价格策略:变相半价与缓存写入涨价
价格是本次更新最受关注的部分。以 GPT-5.5 作为基准(约为输入5、输出30),GPT-5.6 三个模型呈现清晰的价格梯度:
- Sol:与 5.5 完全一致,约 5/30,定位旗舰
- Terra:约为 Sol 的一半,2.5/15
- Luna:约为 Sol 的 17%,1/6,主打轻量
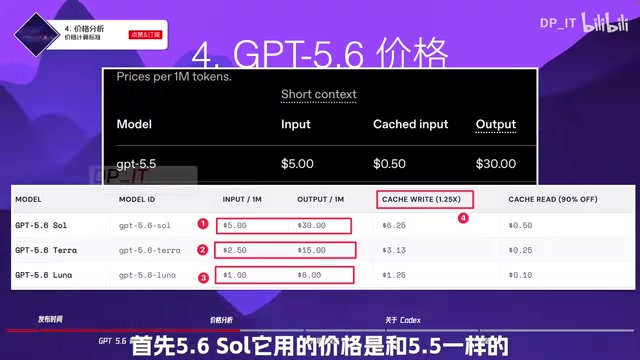
这里有一个关键洞察:Terra 以 5.5 一半的价格,据称实现了接近 5.5 的工作能力。如果属实,这相当于变相为主力模型「打了半价」——用户可以用一半成本获得与旧旗舰相当的表现,对成本敏感型开发者极具吸引力。
不过,DP 特别提醒了一个容易被忽视的细节:缓存写入(Cache Write)价格从 5.5 的 100% 上涨至 125%,即以 Sol 为例从 5 涨至 6.25。
要理解这一变化的影响,需要了解 Prompt Cache 的底层机制。KV缓存(Key-Value Cache)是Transformer架构中解决推理效率瓶颈的核心工程优化。在标准自注意力计算中,每生成一个新Token都需要重新计算所有历史Token的Key和Value矩阵,计算复杂度随序列长度二次增长。KV缓存通过持久化存储这些中间计算结果,将增量生成的复杂度降至线性。在云服务场景中,跨请求的Prompt Caching进一步将这一优化延伸到会话边界之外——当用户多次发送具有相同前缀(如 System Prompt)的请求时,服务器可以持久化存储这些 KV 矩阵,使后续请求直接读取已缓存的结果(即「缓存命中」),从而以约 50% 的折扣完成计费。值得注意的是,缓存写入涨价还反映了一个现实的工程压力:支持超长上下文(如128K Token)的新模型中,单次缓存写入的存储开销可比早期模型增加数十倍,服务端的存储和内存管理成本显著上升。缓存写入则是指首次将前缀内容写入缓存存储时的额外开销,涉及额外的存储操作和内存占用。对于 Agentic 工作流,System Prompt 通常包含大量工具定义、角色描述和任务背景,单次写入量极大;且在 Agent 循环(Loop)的每轮迭代中,随着对话历史增长,缓存写入操作也会持续触发。因此缓存写入从 100% 涨至 125%,对 Agent 开发者和高频 API 用户的实际成本影响,远比普通对话场景显著——这恰恰是重度 API 用户最常见的使用模式。缓存读取等其他项目则保持不变。对于高频写入缓存的工作流,这一变化仍需纳入成本核算。
使用场景推测与Codex集成
基于价格分层,各模型的适用场景也随之明确。以下为DP的个人推测,仅供参考。
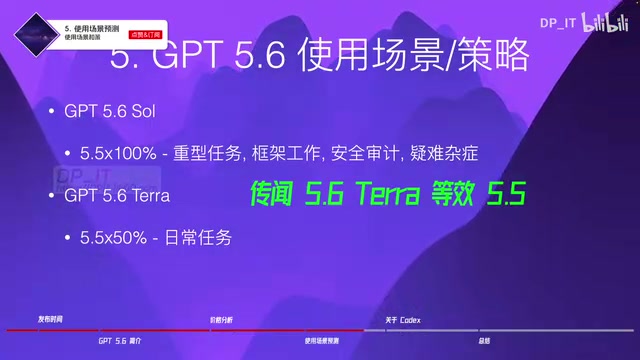
Sol:重型任务的旗舰选择
Sol 以 5.5 的 100% 价格提供,适合框架级别的架构设计、安全审计,以及难以攻克的复杂问题。这类任务对准确性要求极高,值得投入最高档位的算力。
Terra:日常开发的性价比主力
Terra 以 50% 的价格覆盖日常开发任务,是大多数场景下的最优选择。其定位本质上是「用 5.6 的技术实现 5.5 的能力,只需一半价格」。这背后是模型蒸馏技术成熟度持续提升的直接体现——当蒸馏流程足够精良,学生模型甚至可以在特定任务上超越教师模型的早期版本,而非仅仅"接近"。
Luna:轻量与批量任务专属
Luna 以约 17% 的价格处理轻量任务,例如用 Subagent 跑测试这类高频、低复杂度的工作,可显著降低整体 API 调用成本。
在 Codex 集成方面,从疑似 Pro 顶配版的截图可见,模型列表相当完整:从 5.3 Codex、5.4 Mini、5.4、5.5,一直到三个 5.6 模型(Sol、Terra、Luna)。从 5.4 开始的模型均带有加速(Fast)标记,可开启 Fast 模式。截图中 5.6 Sol 除 Low/Medium/High/X-High 外还出现了 Ultra 选项,再次印证了 Ultra 将在 Codex 中可用的推测。
算力问题:性能好评背后的隐忧
在为价格与性能欢呼之余,有一个现实问题不容忽视——算力供给的稳定性。据DP描述,GPT-5.5 曾因算力紧张、降智等原因「几乎处于不可用状态」,许多用户甚至停下工作专门等待 5.6。
这里存在一个明显的分歧点:如果 5.6 发布后算力能够跟上,凭借更低价格与更强性能,几乎必然迎来「好评如潮」;但若再次出现算力紧张与降智,再优秀的模型也难以发挥价值。DP 坦言无法确定算力是否会恢复,也无法预测下一轮紧张何时到来。
值得注意的是,三模型架构在一定程度上有助于缓解算力压力——通过引导低复杂度请求流向 Luna、中等复杂度请求流向 Terra,可以将 Sol 的算力资源集中释放给真正需要旗舰能力的任务。这种需求分流本身也是多层次架构的工程价值之一,但其效果最终仍取决于底层GPU集群的总供给规模。
评价一个大模型不能只看纸面上的价格与性能参数,实际服务的稳定性同样是决定生产力的关键因素。对于依赖 API 完成关键工作的团队,算力波动带来的风险不可低估。
总结
综合来看,GPT-5.6 的核心亮点可以概括为「用更低的价格提供更好的性能」。Sol/Terra/Luna 三模型架构配合新增的 Max、Ultra 思考强度,为不同任务提供了更细粒度的选择;Terra 的「变相半价」策略尤其值得关注——这背后是模型蒸馏技术成熟度持续提升的直接体现,从Hinton 2015年提出"暗知识"概念,到如今能够将千亿参数旗舰模型的推理能力高效压缩并商业化落地,蒸馏技术的工程化进展正在重塑大模型的成本结构。
但需清醒认识到:本文大量信息来自网络传闻与个人推测,最终以官方文档为准;缓存写入涨价(尤其对 Agentic 工作流影响较大)以及最关键的算力稳定性,都是正式使用前应当权衡的因素。模型能力再强,也需要充足且稳定的算力作为支撑,才能真正转化为实际生产力。
相关推荐

AI+SRC自动化挖洞实战:用AI智能体重构漏洞挖掘三步法
本文详解AI+SRC自动化漏洞挖掘的完整思路,对比传统挖洞三步法与AI智能体加持后的变化,涵盖资产盘点、误报筛选、报告生成及AI Agent选型要点,助你高效入门SRC漏洞挖掘。

实测DeepSeek桌面Agent:0.35美元自动生成视频
海外博主实测DeepSeek桌面Agent(DeepSeek Harness):仅0.35美元自动生成完整视频,设置每日自动简报,两分钟从大白话构建可运行App。三项任务全部完成仅花0.59美元,附详细表现与成本分析。

Antigravity 2.0 保姆级教程:MCP、Skill与自动化全解析
Antigravity 2.0 保姆级教程,详解项目/会话/Agent 三大核心概念、消息队列与权限设置、自动化任务、MCP 连接 Figma、Skill 专业技能,并演示设计稿转代码、Android 应用生成、产品页 1:1 复刻等 6 个实战案例。