GPT-5.6三款模型深度实测:SOL/TERRA/LUNA性能与定价全解析

OpenAI悄然预览GPT-5.6:SOL、TERRA、LUNA三剑客
OpenAI于6月26日正式宣布了GPT-5.6系列模型,目前仅通过API向少数合作伙伴开放预览,并已在Codex中小范围部署。据官方说法,全面推出将在数周内完成。
这一系列包含三款定位不同的模型:**SOL(旗舰版)**主打最强性能,**TERRA(均衡版)**面向日常工作场景,**LUNA(速度版)**则追求极致的响应速度与成本效益。这种「按能力分层」的命名逻辑,让人不禁联想到Anthropic近期的产品策略——事实上,AI大模型的「能力分层」产品策略正在成为行业标配。Anthropic率先以Haiku(轻量)、Sonnet(均衡)、Opus(旗舰)三级架构建立市场标准,Google则以Gemini Flash/Pro/Ultra延续这一逻辑。这种分层本质上是将同一底层能力按推理深度、上下文窗口和计算预算切割,以满足从个人开发者到企业级部署的不同成本敏感度。OpenAI此前以GPT-4o mini/GPT-4o的双轨策略运营,此次GPT-5.6引入三档命名,是向行业主流分层架构的主动靠拢,也意味着其产品矩阵正从「单一旗舰」向「平台化生态」演进。
一个值得关注的细节是:OpenAI在发布前就向美国政府展示了这些模型的能力,并因政府要求采取了分阶段发布——这在OpenAI的历史上尚属首次。此举强烈暗示了新模型在特定领域(尤其是网络安全)存在明显的能力跃升。这与美国AI安全行政令对高风险能力模型的监管预期高度吻合,也预示着AI能力监管将进一步常态化。
定价策略:三款模型全线下探,成本竞争力显著提升
从官方公布的基准数据来看,SOL在Terminal Bench 2.1上达到业界领先水平。Terminal Bench 2.1是专门评估AI模型在命令行环境下完成复杂工作流的能力基准,核心考察维度包括:多步骤任务规划、Shell脚本迭代调试、跨工具协调(如同时调用curl、grep、awk等系统工具)以及错误恢复能力。这类基准的兴起,折射出AI Coding Agent从「代码补全」向「自主完成端到端开发任务」演进的行业趋势。SOL在GenNet测试中表现同样亮眼。
更值得关注的是,在专注于网络安全漏洞分析的Exploit Bench上,SOL的表现能与Anthropic的Codex相媲美,但输出Token量仅为后者的三分之一左右——这揭示了一个重要的模型能力维度:推理密度。传统评估框架往往只看准确率,但在实际生产环境中,完成相同任务所消耗的Token数量直接决定API调用成本。以每百万输出Token $30计算,若SOL仅需竞品1/3的Token即可完成等效任务,实际综合成本可能与定价更低的模型相当甚至更优,同等任务下SOL的成本效率显著更高。
新版本还引入了「最大推理能力」和「超模式」,后者可调用智能体处理复杂的多步骤工作流。
定价方面,三款模型的策略相当积极:
| 模型 | 输入(每百万Token) | 输出(每百万Token) |
|---|---|---|
| SOL | $5 | $30 |
| TERRA | $2.5 | $15 |
| LUNA | $1 | $6 |
OpenAI表示,TERRA相比GPT-5.5更具竞争力且售价降低约一半。三款模型均支持通过明确的缓存断点优化提示缓存,最低缓存时长达30分钟。提示缓存(Prompt Caching)是大模型API服务中一项关键的成本优化技术——当系统提示或长上下文前缀在多次请求中保持不变时,服务端可缓存这部分内容的KV注意力计算结果,后续请求直接复用缓存,避免重复计算,从而显著降低延迟和费用。GPT-5.6引入「明确缓存断点」机制,允许开发者主动标注缓存边界,相比此前隐式缓存更可控。30分钟的最低缓存时长意味着高频调用的企业应用(如客服Bot、代码审查流水线)可在单次会话窗口内持续享受缓存红利,对于上下文窗口动辄数万Token的长文档处理场景,节省幅度尤为可观。企业端上线时最高可达每秒约750个Token,在实时应用场景中具有明显优势。
实测表现:后端任务大幅领先,前端视觉仍是短板
本次测试使用自研基准套件PinBash 3对三款模型进行评估,内容涵盖前端任务、Three.js相关内容、数学难题及自适应微调任务。
最终得分如下:
- SOL:约78.6%
- TERRA:约62.9%
- LUNA:约44.3%
单看总分,SOL的78.6%似乎只是中等水准,但拆解细项后,能看到更有价值的信息。
数学与后端任务:三款模型集体达到新高度
在数学难题上,SOL和TERRA均拿到满分10分——这是很少有模型能达到的成绩。在自适应微调任务上,三款GPT-5.6模型全部满分,连最低配的LUNA都流畅完成了数据集生成、模型微调乃至配套UI全流程,表现毫无瑕疵。
作为对比,此前的GPT-5.5乃至Opus 4.7在同一任务上仅能拿到两三分。这表明在算力密集型工作和后端任务中,GPT-5.6系列实现了实质性的飞跃。
前端与视觉任务:OpenAI的传统短板依然存在
然而在前端与视觉任务上,情况截然不同。Three.js动画、SVG图形等考验视觉还原质量的题目,模型普遍只能拿到六七分,而竞品Fable 5则能稳定达到九到十分。
OpenAI在前端与视觉生成类任务上的持续落后,有其深层的技术成因。Three.js动画、SVG图形等任务要求模型在生成代码时同步保持对「视觉空间逻辑」的感知——例如理解坐标系变换、颜色渐变曲线、动画插值的视觉效果,而非仅仅输出语法正确的代码。这要求模型在训练数据中大量摄入「代码-渲染效果」的配对样本,并建立从代码表征到视觉表征的跨模态映射。Anthropic的Fable系列在这一维度上积累了明显优势,被业界认为与其在多模态对齐数据上的长期投入有关。对于OpenAI而言,这一差距短期内难以仅靠扩大参数规模弥补,需要在数据飞轮和训练目标设计层面做出针对性调整。

需要说明的是,本次基准测试对前端与视觉任务的权重较高,因为这类任务最能直观体现质量差异。因此GPT-5.6在总分上有所保守,并非整体能力不足,而是前端能力始终不是OpenAI的强项所在。
横向对比:SOL大幅缩差,但尚未超越Fable 5
在综合基准排行榜上,各主流模型的最终排名如下:
- Fable 5:88.57%(榜首)
- Opus 4.8:87.14%
- GN 5.2:81.43%
- SOL:78.57%
- GPT-5.5:38.57%
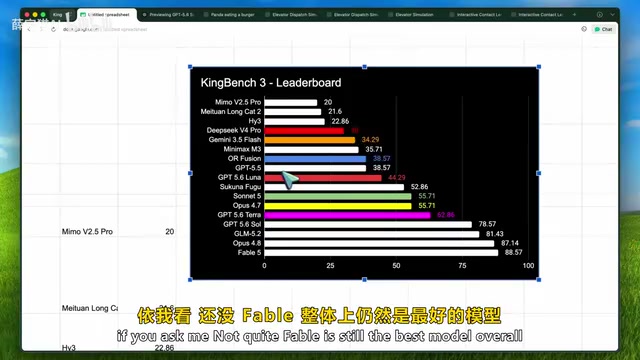
最值得关注的是,SOL的分数几乎是上一代GPT-5.5的两倍——这是一次货真价实的代际跃升。虽然整体仍落后于Fable 5,但差距已大幅收窄。在部分维度(如Cybergenic基准测试的Token效率)上,SOL甚至能与Fable打平乃至小幅超越。
选型建议与总结:渐进式升级,找准适用场景才是关键
综合评估来看,GPT-5.6是一次扎实的渐进式升级,而非新的范式革命。
OpenAI的「三模型并列命名」策略有一定营销色彩——对标Anthropic将Fable打造成「全新模型类别」的做法,让此次发布显得更具声势。值得关注的是,「渐进式升级 vs. 范式革命」的叙事之争,本质上是AI产品营销话语权的博弈。Anthropic将Fable定位为「全新模型类别」,强调其混合推理架构(结合快思考与慢思考的动态切换)带来的质变;而OpenAI此次GPT-5.6的发布节奏与措辞则更为低调,侧重可量化的性能提升与成本下降。从产品生命周期理论看,当市场进入技术成熟期,「可靠的渐进迭代」往往比「激进的范式跳跃」具有更高的企业采购说服力——后者意味着更长的迁移成本和更高的适配风险。SOL几乎两倍于GPT-5.5的得分跃升,在技术层面已属显著进步,但在叙事层面选择了「务实可信」而非「颠覆性」的市场定位,这本身就是一种面向企业买家的战略选择。
根据测试结论,以下是针对不同场景的选型建议:
- 前端开发或视觉密集型任务:Fable 5或Opus 4.8仍是首选
- 后端开发、计算密集型或长时序任务:SOL是极佳选择,且成本大幅更低
- 追求性价比的轻量应用:LUNA可能是目前综合性价比最高的选项
需要注意的是,以上结论均基于预览版测试,正式版发布前性能数据仍可能调整。总体而言,GPT-5.6并非宣传中的「颠覆性革新」,但它定价合理、性能提升显著,成功缩小了与顶级竞品之间的差距,值得后端与算力密集型场景的开发者重点关注。
核心要点
相关推荐

AI无需超级智能或恶意,也可能引发核战争
AI引发核战争的真正风险不在于超级智能或恶意,而在于误报、自动化偏见和决策时间压缩。本文分析平庸AI在核指挥系统中的隐患,以及人在回路、可解释性等应对之道。

AI智能体的真实风险:被夸大的"黑客"与被忽视的隐患
AI智能体"黑客"事件频发,但真实风险究竟是什么?本文剖析OpenAI训练暂停、DNS隧道漏洞、Meta Muse隐私泄露,以及智能体消除摩擦可能引发的银行挤兑与医疗成本上涨,提出"AI现实主义"的理性视角。

OpenAI Dev Day 全盘点:20+ 发布背后的三大趋势
OpenAI Dev Day 一次性发布 20+ 产品,涵盖个人智能体 DOTS、GPT-6.1 Sol、Decisions API、Space 协作区与模型市场。本文全面盘点并解读其揭示的三大 AI 趋势。