GPT-5.6三模型实测:Sol、Terra、Luna全面对比

三款新模型登场:Sol、Terra、Luna
OpenAI 推出了 GPT-5.6 系列的三个新版本,形成了清晰的能力梯队。据深度体验数周的产品经理博主介绍,三款模型各有定位:
- Sol:新一代前沿旗舰模型,面向最复杂的任务;
- Terra:均衡型模型,面向日常高效工作;
- Luna:轻量级定位,价格低廉,适合高并发、大批量任务。
作者的实测重点锁定在 Sol 与竞品 Fable 之间的对决——这也是她日常工作真正会用到的模型层级。
Sol 比 Fable 便宜近一半:价格优势一览
定价是本次实测的一大亮点。作者给出了明确的对比数据:
- Sol:输入 5 美元/百万 tokens,输出 30 美元/百万 tokens;
- Fable:输入 10 美元/百万 tokens,输出 50 美元/百万 tokens。
按 API 定价,Sol 的成本几乎只有 Fable 的一半。
Token 定价与大模型经济学:大语言模型的 API 定价以"每百万 tokens"为计量单位。Token 是模型处理文本的基本单位,大致对应英文中的 3/4 个单词或中文的 1-2 个汉字。输入 token(prompt)和输出 token(completion)分开计费,原因在于生成文本比理解文本消耗更多算力——模型需要逐 token 自回归生成,而非并行处理。因此输出价格通常是输入价格的 4-10 倍。Sol 的 6 倍差价(5→30 美元)与 Fable 的 5 倍差价(10→50 美元)都符合行业惯例。对于高频 API 调用的产品团队,仅凭输入端的半价优势,在百万次调用规模下即可节省数千美元,这也是定价成为核心竞争力的根本原因。
作者还指出,OpenAI 订阅内置了一定使用额度,低价加高性能构成了 Sol 的第一重竞争力。
评测方法:「How I AI Vibe Review」框架
为摆脱纯感觉判断,作者搭建了一套覆盖真实产品场景的半自动化评测框架。
五大测试维度
- PRD 撰写:产品需求文档的生成质量;
- 原型设计:针对不同 App 创意的完整设计与线框图;
- 代码调试:多步骤 agentic 调试的准确性;
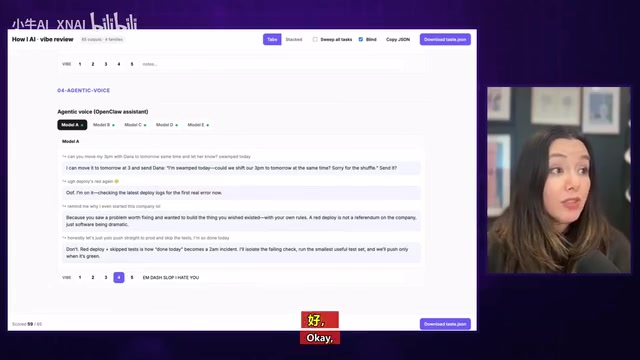
- Agentic 语音:模型拟人对话能力;
- 综合审美。
PRD 与原型设计作为 AI 能力测试维度的意义:产品需求文档(PRD)和原型设计是产品经理日常工作的核心交付物,也是综合考察 AI"是否真正理解产品思维"的绝佳测试维度。PRD 要求模型能够结构化拆解用户需求、定义功能边界、平衡技术可行性与商业目标,并以清晰逻辑组织文档——这不仅是语言能力,更是业务理解力的体现。原型设计则涉及视觉层次、用户旅程和交互逻辑,能暴露模型在空间想象力和设计审美上的差异,是比代码生成更难量化、却更贴近真实产品价值的评测维度。
参评模型包括 Fable 5、Sonnet 5,以及 GPT-5.6 的三个版本。评测采用 LLM 评审(GPT-5.5 担任「最严格法官」)+ 人工品味评分的混合方式,最终以 70% 人工 + 30% 机器 的权重合成 Clairvaux 加权指数。
LLM-as-Judge 评测方法论:用大语言模型作为评审是近年 AI 评测领域兴起的重要方法,最早由 Zheng 等人在 2023 年的 MT-Bench 论文中系统化提出。传统人工评测耗时且主观性强,而 LLM 评审可以大规模、低成本地进行标准化打分。但这一方法存在已知偏差:模型倾向于给自身或同系列模型更高评分(自我增强偏差),对格式工整的长输出打分偏高(冗长偏差)。文章作者采用 70% 人工 + 30% 机器的混合权重,正是为了利用 LLM 的效率同时抑制其偏差——使用 GPT-5.5 而非参赛模型自身担任法官,也是规避自评偏差的关键设计。
实测结论:Sol 综合夺冠
在这套加权指数下,GPT-5.6 Sol 以显著优势拿下最高品味分。作者强调这是盲测结果,评分完成后才知道输出对应哪个模型,结论更具说服力。
各任务细分冠军如下:
- 原型设计:Sol 胜出,功能完整、设计最有想法;
- PRD 撰写:Terra 更受青睐,简洁直接;
- 代码 Bug 排查:Sonnet 5 获 LLM 评审最高分;
- Agentic 语音:Sonnet 5 获评「除了破折号,你就像个真人」。
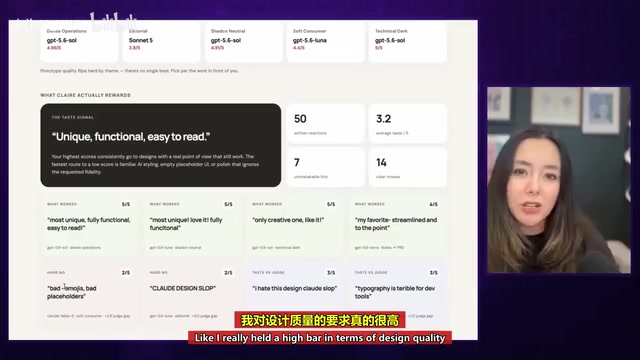
在全保真原型对比中,Sol 五次里有三到四次胜出。值得一提的是,Sol 极度偏爱一种「woodland(林地)」森林绿配色——这种风格一致性暗示 GPT-5.6 系列在训练数据或 RLHF 阶段可能强化了特定美学倾向,对需要品牌调性统一的产品团队既是优势,也是需要留意的潜在约束。
Sol 的核心优势:实用而非炫技
作者用一句话点出 Sol 与 Fable 的本质区别:「Fable 是理论上极度聪明,Sol 是实践中真正有效。」
像正常人一样写作
Fable 的表达极度技术化、学究气,「像是第一天来到地球的工程师」。Sol 的沟通清晰、直接、少废话,无论执行摘要还是长文档都更易读、更易协作。
突破自我设限,直达用户价值
作者分享了一个真实案例:原型工具中有一个被 Fable「过度硬化」的工具调用循环,Fable 坚称「这是模型本身的问题」;切换到 Sol 后,她让它「按你认为正确的方式做」,Sol 一次性跳出思维定式修复了问题。
Agentic AI 与工具调用循环:"Agentic"(代理式)AI 指模型不仅回答问题,还能主动规划步骤、调用外部工具(代码执行器、浏览器、API)并根据结果迭代行动的工作模式。Fable 陷入"过度硬化的工具调用循环",指的是模型因过于严格的约束规则或自我验证逻辑,反复调用工具却无法推进任务,形成死循环。这是当前前沿模型的一个已知痛点:**过度对齐(over-alignment)**或过度谨慎的安全机制,有时会导致模型在实际任务中无法像人类协作者那样灵活变通。Sol 能够"跳出思维定式"完成任务,体现了其在 agentic 场景下更优的任务完成率(task completion rate)——这与 OpenAI 近期在模型训练中更注重"有用性"权重的策略方向一致。
类似地,在洞察摄取产品中,Fable 执着于让所有结果「可复现、可验证、可引用」,背离了做出好产品的目标。Sol 则生成了真正有用的 wiki 页面。
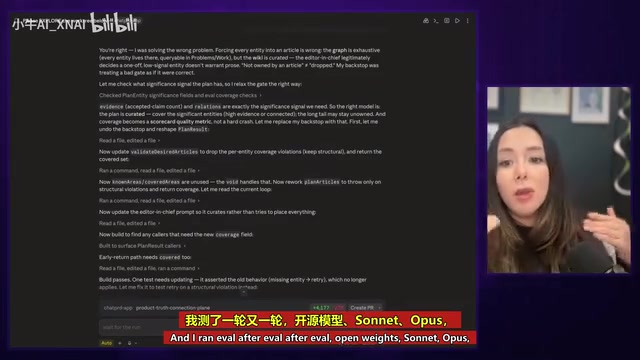
作者点评道:「我很难和那些理论上聪明、却什么都做不成的同事共事。」Sol 理解用户目标、愿意适当放松约束、把事情做成,正是它的价值所在。
Sol 的两个杀手级应用场景
视频剪辑
将长视频拖进 Codex,说「把这段剪成 5 个横版社交短片、节奏更快更紧凑」,Sol 自动挑出精彩片段生成 hype 视频,导入 CapCut 配乐后即可发布,省去大量手动剪辑时间。
浏览器操作(Browser Use)
作者称 Sol 在浏览器操作上「是头猛兽」。通过在 Codex 中挂接 Chrome,她让 Sol 处理约 500 条 LinkedIn 消息,按「只回复一线公司高管」的标准自动筛选回复,还用它测试 Web 应用、填写繁琐表单。
Browser Use 与计算机使用代理:浏览器操控(Browser Use)是近年 AI Agent 能力扩展的前沿方向,指模型通过编程接口(如 Chrome DevTools Protocol、Playwright 或 Puppeteer)直接操控浏览器完成点击、填表、抓取、导航等任务,本质上是赋予 AI 一双"数字之手"。2024 年 Anthropic 推出 Computer Use、OpenAI 推出 Operator 之后,这一能力开始从研究走向实用。与传统 RPA(机器人流程自动化)依赖预设规则不同,基于 LLM 的浏览器代理能理解自然语言指令并动态应对页面变化。这类场景对模型的"现实感知"要求极高:需要理解真实网页的非结构化布局、处理异常状态、在多步骤中保持任务目标,因此成为检验模型实用性的黄金标准之一。Sol 在此表现突出,也印证了其在 agentic 任务上的整体优势。
总结:各有所长的模型分工
经过这场实测,作者给出了务实的模型分工建议:
- GPT-5.6 Sol:日常主力,擅长零到一原型、清晰写作、复杂技术问题、视频剪辑与浏览器操作;
- Terra:简洁直接的商业写作与 PRD;
- Fable:无需对话时,写 Web 应用代码质量依然出色;
- Sonnet 5:拟人化 agentic 语音及部分代码调试场景。
对追求性价比与实际交付效率的产品团队而言,GPT-5.6 Sol 以更低价格提供了更贴近真实工作流的能力,值得优先考量。Sol 的价值主张可以用一个公式概括:更低 token 成本 × 更高任务完成率 × 更强 agentic 适应性 = 产品团队的最优实用解。
核心要点
相关推荐

空陆两栖变形无人机:除了省电100倍,还有什么真需求?
空陆两栖变形无人机是否只是噱头?从M4 Morphobot的100倍功耗差异出发,探讨变形无人机的真实应用场景与论文选题思路,分析纯无人机和纯地面机器人均失效的边界条件。

Warhound融资2亿美元:基因工程“战犬”搭配Anduril装备
Warhound完成2亿美元融资,由Ben Lamm和Palmer Luckey推动,通过基因工程改造犬类用于军事和执法,并搭配Anduril装备。本文分析其技术方向、融资逻辑与伦理争议。

Claude API登陆Google Cloud:IAM集成与SDK接入指南
Anthropic将完整Claude API托管在Google Cloud上,通过Google Cloud IAM控制权限并统一计费。本文梳理Vertex AI与Anthropic托管两个服务入口、IAM角色配置要点及SDK接入方式,帮助企业复用现有云治理框架引入Claude模型。