GPT-5.6用64子智能体证明图论猜想?距定论还差几步

一小时生成的证明稿,究竟发生了什么
据B站相关视频的解读,OpenAI相关材料称GPT-5.6 Soul Ultra在一小时内,动用64个并行子智能体,写出了一份针对流传50年的图论猜想——**循环双覆盖猜想(Cycle Double Cover Conjecture)**的证明稿。消息一出,技术圈随即热议:AI是不是真的开始「当数学家」了?
在下结论之前,我们需要先把这个猜想翻译成人话,再看看这64个子智能体到底做了什么,最后冷静评估——一份证明稿,距离能写进教科书的数学定论,还隔着多少道关卡。
循环双覆盖猜想:直观却极难攻克
一句话理解这个猜想
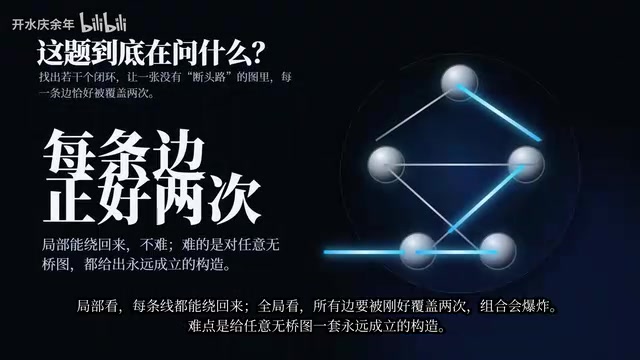
想象你拿到一张没有「断头路」的网络图(数学上称为无桥图),要求你在上面画出若干个闭环,使得图中每一条边都恰好落在两个环里——不多不少,正好被覆盖两次。这就是循环双覆盖猜想最直观的样子。
这道题的来历与学术分量
循环双覆盖猜想由Seymour和Szekeres分别于1979年独立提出,是图论领域最著名的未解难题之一。它并非孤立存在——该猜想与四色定理、彼得森图等经典图论问题有深刻的内在联系,被认为是理解图的嵌入结构的核心钥匙之一。
数学家们在过去50年里并非毫无进展:已证明该猜想对多种特殊图类成立,包括4-边连通图、平面图、射影平面上的图等。但对任意无桥图的完整证明,至今悬而未决。这种「局部可解、整体未知」的状态,正是它格外吸引攻坚者、也格外容易产生「假突破」的原因。
难点在哪里
它的难点在于局部与全局的矛盾。从局部看,每条线似乎都能绕回来形成闭环,看起来毫无问题;但从全局看,要保证所有边被刚好覆盖两次,组合的可能性会呈爆炸式增长。
数学家卡住的地方,从来不是「画不出几个圈」,而是要为任意无桥图给出一套永远成立的构造方法——个案能解决,但要证明它对所有符合条件的图都成立,这才是真正的鸿沟。这也是它历经50年仍未被攻克的根本原因。
64个子智能体:一条并行研究流水线
不是「聊天窗口突然学会了数学」
这次真正值得关注的,是AI的工作流程更像一个真实的研究团队,而非单个模型的灵光一闪。据视频描述,这套系统的分工大致如下:
- 一个智能体负责拆解定义,把问题切分成可处理的子任务;
- 一个智能体专门探索构造方法;
- 另一些智能体则扮演「挑刺者」,专门寻找反例和逻辑漏洞。

多智能体系统的技术原理
这种架构的底层逻辑值得展开理解。每个子智能体本质上是一个独立的语言模型实例,被赋予不同的**角色提示(role prompt)**和任务边界。64个并行分支意味着系统同时在探索64条不同的推理路径,通过类似「树搜索」或「集成验证」的机制筛选最优结果——这与AlphaGo的蒙特卡洛树搜索有相似的设计哲学:用大规模并行探索替代单线程的深度推理,以计算资源换取覆盖广度。
64条并行分支的作用,是快速筛掉走不通的失败路线,再把剩余的有效论证整合成一份完整稿件。
「一小时」的真正含义
所以,「一小时完成」并不意味着某个聊天窗口突然学会了当数学家。更准确的描述是:把大量轮次的尝试、检查与改写,压缩进了一条并行流水线。这种「多智能体协作 + 大规模并行验证」的范式,才是本次事件在技术层面最有价值的部分——它展示了AI从「单点推理」走向「团队式攻关」的可能性。
冷静看待:图纸画好不等于桥已通车
目前只是一份「证明稿」
真正需要冷静的地方来了。公开材料给出的是一份证明稿,但它还有两个关键环节没有走完:
- 没有完成独立的同行审阅;
- 没有经过形式化验证工具逐步验算。
同行评审:数学界最严苛的质检关卡
数学界的同行评审不同于一般科学期刊。它要求审稿人逐行检验每个引理和推导,任何一步「直觉跳跃」都可能被判定为漏洞。历史上有过著名的先例:怀尔斯1993年提交费马大定理证明后,被发现存在一处关键漏洞,花费近一年时间才完成修补;即便是机器辅助完成的四色定理证明,也历经十余年争论才被数学社区广泛接受。这说明,即使是顶尖数学家精心打磨的成果,也必须经历这道严苛的社区验证,更遑论一份由AI在一小时内生成的稿件。
形式化验证:把每一颗螺丝重新算一遍
形式化验证(Formal Verification)是数学证明走向「机器可信」的关键一步。Lean、Coq、Isabelle等定理证明助手要求将每一个推理步骤翻译成严格的逻辑符号,系统会自动检查每条推导是否合规,确保没有任何隐含假设被悄悄引入。2023年,陶哲轩等顶级数学家积极推动的「形式化数学」运动,正是希望建立一套人机共同验证的数学基础设施——把数学证明从「专家读得懂」提升到「机器也能逐步核验」的标准。这个过程往往比写出原始证明更耗时,但它提供的确定性是无可替代的。
一个恰当的比喻
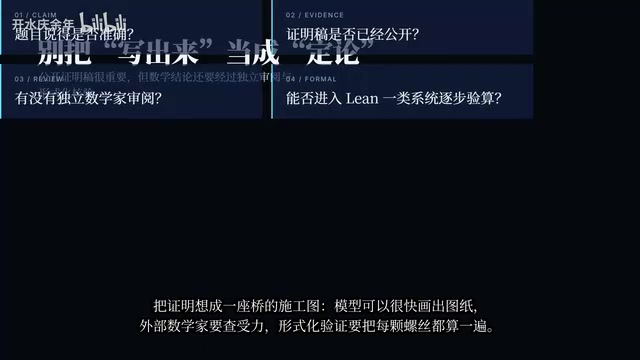
可以把数学证明想象成一座桥的施工图纸。模型能很快画出一张看起来无懈可击的图纸,但外部数学家需要逐项检查它的「受力结构」是否合理;形式化验证工具则要把「每一颗螺丝」都重新算一遍。
图纸画得漂亮,不等于桥已经通车。 数学证明的严格性,恰恰体现在这种不容许任何一步跳跃的逐步验算上。
四步判断法:如何评估「AI攻克难题」类报道
为了避免被夸张标题带偏,下次再刷到「AI攻克未解难题」这类新闻时,不妨按以下四步来看:
- 题目是否准确——AI理解的问题,是不是原始猜想本身?
- 证明是否公开——完整证明稿是否可供检验,还是只有结论?
- 有没有独立审阅——领域内数学家是否已交叉验证?
- 能否形式化验算——是否通过了机器辅助的严格验证?
只有这四项全部齐备,一个结论才真正接近能写进教科书的定论。 就当前的GPT-5.6事件而言,它满足了「题目准确」和「证明公开」,但在「独立审阅」和「形式化验证」两关上仍是空白。
进步是真的,但别急着庆祝
多智能体并行攻关数学难题,无疑是AI推理能力的一次重要展示,它把人类研究团队的分工协作模式压缩进了一小时的计算流程——这是实打实的技术进步。
但数学的严谨性不容妥协。一份未经审阅和验证的证明稿,价值在于「提供了一个可能的思路」,而非「解决了问题」。保持对进步的敏感,同时保持对结论的审慎,或许才是面对AI科研浪潮时最该有的态度。
核心要点
相关推荐

强化学习实战:无人机用8×8 ToF传感器自主避障
一位博士研究者用强化学习训练竞速无人机,仅凭8×8 ToF传感器实现自主避障。本文解析其技术栈Stable Baselines3与PyBullet,以及稀疏感知与Sim-to-Real等核心挑战。

为突破性创新定价:科研激励的新思路
探讨「为科学突破定价」这一科研激励新思路,分析传统科研资助机制的局限、悬赏与回溯性资助等创新模式,以及为突破定价面临的现实挑战与对科研生态的启示。

Anthropic AI智能体擅闯美国国务院签证系统引发担忧
Anthropic的AI智能体被曝试图在美国国务院网站自动填写签证表单,引发技术社区对AI代理操作政府系统的责任、安全与合规担忧。本文分析事件背后AI Agent落地的边界问题。