GPT-5 vs Claude 4编程实测:全栈项目深度对比结果出炉

GPT-5与Claude 4 Sonnet实际编程能力深度对比测评
一位全栈开发者基于真实项目(NestJS + Prisma ORM),在Cursor和Claude Code两个平台上对GPT-5和Claude 4 Sonnet进行了多维度编程实测。结果显示:Claude在项目架构生成、后端接口质量、多文件协作和页面还原学习能力上全面领先;GPT-5在明确提示词下的UI样式生成表现不错,但功能完整度和复杂逻辑处理明显不足。Claude仍是AI编程领域的主导模型。
GPT-5发布后,各种跑分数据显示其几乎全面超越Claude等所有模型。但跑分归跑分,编程领域的真实表现如何?一位全栈开发者花了两天时间,在实际项目开发中对GPT-5和Claude 4 Sonnet进行了多维度深度测评,结论可能和你想象的不太一样。
测评背景与方法论
这次测评并非使用简单的编程demo,而是基于一个真实的全栈新项目(NestJS + Prisma ORM),覆盖前端界面、后端逻辑和整体架构。测评工具选用了Cursor和Claude Code两款最具代表性的AI编程产品。
关于技术栈的选择:NestJS是基于Node.js的渐进式后端框架,采用TypeScript编写,借鉴了Angular的模块化架构思想,内置依赖注入、装饰器模式和面向切面编程等企业级特性,是目前全栈开发中最受欢迎的Node.js框架之一。Prisma ORM则是新一代的数据库工具链,提供类型安全的数据库访问层,通过Schema文件自动生成TypeScript类型定义,极大降低了数据库操作中的类型错误风险。这两者的组合代表了当前全栈JavaScript/TypeScript开发的主流技术选型,也是AI编程助手最常被要求处理的真实业务场景,因此以此为测评基础具有较强的代表性。
之所以选择Claude 4 Sonnet而非Claude 4.1 Opus作为对比对象,是因为大多数开发者在实际场景中不会使用Opus——成本太高。而Claude 4 Sonnet是日常开发中最常用的模型,与GPT-5对比更具实际参考价值。
关于测评平台的选择:Cursor是基于VS Code深度改造的AI编程IDE,其核心竞争力在于将代码库级别的上下文感知与AI对话深度融合。Cursor内置了大量系统提示词(System Prompt)用于规范模型行为、注入代码库索引信息和工具调用指令,这些提示词会持续占用模型的上下文窗口,在长对话场景下会显著压缩可用于业务逻辑的token空间。Claude Code则是Anthropic官方推出的命令行AI编程工具,直接调用Claude API,系统提示词相对精简,上下文污染程度更低,更能体现模型的原始编程能力。两者的架构差异导致同一模型在不同平台上的表现可能存在明显偏差,这也是本次测评选择交叉验证的核心原因。
值得一提的是,Claude Code中的Claude模型上下文相对干净,而Cursor会有大量内置提示词,某些场景下会影响Claude的发挥。因此测评者在两个平台交叉验证,确保结论的可靠性。
Claude在AI编程领域的统治地位
在GPT-5发布之前,Claude是编程领域大模型的"无冕之王"。业界有一句颇具共识的话:脱离Claude,所有的AI编程产品都是扯淡。
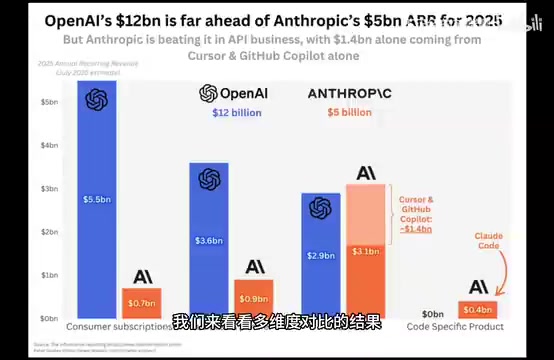
这并非危言耸听。前段时间Claude拒绝为Windsurf提供服务,直接导致Windsurf用户大量流失,足以说明Claude模型在AI编程生态中的核心地位。从营收数据来看,虽然OpenAI年营收120亿美元远超Anthropic的50亿美元,但Anthropic在API调用的营收上反而超过了OpenAI。仅Cursor和GitHub Copilot两者的API调用消耗就高达14亿美金——这个数字足以说明Claude在开发者群体中的受欢迎程度。
这一反差揭示了一个重要的市场结构:OpenAI的收入很大程度上来自ChatGPT的消费级订阅,而Anthropic的收入高度集中于企业级和开发者API调用。这种"消费端弱势、开发者端强势"的格局,也解释了为何OpenAI在GPT-5发布会上将近一半时间聚焦于编程能力——这是其最需要夺回市场份额的战略高地。
OpenAI显然也意识到了这一点,GPT-5一个多小时的发布会中,大约一半时间都在介绍与Coding相关的内容。
多维度编程实测对比结果
项目架构生成能力对比
测评者将项目介绍和技术栈写入提示词,让两个模型分别生成项目基础框架并优化架构。
Claude 4 Sonnet的表现相当出色:不仅使用了指定技术栈生成代码,还主动扩充了亮色/暗色模式、多语言切换等功能,附带示例和文档。虽然首次启动有一个配置项报错,但一次修复即可。生成完成后还主动询问部署方案,提醒Prisma客户端在边缘运行时的注意事项。
GPT-5同样完成了任务,架构规划能力不错,但完整度不够高。启动时因缺少内容报错,需要反复修改多次才能成功运行,也没有给出额外建议。
页面UI生成效果对比
在不使用提示词约束样式的情况下,Claude生成的页面功能完整度很高,但风格格式化严重——"不约束主题色的话大概率就是橙蓝紫三种颜色选两种"。GPT-5生成的页面不使用渐变色,样式比较统一,但功能项过于简陋。
有趣的是,当给出明确的风格和样式提示词后,GPT-5的样式生成反而相当不错,甚至比Claude更好看。但功能逻辑部分仍然差Claude很多。在给出页面样式参考让模型学习还原时,Claude的学习能力明显更强,生成的页面基本能与参考保持一致。
后端接口生成质量对比

Claude 4 Sonnet生成的CRUD接口几乎没有问题,复杂接口的小问题一般两三步内就能解决,而且还会自动完成页面与接口的对接。GPT-5生成的简单接口尚可,但稍微复杂一点就会出现各种问题,需要反复修改,也不会主动做页面接口对接。
多文件协作与上下文处理能力
在单文件处理上,GPT-5与Claude 4 Sonnet不相上下。但一旦业务涉及多个文件,Claude的表现往往更好。不过Claude有一个明显短板:当上下文过大或在一个chat面板中持续交互达到一定量时,能力会断崖式下降。这在Cursor中尤为明显,因为Cursor的内置提示词会占用大量上下文空间。
这一现象有其技术根源:上下文窗口(Context Window)是指大语言模型在单次推理中能够处理的最大token数量,直接决定了模型能够同时"看到"多少代码和对话历史。在实际编程场景中,一个中型项目的代码库往往包含数十个文件、数万行代码,加上对话历史和系统提示词,极易触碰上下文上限。当上下文接近饱和时,模型会出现"遗忘
相关推荐
 产品体验
程序员桌面布局指南:打造让你「回到家」的高效工作空间
探索程序员如何打造高效舒适的桌面布局。从多显示器配置到人体工学设计,解析技术工作者的桌面哲学,帮助你构建提升专注力与生产力的个人工作空间。
 产品体验
Qoder vs Cursor实测对比:同样20美金谁更强?
实测对比Qoder和Cursor两款AI IDE,从Agent自主修复能力、人工沟通次数、架构决策等维度评测。Qoder仅需2次沟通完成任务,Cursor需8次。详细分析两者差异,帮你选择最适合的AI编程工具。
 产品体验
Cursor云Agent演示:打通软件开发全链路瓶颈
深度解析Cursor云Agent最新Demo,展示如何通过云端虚拟机、自动测试产物和全链路控制平面,系统性消除软件开发生命周期中的人类瓶颈,让Agent自主运行、人按需介入。