GPT-6.1 Sol 实测:1/5价格逼近顶配,能否叫板 Opus 5.5?

GPT-6.1 Sol以约1/5价格逼近顶配模型,是性价比导向的工程主力,创意类任务仍弱于Astra和Opus 5.5。
OpenAI DevDay 发布的 GPT-6.1 Sol 以「约1/5价格、接近顶配智能」为核心卖点,综合榜单得分52分仅比 Astra 低1分,但 Terminal Bench 4.0 得分超越 Opus 5.5,且单任务 Token 消耗显著低于 Claude 系模型,使实际运营成本更具优势。实测显示其在终端操作、算法可视化、科学研究及长时程复杂任务(如2小时38分生成完整可漫游 Unity 游戏)上表现扎实;乐高说明书还能直接附带零件采购链接,体现出工程化思维。弱项集中在创意写作、精细美术质感与色彩光影表达上,这些场景 Opus 5.5 和 Astra 仍占优。结论是:预算敏感、任务量大的开发者可将其作为日常主力,追求极致成片质量时则建议配合顶配模型协作。
OpenAI DevDay 的新主角:GPT-6.1 Sol
OpenAI 在 DevDay 上端出的 GPT-6.1 Sol(下文简称 6.1 Sol),最抢眼的卖点不是绝对性能,而是性价比。官方给出的定位很直接:以约 1/5 的价格,获得接近 Astra 顶配模型的智能水平。这意味着它被设定为处理日常大量工作的「主力劳工」——代码审查、架构分析、计算机使用、电子邮件管理等高频任务,都被默认交给它来跑。
B站UP主 Kate 在实测中提到一个关键的使用体验:在 5X 会员方案下,6.1 Sol 消耗的周额度下降明显偏少。对于需要长时间、高频调用模型的重度用户来说,这种「跑得多、扣得少」的特性,往往比榜单上一两分的差距更能决定实际选择。
榜单数据:低一分,但便宜一大截
从测评数据看,6.1 Sol 的定位相当清晰。在综合能力榜单上它拿到 52 分,比 Astra 少 1 分,同时仍低于 Sonny 5.5(原文提及的对比基准)。但换个角度看,用 1 分的智能差距换来大幅降低的价格,这笔账在工程落地场景中是划算的。
更值得关注的是几个专项表现:
- Terminal Bench 4.0:6.1 Sol High 档位的得分超过了 Opus 5.5,说明它在终端/命令行类任务上有实打实的优势。
- Token 效率:GPT 系模型单个任务完成所消耗的 Token 数远少于 Cloud(Claude)系模型。这是隐性成本优势——同样的活儿,花更少的 Token 意味着更低的实际账单。
- 推理档位影响大:当推理程度设为 High 时,专业工作、科学研究等场景的得分最高。科学研究方面 6.1 Sol 远超 Opus 5.5。
简单说,6.1 Sol 不是在追求「全面碾压」,而是在「够用且便宜」这条路上做到了精准取舍。
Terminal Bench 是专门衡量模型在命令行、终端操作、Shell 脚本及系统级任务上能力的基准测试集,4.0 是其第四个主要版本。与通用推理榜单不同,它侧重考察模型能否正确理解并生成 Bash/Python 脚本、调试错误输出、处理文件系统操作等实际开发者工作流中的场景。6.1 Sol 在该榜上超越 Opus 5.5 尤为值得关注,因为 Claude 系列(Opus 为其旗舰)一直被认为在代码辅助和工程任务上有较强竞争力,这一结果意味着 6.1 Sol 在「接近命令行底层」的工程任务中已具备实质优势。
Token 效率的差异在实际账单中影响显著。大语言模型 API 通常按输入+输出 Token 总量计费,同一任务若 GPT 系只需 2000 Token 而 Claude 系需要 4000 Token,前者的实际成本便接近减半——即使单价相同,效率差异也会产生倍数级的费用差距。对于高频调用场景(如 CI/CD 流水线中的代码审查、批量邮件处理),Token 效率往往比模型定价本身更能决定月度总支出。
生成能力实测:静态强,创意稍弱
绘画与算法可视化
UP主用 6.1 Sol 生成了一幅《清明上河图》风格作品。整体色调偏古画质感,河两岸的码头、桥、船只完成度不错,放大后能看到轿子、招牌、驴马、小货车、商铺等细节。不足之处在于岸边建筑本应满是商铺招牌,实际却较为空白。综合评价是不及 Opus 5.5,但相比 GPT-6 已是巨大进步。
在纯算法/几何类任务上,6.1 Sol 表现稳定:3D 眼睛蛇页面清爽、爱心和五角星生成都很规整,反映出其推理与算法能力扎实。
创意写作的短板
同样是「一个下午收到三条消息」的 500 字内心独白命题,6.1 Sol 的成文效果明显不如 Astra。这符合它的定位——理性任务强,情感与文学性表达是相对弱项。
视频与建模:性价比与顶配的取舍
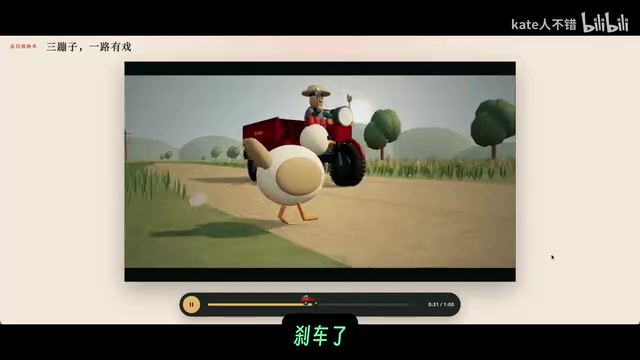
在「三蹦子广告大片」测试中,6.1 Sol 的车辆造型、行驶颠簸、刹车、路遇小鸡等动态细节都做得不错,只是货物细节略显模糊。整体效果不如 Opus 5.5,但考虑到价格差距,成片质量已经相当能打。
根据三张参考图还原建筑视频时,中庭那棵从一楼贯穿到高处的树是难点。Opus 5.5 在这一题上表现最佳——玻璃罩把树精准罩在中间,纹理、室内静物、露台观赏草、餐厅、卧室浴缸的视线关系都处理得很到位。6.1 Sol 虽然静态物体造型、空间感都不错,但出现了画面闪烁,以及中庭圆形放树处地板异常凸出的安全隐患式错误。
乐高搭建:说明书细节见真章

这是最能体现两者差距的一环。根据 Grok 生成图搭建乐高小屋,6.1 Sol 用了一千多个零件,Opus 5.5 用了两千多块,后者的搭建过程、小床、梳妆镜、可动关节小熊的质感都更胜一筹。
不过 6.1 Sol 有个亮点:它生成的说明书里,每个零部件都标注编号并附带采购信息,点击即可查看购买链接,真正做到了「所见即所得」。相比之下 Opus 5.5 的零件清单虽然元素齐全,却没有直接可对应的购买链接。但 Opus 5.5 的说明书互动细节更丰富、质感更好,唯一遗憾是没有像正规乐高说明书那样把已安装部分置灰,导致识别性偏弱。
科普与产品演示:文字排版是硬伤
肥皂泡科普的 3D 建模中,6.1 Sol 的泡泡建模稍显顺色(发灰),Opus 5.5 在光色变化的直观呈现上更优。
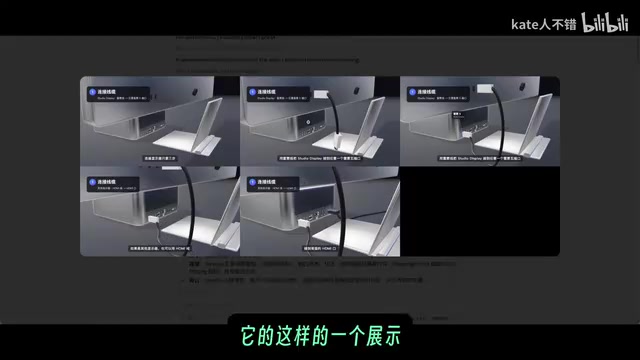
而在「Mac Studio 接显示器」的产品演示视频里,两个模型各有毛病:6.1 Sol 建模质感不错,但文字倾向于做成 PPT 式的「第几页」标注,文案累赘、样式不如 Opus 5.5,背景亮时文字辨识度低,UP主提示了好几次才达标。Opus 5.5 则在 Mac Studio 的色彩还原上跑偏且反复修不好,线材展示也不够精致。最终的解法很有意思——让 Astra 出手给 Opus 5.5 修正建模与线材,两者协作才做出满意短片。这也侧面印证了多模型分工协作的实用价值。
两小时造一座「猪猪乐园」
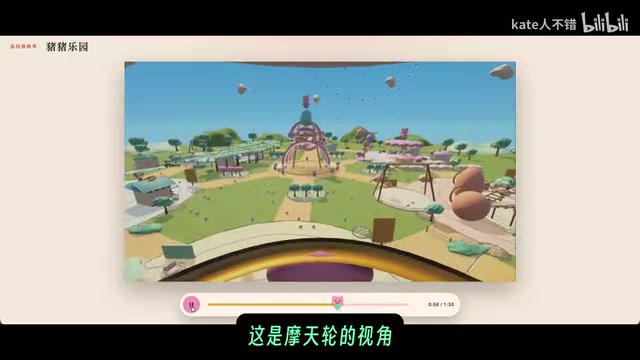
最见功力的是一个耗时 2 小时 38 分钟生成的 Unity 漫游游戏「猪猪乐园」。乐园大厅、面包窑、旋转木马、过山车、摩天轮、游船、卖税坡、丰收转盘、风箱修理铺等场景一应俱全,过山车质感与结构没有明显错误,小猪能眨眼、戴不同帽子,树叶点缀的小屋场景颇具可爱感。
瑕疵也存在:秋千与上方杆子脱节。但整体来看,能在两个多小时内自动生成一个可漫游、细节丰富的 Unity 游戏世界,已经充分展示了 6.1 Sol 在复杂长任务上的执行力。
Unity 是目前全球使用最广泛的实时 3D 游戏引擎之一,支持 Windows、macOS、iOS、Android、WebGL 等多个平台发布。用 AI 生成 Unity 项目(包含场景、资产、脚本逻辑)属于「代码+资产联合生成」的复杂任务——模型不仅要输出 C# 脚本控制游戏逻辑,还需生成或调用 3D 模型、材质、动画等资产,并保证各组件之间的引用关系正确,整个工程才能在引擎中正常运行。相比单纯生成一段代码或一张图片,这类任务对模型的长上下文管理、多步骤规划和错误自修复能力有更高要求,因此能在约两个半小时内完成一个可漫游的完整场景,是对 6.1 Sol 长任务执行力的有力佐证。
结论:谁该选 6.1 Sol?
综合全部实测,6.1 Sol 的画像很清晰——它不是来抢 Opus 5.5 和 Astra「最强」头衔的,而是把「智能接近顶配、价格只要 1/5、Token 消耗更省」这套性价比逻辑做到了位。理性任务(终端、代码、科学研究、算法可视化、长时程游戏生成)是它的强项;创意写作、精细美术质感、色彩光影的情感表达则仍是 Opus 5.5、Astra 更擅长的领域。
对于预算敏感、任务量大的开发者和重度用户,6.1 Sol 很可能成为日常主力;而在追求极致成片质量时,配合顶配模型或多模型协作,才是当前更聪明的用法。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。