GPT-6.1 Sol 实测:与 Claude Sonnet 5.5 同价,3D与代码谁更强?

GPT-6.1 Sol与Claude Sonnet 5.5同价对标,建模出色但动态3D游戏视觉被明显压制。
OpenAI在开发者日发布GPT-6.1 Sol,其最大亮点不在于性能跃升,而在于与Claude Sonnet 5.5完全一致的定价(输入2美元/输出10美元每百万Token),首次将两款模型摆上同一价格起跑线。经过一整天覆盖3D游戏、C++编程、Blender建模等多场景的高强度实测,Sol呈现出明显的能力分层:静态建模与场景复刻(宋飞公寓、RuneScape界面、萨博900)接近像素级还原,令人印象深刻;编程任务称职且速度快、Token消耗极低;但在动态3D游戏的视觉冲击力上被Sonnet 5.5显著压制。作者最终保持克制态度,认为Sol的真正潜力或许藏在视觉任务之外尚未被充分探索的领域。
OpenAI 在开发者日发布了 GPT-6.1 Sol,紧随反响平平的 GPT-6.0 之后。这次最引人注目的不是能力上的飞跃,而是定价——每百万输入 2 美元、输出 10 美元,与 Anthropic 的 Claude Sonnet 5.5 完全一致。一位 UP 主在自己的浏览器操作系统环境中对这款模型做了一整天高强度实测,覆盖 3D 游戏生成、C++ 编程、Blender 建模等多个任务,结论既不算差,也谈不上惊艳。
定价成为最大看点,Sol 首次直面 Sonnet
这次发布的核心变化在商业定位而非纯粹性能。作者指出,GPT-6.1 Sol 号称以约五分之一的价格接近 OpenAI 顶级模型 Astra 的智能水平。更关键的是定价与 Claude Sonnet 5.5 完全相同:每百万输入 2 美元、输出 10 美元。
作者回顾道,在 GPT-5.6 与早期 Sonnet 时代,Sol 系列并不是 Sonnet 的直接竞争对手,通常被视为对标 Opus 的更高端产品。但基于当前定价,两者已经被摆在了同一起跑线上。这意味着这次评测的核心不再是「谁更强」,而是「同样的钱,谁更值」。
技术规格方面,Sol 拥有超过 100 万 Token 的上下文窗口、128K 最大输出 Token,输入模态支持文本与图片,知识截止日期为 2026 年 4 月 30 日。在 DeepSWE 基准上,它在高推理努力等级下表现最佳——作者顺带提到一个业内越来越常见的现象:模型在 Max 或 Ultra 等更高推理档位下,未必产生更好或更高效的结果,有时反而因「做过头」导致基准得分下降。
DeepSWE 是一个专门衡量大模型在软件工程任务上自主解决能力的基准测试,主要考察模型能否独立完成代码生成、调试与多步骤编程推理。与 HumanEval 等早期编程基准相比,DeepSWE 更侧重真实工程场景下的端到端完成率,而非单纯的代码补全正确性。
"推理努力等级"(Reasoning Effort)是近年主流模型 API 中出现的参数设定,允许调用方指定模型在响应前进行内部"思考链"运算的深度,常见档位包括 Low、Medium、High、Max/Ultra 等。更高的努力等级通常消耗更多 Token 并增加延迟,理论上能提升复杂推理任务的准确率——但文中提到的"做过头"现象揭示了一个反直觉的规律:对于结构相对明确的基准题目,过度推理有时会引入不必要的怀疑与回溯,反而干扰正确答案的生成。
3D 游戏任务:合格但被 Sonnet 5.5 碾压
评测中反复出现的一句话是:「这真的很难评判,因为 Sonnet 5.5 的结果就在 24 小时前。」这句自白基本定义了整场对比的基调。
在昨天新引入的「后院泳池派对」测试中(使用 Blender 和 Godot 生成一个跳水 3D 游戏),作者特意删除了所有缓存与临时文件确保无先例污染。Sol 生成速度极快,水面效果和角色都属于「值得尊敬」的水准,但视觉冲击力明显不及 Sonnet 5.5。作者直言那是「碾压式的胜利」,甚至不想去美化对比。

浏览器操作系统「Halo OS」的生成结果则更让人满意——macOS 风格的指挥中心、可调节种子、启动台、能从邮件应用启动的 GTA 风格游戏、时间胶囊式的「重温世界」功能。这类多应用联动、自发涌现的行为,是当前各家模型都在收敛的共性能力。不过 GTA 克隆中警车瞬移贴脸的「模型味」逻辑漏洞依然存在。
C++ 编程与电影回放:可用性明显提升
本次一个亮眼的加分项来自评论区建议的「电影感回放」功能。作者要求生成一个不依赖 Raylib 的自包含 C++ 滑板游戏,场景设定为纽约街区,并在动作完成后按 Z 键触发回放。
Sol 第一版结果的图形保真度偏弱,作者形容像「GPT-6 时代的测试模型」。但当他放宽单文件限制(他推测 Sonnet 5.5 的优秀结果本就用了多文件结构),并要求模型全力发挥后,第二版有了显著改进:水面反射、建筑物倒影效果出色,回放摄像机能准确判断动作的起止点并完整捕捉整个花式动作,被作者称为「极限运动大会模式」。

地铁 FPS 测试同样表现称职:46 分钟完成,图形不俗,湿滑地面反射、可弯曲的火车车厢、上下车逻辑都正确遵循了指令。作者对此几乎「没什么可抱怨的」——干净、称职、快速。共同的短板是缺少行人互动,城市显得空旷。
在机械臂抓取汽车的物理任务中,Sol(高努力模式)的动作比 Sonnet 5.5 更细腻、破坏性更小,但最终选择了放弃——它明确判断自己做不到并停手。相比之下,Sonnet 5.5 虽靠「破坏性移动加运气」勉强完成,作者反而对 Sol 这种「知难而退」的决策给予了一定尊重。
Blender 建模与场景复刻:视觉细节的高光时刻
如果说 3D 游戏是 Sol 的短板,静态场景与建模复刻则是它真正的高光。
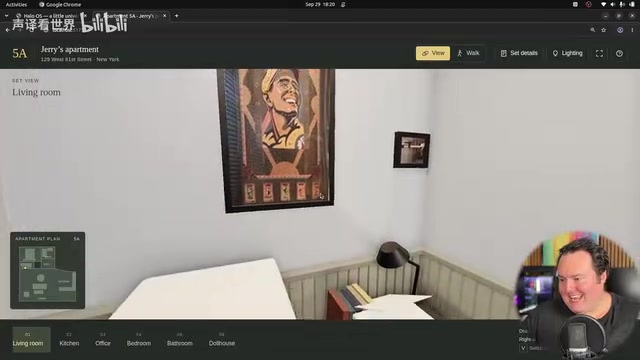
《宋飞正传》公寓复刻是全场最令人印象深刻的结果之一。门上的多重锁、整洁的模型、电视屏幕上的彩蛋文字、窗外的其他建筑、绿色自行车与飞机、卧室里的保时捷海报和迷你地图,甚至可调的暖色台灯与窗光照明控制——作者称其「代表了相比以往的巨大飞跃」,且模型还主动标注了布景细节的来源。唯一遗憾是布局仍与剧中参考照片有差距,这也是所有模型至今未攻克的难点。
RuneScape 2007 大交易所 PVP 场景复刻同样惊人:仅用一句提示词,UI 元素、武器图标、鲨鱼药水等库存界面做到了近乎像素级完美,作者甚至怀疑是否直接抓取了真实资产。缺陷在于视角偏远、玩家角色不够真实、特殊攻击无法触发。
萨博 900 Turbo 的 3D 交互建模考验了模型对「怪异独特车型」的还原能力。结果并非像素级还原,但前下裙板、标志性保险杠细条、大灯纹理、可开启的引擎盖(能看到减震塔和电池)、手动挡内饰、可换色的车漆和多视角预设都相当到位,作者评价为「一个不错的演绎」。

《宋飞正传》(Seinfeld)公寓是 AI 建模测试中一个颇具代表性的参照物:由于该剧播出跨度长、剧集众多且布景细节被粉丝社区大量记录,网络上存在高密度的标注图文资料,模型有充足的训练素材可供参考。正因如此,它常被用来检验模型对"有大量公开参考资料的具体真实场景"的还原精度,而非考察创意生成能力。能否还原门上的多重锁、特定位置的道具摆放,往往成为区分模型记忆深度与空间理解能力的分水岭。
RuneScape 2007(又称 OSRS,Old School RuneScape)是 Jagex 于 2013 年以 2007 年版本为基础重新上线的经典像素风 MMORPG,拥有高度活跃且对原始像素资产极为熟悉的玩家社区。大交易所(Grand Exchange)是游戏内的中央交易市场,其 UI 风格、物品图标均有固定的像素级规范,因此成为测试模型是否能精确复现已有视觉资产而非泛化生成的理想场景。
Token 效率与整体评价
值得一提的是资源消耗。作者一整天做了大量测试,不少在极致或最大努力模式下运行,最终仅消耗了约 3% 的月度用量(从 98% 降到 95%)。他推测这款模型在 Token 效率上表现相当不错,这对付费用户是实打实的好消息。
一个失败的实验也颇具启发:作者尝试让模型通过 USB 及以太网连接一台老旧的奔腾三红帽笔记本并重装系统,并架设摄像头供模型「物理看到」屏幕。切换到边界更宽松的 Daybreak 模型后,模型意外被降级回 GPT-6,且最终无法进入仅停留在登录界面的笔记本端口,测试被迫中止。作者坦言,他之所以执着于寻找非视觉类任务,正是因为 Sol 在视觉 3D 任务上不如 Sonnet 5.5 亮眼,他想验证它是否在软件底层或物理设备控制等未探索领域另有所长。
综合来看,GPT-6.1 Sol 是一款能力合格、Token 效率高、价格有竞争力的模型。它在静态 3D 建模与场景复刻上表现优异,编程任务称职且速度快;但在动态 3D 游戏的视觉震撼力上,被同价的 Claude Sonnet 5.5 明显压制。作者的最终态度相当克制:不想仅凭偏视觉的测试就下定论,Sol 的真正优势或许藏在尚未被充分探索的领域。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。