GPT-6.1 Sol与Grok 4.7登陆Databricks:前沿模型竞速背后的企业治理难题
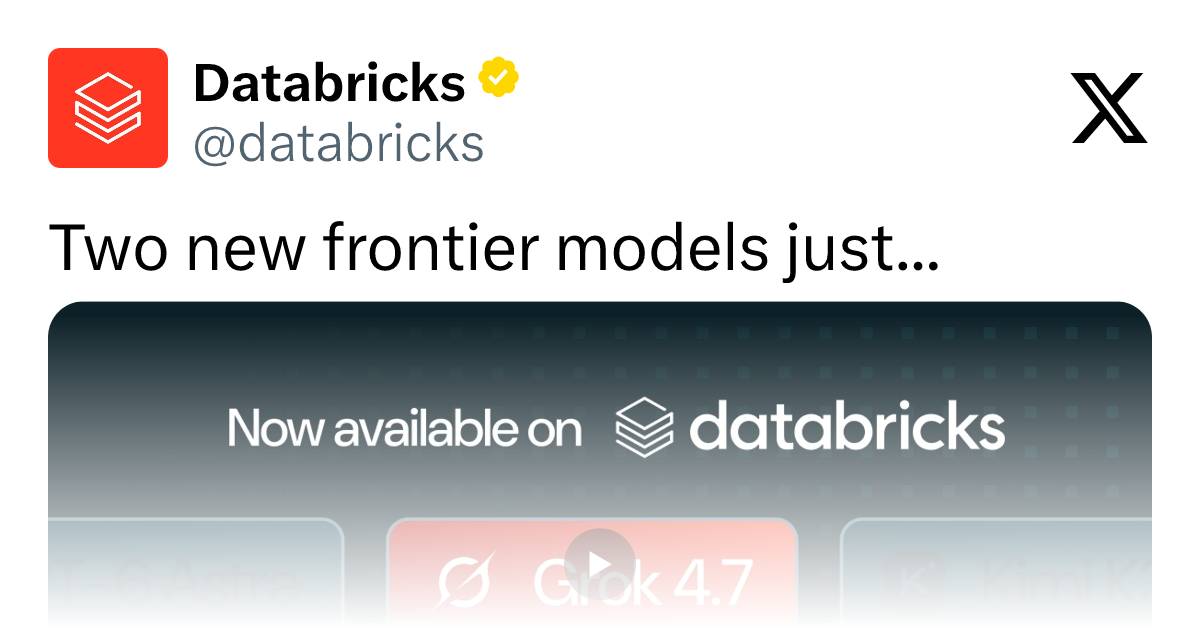
GPT-6.1 Sol与Grok 4.7同日上线Databricks,Unity Gateway将竞争焦点引向模型治理与平台调度。
Databricks宣布GPT-6.1 Sol与Grok 4.7两款前沿模型同日上线其平台,实现「发布即可用」。两款模型各有侧重:GPT-6.1 Sol在OfficeQA Pro v2基准上占据成本-质量帕累托前沿,强调性价比而非单纯刷榜;Grok 4.7则在企业文档解析任务上表现领先,适合合同、报表等非结构化数据处理场景。更值得关注的是Databricks推出的Unity Gateway,它在超过60款模型之间统一承担选型路由、调用治理与成本控制三大职责,将平台竞争的重心从「哪款模型最强」转向「谁能提供最完善的模型管理基础设施」。对企业用户而言,构建灵活可切换的模型调度层,比押注单一最强模型更具长期稳健性。
两款前沿模型同日上线Databricks
据Databricks官方透露,两款新的前沿大模型已在其平台正式上线:OpenAI 的 GPT-6.1 Sol 与 SpaceX AI 的 Grok 4.7。更值得关注的是,这两款模型几乎在发布当天就直接接入了 Databricks 生态,缩短了企业从「模型发布」到「可用部署」之间的时间差。
在以往,前沿模型从厂商发布到企业能够在生产环境中调用,往往需要数周甚至数月的适配周期。而这次「ship 即可用」的节奏,反映出模型分发渠道正在加速整合——平台方希望让企业用户第一时间接触到最新能力。
两款模型各有所长
根据官方说法,这两款模型分别在不同的基准测试上占据领先地位,而非简单的「谁更强」之争。
GPT-6.1 Sol:成本-质量帕累托前沿
GPT-6.1 Sol 在 OfficeQA Pro v2 基准上处于「成本-质量帕累托前沿」(cost-quality Pareto frontier)。这一表述值得拆解:它强调的不是单纯的质量最高,而是在给定成本下达到最优质量,或在给定质量下成本最低。对企业采购而言,这类指标往往比「刷榜第一」更有实际意义,因为生产环境中的调用量巨大,单次调用的性价比会被急剧放大。
「帕累托前沿」(Pareto frontier)源自多目标优化理论:当一个方案在不损害其他目标的前提下,无法再改善某一目标时,它就处于帕累托最优状态;所有这些最优方案连成的边界即为帕累托前沿。在成本-质量的二维空间里,处于前沿意味着不存在另一款模型能以更低成本达到同等质量,或以同等成本达到更高质量。这一概念特别适合用来评估「可商用」的模型:纯粹的质量榜首可能成本高到无法大规模调用,而帕累托前沿上的模型则代表了工程与经济层面的综合最优解。OfficeQA Pro v2 作为基准测试,侧重于办公场景下的问答能力,GPT-6.1 Sol 在该测试上占据成本-质量前沿,意味着它在处理日常办公类任务时能以更优的投入产出比替代同类竞品。
Grok 4.7:企业文档解析的领先者
Grok 4.7 则在企业文档解析(enterprise document parsing)任务上触及前沿水平。文档解析是企业 AI 落地中极为高频的场景——合同、报表、发票、技术手册等非结构化数据的提取与理解,直接关系到自动化流程的可行性。Grok 4.7 在这一垂直能力上的表现,使其成为面向文档密集型业务的候选方案。
这种「分领域各有所长」的格局提醒企业:没有一个模型能在所有任务上通吃,模型选型本质上是一个任务匹配问题。
Unity Gateway:从「选模型」到「治理模型」
模型发布越来越快,企业面临的真正挑战不再是「能不能用上最新模型」,而是「如何在众多模型之间做出合理调度与治理」。Databricks 给出的答案是 Unity Gateway。
按照官方描述,Unity Gateway 承担三项核心职责:
- 为合适的任务选择合适的模型:避免用高成本模型处理简单任务,或用能力不足的模型处理复杂任务;
- 治理每一次调用:在企业合规与安全层面,对模型调用进行统一管控;
- 跨模型控制成本:在 GPT-6.1 Sol、Grok 4.7 以及平台上已有的 60 多款前沿与开源模型之间统一管理支出。
这意味着企业不必为每款新模型重新搭建接入与管控体系,而是通过一个统一网关层来对接不断涌现的新模型。
模型网关(Model Gateway)是企业 AI 架构中的一个中间层,类似于 API 网关在微服务架构中的角色。它统一接收来自应用层的推理请求,根据预设策略路由至不同的底层模型,同时在请求与响应的链路上执行鉴权、日志、限速、内容过滤等治理操作。对企业而言,引入模型网关的核心价值在于「解耦」:应用代码无需感知底层模型的变更,模型的替换、版本升级或成本优化可以在网关层静默完成,而不触发大规模代码改动。Unity Gateway 在此基础上进一步融合了成本归因与跨模型预算管控能力,使财务与合规部门能够对 AI 调用支出建立可量化的管理机制,这在大规模生产部署中尤为关键。
平台化竞争的深层逻辑
从这次发布可以看出,大模型领域的竞争重心正在从「单一模型能力」向「平台调度与治理能力」转移。当前沿模型以越来越快的节奏迭代,单个模型的领先优势窗口也在缩短,企业更需要的是一个能够持续吸纳新模型、并对其统一管理的基础设施。
对 Databricks 这类数据与 AI 平台而言,「谁家模型最强」并非关键,关键是能否第一时间把最强的模型接入平台,并提供选型、治理、成本控制的完整工具链。这也是「60+ 模型」这一数字背后的战略意图——打造一个中立的模型聚合与治理层。
需要说明的是,本文信息主要来自 Databricks 官方发布内容,关于 GPT-6.1 Sol 与 Grok 4.7 的具体基准成绩与技术细节,官方并未给出完整数据,企业在实际选型时仍应以自身业务场景的实测为准。
对企业用户的启示
对于正在评估 AI 落地路径的企业,这次发布传递出几个实用信号:模型迭代速度已超出大多数团队的跟进能力,依赖单一模型存在被快速超越的风险;成本-质量的权衡比单纯追求榜单第一更贴近生产现实;统一的模型网关与治理层正在成为企业 AI 架构中的必要组件。
与其押注某一款「最强模型」,不如构建一套能够灵活切换、持续吸纳新能力的基础设施——这或许是前沿模型竞速时代里,企业更稳妥的策略。
相关推荐

一场与Grok的对话能否影响重大决策?素材不足的警示
一则关于美国因与Grok对话影响委内瑞拉决策的Hacker News标题引发关注,但缺乏正文与信源。本文探讨此类耸动标题的识别方法与AI在决策中的真实边界。

AI编程为何离不开Git?从版本回退到AI辅助命令全解析
Git是AI编程的必备工具。本文解析Git分布式版本控制在AI编程中的价值,包括应对AI幻觉的版本回退、分支管理等核心操作,以及如何用豆包、AI输入法等工具快速生成Git命令,帮助新手零基础入门。

拒绝AI胡编:一款"说不了谎"的求职信生成器是如何炼成的
一位开发者因AI求职信工具凭空捏造其Kubernetes经验和管理经历而屡遭拒信,于是打造了CoverCraft——通过代码计算评分、GitHub提交记录背书、对抗性审查与人工审批四重机制,构建一款"无法说谎"的AI求职信生成器。本文解析其对抗AI幻觉的工程设计。