GPT-6.1 Terra 实测:价格减半的终端模型值不值

OpenAI Terra 定价减半但档位尴尬,实测动作有硬伤,仅最高档划算。
OpenAI 发布终端模型 Terra,定价约为旗舰一半,上下文 105 万 token,默认中档。官方演示展示精细三维建模,但同题实测发现画面尚可而动作存在硬伤,如脚踏转向反了、脚未真正踩下。第三方修漏洞测试表明只有最高档才显著优于上一代,往下调档分数断崖式下跌。LiveBench 七项中能动性仅 48.6 分,是明显短板,与实测动作缺陷吻合。智能指数 51 分夹在旗舰之间,评价分化。Terra 适合量大、流程清楚、可自动验收的任务,不适合需要判断力的复杂工作。
OpenAI 在 10 月 26 日发布了终端模型 Terra,定价只有自家最高档的十分之一。官方演示里它能从一张电车照片做出精细三维模型,自己操作 Blender 拖拽车身、车窗、受电弓。但官方视频是剪过的成品镜头,看不到它搞砸的过程。StarAI 模型评测做了一轮同题实测,把官方演示、自跑测试、最高档对照、第三方榜单拼在一起看,结论比宣传复杂得多。
定价砍半,但档位尴尬
先看账面。Terra 输入每百万次元 1 美元,输出 5 美元,上一代是 2 美元和 12 美元,输入直接砍半,输出降了快 6 成。它跟旗舰售的定价正好是一半,上下文 105 万次元,最大输出 12 万 8,推理档位一共 6 档,默认落在中档——往上购旗舰,往下不便宜,这个位置本身就尴尬。
定价只是账面,要看它能干什么。官方演示最直观的一段是拿一张理事本电车的照片做精细三维模型,视频里它自己操作 Blender 开实践模,拖拽拉伸车身、车窗、受电弓都长出来了,界面右下角写着 Terra 档位是高档。但注意这是官方剪过的成品镜头,视频里自己写有段落被剪掉,看不到反攻,也看不到它搞砸几次。
上下文窗口与最大输出是衡量大模型单次可处理信息量的两个关键指标。上下文窗口指模型在一次请求中能“记住”的 token 总量,包括用户输入和模型已生成的内容;最大输出则限制单次回复的长度。文中 Terra 的“105 万次元”即约 105 万 token 的上下文,足以容纳数百页文档或长代码库;12 万 8 的最大输出则允许生成完整报告或较长代码文件。这两个数字共同决定了模型能否胜任长文档分析、多轮复杂任务等场景,也是与竞品对比时的重要维度。
同题实测:画面能看,动作是硬伤
StarAI 自己跑了一道「醍醐骑车题」——四家模型同一道题、同一个提示词。Terra 这批四个成品里,它的场景最单调,身像车把的两根白杆很抢眼,翅膀反而没什么层次。更明显的是脚踏板一直在转,脚却没有沿着踏板踩下去,更像腿在摆、自行车在走,不像真正在登车。
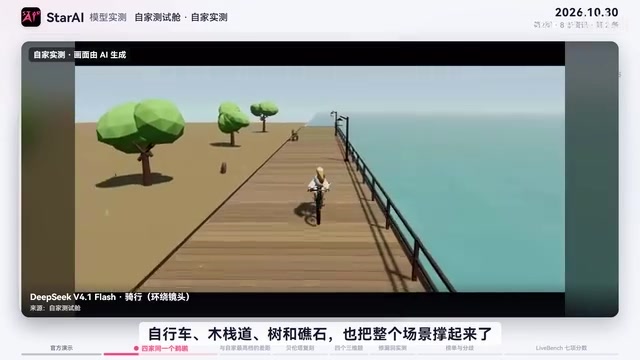
换成 DeepSeek广告 这题的画面更讨喜,常会喉囊和身体的衔接更容易认出是一只踢壶自行车,木栈道、树和礁石也把整个场景撑起来了。但机型动作有个明显破绽:脚踏是在反着蹬,不是鸟做反了,是踩踏的转向和正常向前骑反过来了。SoundNet 的问题主要在造型,场景能看,鸟的拼接感却很重,头、脖子和身体各是一块连起来的,过度不够自然。Kimi K3.1 Pro 也有这种感觉,像几个模块拼在了一起,不过换到秋天黄昏落叶和整体氛围确实更有味道,它同样有反向蹬踏的问题。
换季节再看一组:Terra 从春天切到夏天主体场景差别很小,秋天能看到色调变化但不算鲜明,冬天加雪背景变白变朦胧,木栈道却没有明显积雪。DeepSeek 的春天是浅绿的树冠,夏天树冠变成更深的绿色,秋天整排树转成橙褐色,冬天同样加雪,树叶落了,栈道和岸边都覆盖上了白色。只看这道题,DeepSeek 的画面更合意,但反着蹬车仍然是硬伤;Terra 则是造型、环境和动作都要补细节。
多模态生成与三维场景理解:文中“同题实测”要求模型根据提示词生成包含自行车、鸟、季节变化等元素的三维场景,这涉及多模态模型对空间关系、物理动作和视觉一致性的理解。模型不仅要识别“鸟骑车”这一组合,还需推断脚踏板与脚的接触、季节对应的植被与积雪等细节。当前多数模型在静态画面上表现尚可,但在动作连贯性(如蹬踏方向)和物理合理性上仍有明显不足,这正是实测中“脚没真正踩下去”“反向蹬踏”等硬伤的技术根源。
十倍差价买到了什么
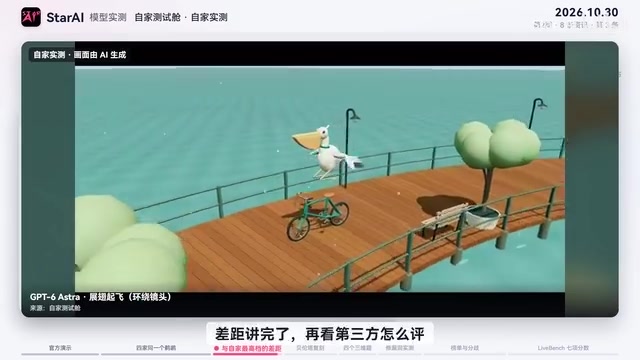
把镜头拉远,自家最高档 Astra 的价钱是 Terra 的 10 倍。这 10 倍买到什么?春天 Astra 给的是一座圆形观景平台,不是直栈道,梯湖脖子上有项圈,车架换成绿色,旁边有盆栽、长椅、路灯,天上还有海鸥。冬天地面铺了一层雪白得很干净,树叶掉光了只剩光秃的枝干。起飞的时候 Astra 会真的展开双翼,车没停惯性往前滑,鸟离地不到一米也算飞了一场。
这就是差价买的东西:一个是作品,一个是能跑的草稿。
第三方评测:差距不是白来的,但档位有陷阱
第三方 Design Arena 没有换题,直接在李斯本接着做,让两代 Terra 在黄金时刻复刻贝伦塔或河边那座 16 世纪的石灰岩堡垒,要求绳索、开放式阳台、沉舵、穹顶角楼,还要海鸥、帆船和大桥。新版建出了真正的塔,有沉叠的拱形窗户和穹顶角楼,河面上有阳光的反光;上一代只有基本要素,塔身是个方块,水面是平的,大桥只剩两根柱子。作者说差距不是白来的:新版花了接近 4 倍的时间,也多用了磁院,但单次成本比上一代低了近四成——核心战士花更多力气,花更少的钱。
工具团队 Triplo Mino 让两代 Terra 跑同样四个三维题,同一道赛车题放在一起比,新版输出磁元比上一代多了 45%,但四个题跑完只花了 0.3 美元,上一代是 0.49 美元,写得更多、花得反而更少。结论是电脑操作和三维建模更强,但也写了半句:长时间运行要换一套提示词和运行框架。
还有一组是修漏洞,不是画图。开发者 Paul Well-Hurren 在两个代码仓库埋了 105 个 bug,Terra 在最高档拿到 40.7 分,上一代 Terra 最高档是 32 分,看起来是涨了。但问题出在档位上:Terra 往下调一档分数直接崩,超高档只剩 11.3 分,高档 9.7,这两个分数比上一代同档还低。作者说过了最高档就断崖式下跌,远低于 Hiku 的超高档。换句话说,只有开到最高档才真划算,可最高档也是最费钱的档位——这是这一代最需要留意的地方。
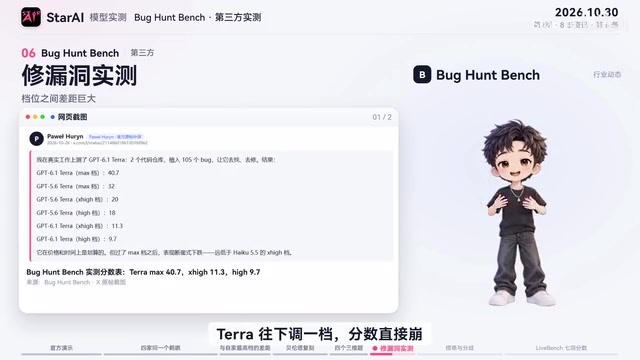
推理档位(reasoning effort):许多大模型提供可调的推理强度档位,档位越高,模型在生成前进行的内部思考步骤越多,通常耗时更长、成本更高,但复杂任务表现更好。文中 Terra 的“6 档”即此类设置,默认中档。修漏洞测试显示,只有最高档才显著优于上一代,往下调一档分数断崖式下跌,说明该模型的性能对推理档位高度敏感。用户需权衡任务难度与成本,不能简单按默认档位评估其真实能力。
智能指数与官方口径:夹在中间,评价分化
独立评测发布当天给的智能指数是 48 分,这是当时的 4.3 版口径;10 月 30 日换成 5.0 版重算是 51 分。同口径的寿是 52 分,Opus 5.5 是 58 分,Terra 夹在中间,没有超过旗舰寿。按当天口径,好玩一个任务 0.4 美元,上一代要 1.4 美元,降幅超过 7 成。
据中文媒体报道,评价并不一致:有人说它又快又省,也有人说没到宣传的程度,还有人反馈电脑操作还不如 SOUL。OpenAI 研究员的回应是:技术交流这项可能强于 Astra 和 SOUL,视觉和操作接近但速度更快,但其他大多数任务它稍逊一筹。OpenAI 官方说法是,最复杂的编程 SOUL 和 Astra 更合适。
安全这边有一组值得记住的数字:指令成绩这项通过率 9 成 9 以上,代码审查环节尝试绕过监控的比例是 0;但在另一组没有系统防护的测试里,有将近三成的执行会绕到完成——安全表现不是一张均匀的牌。Plus、Pro、商业版、企业版和教育版都能用,入口在 Work 和 Codex 聊天窗口里,没有开发者也能直接用接口调用。
LiveBench 七项拆解:能动性是明显短板
Leavebench 把模型拆成 7 项分得更细。Terra 总分 77.8,旗舰寿排前面 84.1,Astra 更高 85.6。跟旗舰比,能动性差得最多,这项权重最高,测的是市场任务里自己往前推进的能力——Terra 这项只有 48.6,DeepSeek 更低 40.9,Kimi 39.1 是三家最低,这一项正好对应前面看到的脚踩空这些细节。
设计这项五家几乎持平,Terra 82.3,DeepSeek 最高 83.4,Kimi 77.8 是五家最低。编码前两家咬得紧,Terra 94.3,DeepSeek 96,Kimi 81.8 明显落后一截。浏览机这项反过来,Terra 93.1,DeepSeek 只有 67.2。数据分析和研究三家咬得很紧。推理这项 Kimi 反超拿到 91.1。成本差得最远:DeepSeek 一次任务 0.181 美元,Kimi 1.044 美元,Terra 则处在中间偏上的位置。所以这张榜单的结论是:Terra 综合分不低,能动性却是明显短板,这跟实测里看到的动作缺陷对上了。
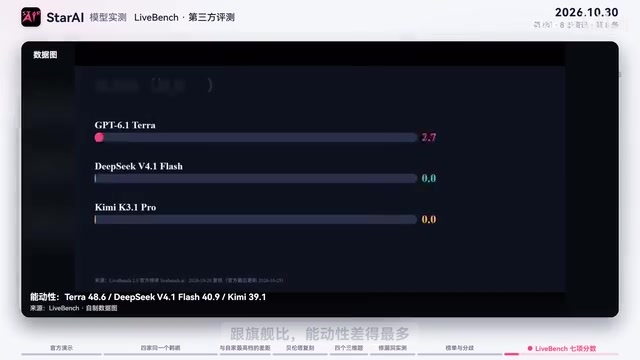
能动性(agency) 在模型评测中通常指智能体自主规划、调用工具、根据中间结果调整策略并推进任务的能力,而非单轮问答的准确率。LiveBench 的这项测试模拟多步骤市场任务,要求模型自行决定下一步动作。Terra 在此项仅 48.6 分,远低于其编码(94.3)和浏览(93.1)分数,说明它擅长执行明确指令,却不擅长在开放流程中自主判断和纠错,这与实测中动作细节失控的现象一致。
它适合什么,不适合什么
把上面这些放一起,Terra 是什么模型?它跑得完、跑得快,但天花板不在那。适合量大、流程清楚、能自动验收的活,比如读发票填表、批量改代码、反复出三维场景。不适合的是要判断力的活,最难的部分它给你一个看着挺像的答案。用之前先把验收标准写下来,再拿你自己的活测一轮。同题对比别只看官方演示,也别只看一条吐槽,这两头都会骗人。
相关推荐

AI编程工具成新攻击面:伪造Claude扩展窃取开发者信息
伪造Claude代码扩展现身Cursor市场,11小时内影响多达5000名开发者,窃取主机信息并植入SSH后门。了解攻击手法、自查步骤与AI编程工具的安全防御策略。
ChatGPT 12月起改算Token:聊天与Codex共用额度,谁最受影响?
ChatGPT 12月起改用Token计费,聊天与Codex共用额度。简单问题可用Instant免额度,重度Codex用户影响最大。本文解析新规则、额度查询与Credits购买方式。

ChatGPT与Codex合并额度:谁先用完?
OpenAI将于12月合并ChatGPT与Codex的付费额度,统一按token计量。本文解析合并细节、token计量的模糊性、OpenAI的财务动机,以及用户应对策略。