GPT-6.1 Terra对比Sol与6 Astra:三款模型实测怎么选

B站UP主用三关任务实测三款GPT模型,考察动画、跨模态与代码能力。
B站UP主「何极」将GPT-6.1 Terra、GPT-6.1 Sol和GPT-6 Astra放在同一套任务体系下横向对比,围绕动画生成、图像理解与再生成、网页开发三个关卡考察「谁能更快把活干好」。第一关生成「提壶骑自行车」动画,A出现腿线交叠的结构问题,B的脚踏与双腿联动相对完整,C保持简洁线条但细节待定;第二关采用「描述原图再生成」的闭环测试,跨模态一致性成为关键维度;第三关要求制作森林农舍网页并加塞移动控制需求,模拟真实开发中的增量修改场景。文章认为三款模型无绝对优劣,选型应匹配任务类型:视觉生成看动作逻辑,跨模态看一致性,开发看代码落地能力。
三款模型同台竞技:一场关于「干活效率」的实测
B站UP主「何极」在Day 7的测试中,把GPT-6.1 Terra、GPT-6.1 Sol和GPT-6 Astra放在同一套任务体系下横向对比。测试的核心问题很直接:三个AI,谁能更快把活干好?
这不是跑分式的参数比拼,而是围绕三个具体关卡展开的能力实测——动画生成、图像理解与再生成、网页开发。每关都设置了明确的观察点,最终以A、B、C三选一的方式让观众判断。
据该UP主的测试设计,三关分别对应多模态生成、跨模态理解和代码落地三类典型场景。这种任务组合比单一基准测试更接近真实使用:用户往往需要模型在连续、不同类型的任务中保持稳定输出。
第一关:提壶骑自行车,谁的动作更合理
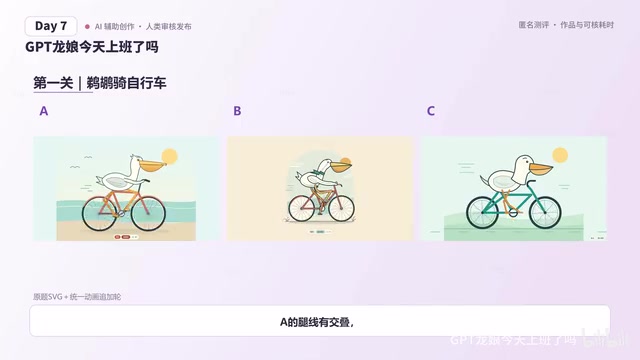
第一关要求模型生成「提壶骑自行车」的动画,观察点是车轮、脚踏和双腿是否都动起来。这一关考察的是模型对物理动作链的理解——骑行是一个多部件协同的动态过程,车轮转动、脚踏循环、双腿蹬踏三者必须逻辑一致。
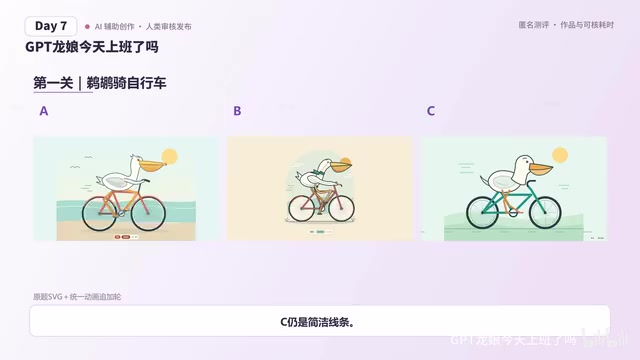
三个模型的输出出现了明显分化。A的腿线出现交叠,说明肢体在运动过程中产生了结构冲突;B的脚踏和双腿一起变位,动作联动关系相对完整;C则保持了简洁线条,但简洁是否意味着动作细节被简化,需要结合完整动画判断。
这一关的分歧点在于:动作完整性和画面简洁度之间存在取舍。腿线交叠是典型的生成瑕疵,而脚踏与双腿同步变位更接近真实骑行动作。UP主没有直接给出答案,而是把判断权交给观众——这种处理方式本身说明三款模型的差距并非压倒性,不同任务类型下各有表现。
动作链理解(action chain understanding)是视频生成模型的一项关键能力:模型不仅要逐帧生成合理的画面,还要在多帧之间维持物理因果的一致性。以骑行为例,双腿蹬踏驱动脚踏旋转,脚踏带动车轮转动,三者构成一条因果链。生成模型常见的失败模式是「局部合理、全局断裂」——单帧看肢体完整,但连续帧中肢体穿插、部件错位。评测这类动画时,通常需要同时检查结构稳定性(有无肢体交叠、穿模)和运动一致性(部件之间的联动关系是否符合物理逻辑),二者缺一都会导致动画不可用。
第二关:先描述再生成,跨模态一致性成关键
第二关是「表述原图」:先让模型描述一张图,再根据描述重新生成图片。这实际上是一个图像理解→文本表达→图像重建的闭环测试,考察的是模型能否在模态转换中保留关键信息。
这类任务在真实工作流中非常常见——比如设计稿转描述、描述转配图,或内容创作者用文字复现参考图。难点不在于单次生成质量,而在于描述环节是否抓住了原图的核心要素,以及生成环节能否忠实还原这些要素。
素材中没有披露三个模型在这一关的具体描述文本和生成结果对比,因此无法断言哪一款在跨模态一致性上更优。但从测试设计看,这一关更可能拉开模型间的差距:描述精度和生成忠实度是两个独立能力,任何一环掉链子都会导致最终结果偏离原图。
跨模态一致性(cross-modal consistency)衡量的是模型在不同模态之间传递信息时保持语义不变的能力。在「图像→文本→图像」的闭环中,它至少包含两个环节:一是图像描述是否覆盖了原图的关键要素(主体、构图、风格、色彩关系等),二是文本到图像的生成是否忠实还原了这些要素。这一指标与单纯的图像生成质量不同——一张好看的生成图可能严重偏离原图。业界常用CLIP Score等指标做量化评估,即计算生成图与原图在嵌入空间中的相似度,但人工判断在构图和细节还原上仍不可替代。
第三关:森林农舍网页,代码落地能力见真章
第三关要求「做一个森林里的农村小屋网页」,并加塞一个额外需求:增加移动控制。这一关从视觉生成跳到了前端开发,考察模型能否把自然语言需求转化为可运行的网页代码,并在追加需求时保持上下文连贯。
「加塞」是这关的亮点设计。真实开发中,需求很少一次说清,模型需要在已有代码基础上增量修改,而不是推倒重来。移动控制的加入意味着模型要理解交互逻辑,而不仅是静态页面布局。
对内容创作者和小型项目来说,这类能力直接决定模型能否充当「一句话出原型」的工具。素材同样没有给出三款模型的最终代码质量对比,但UP主把这一关作为压轴,暗示代码生成是区分度较高的维度。
增量式代码修改(incremental code editing)是多轮对话编程的核心场景。模型需要在已有代码上下文中定位修改点、保持未涉及部分不变,并让新增功能与原有结构兼容。这与从零生成整页代码的难度不同:上下文越长,模型越容易「忘记」原有约定或产生破坏性改动。评测这类能力时,常见观察点包括:是否只改动必要部分、新增的交互逻辑(如移动控制)是否与原有布局冲突、以及代码在浏览器中能否直接运行。对「一句话出原型」类工具而言,增量修改的可靠性往往比首次生成质量更能决定实际可用性。
三款模型怎么选:按任务类型对号入座
综合三关测试,三款模型的定位差异可以从任务维度拆解:
- 动画与多模态生成:关注动作逻辑完整性和画面结构稳定性。第一关中B的动作联动表现相对完整,A出现腿线交叠的结构问题,C以简洁线条呈现但细节程度待定。
- 图像理解与再生成:适合需要「看图说话再画图」的场景,如设计辅助、内容复现。跨模态一致性是核心指标。
- 网页与代码生成:适合快速原型开发,尤其是需求会迭代追加的场景。第三关的加塞测试正是模拟这种真实工作流。
据UP主在视频中的设定,答案放在评论区并指向「何极」的作品。这种互动式结尾说明测试结果并非单一维度的胜负,而是取决于用户更看重哪类任务。
选型建议可以归纳为:如果主要做视觉内容生成,优先看动画结构合理性和画面稳定性;如果工作流涉及图像转描述或描述转图,重点测试跨模态一致性;如果用于前端原型或小工具开发,代码落地和增量修改能力更关键。三款模型没有绝对优劣,任务匹配度才是选择依据。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。