GPT 6.1 Terra实测:速度快三倍、成本减半,却容易犯这些错

GPT 6.1 Terra 又快又省,明确任务接近 Source,开放设计则明显偷懒。
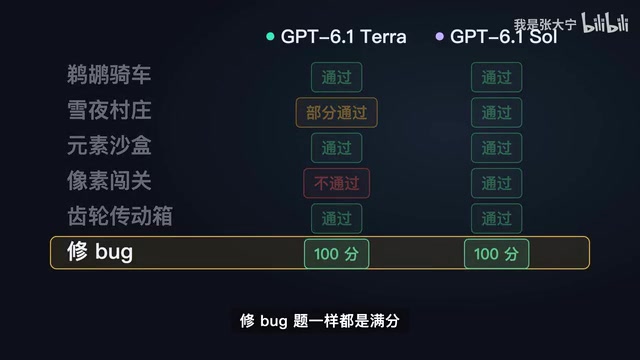
OpenAI 新发布的 GPT 6.1 Terra 价格仅为 Source 一半,实测速度是 Source 的 7 到 8 倍,全部题目耗时四分多钟对 36 分钟,积分消耗少约四分之三。在与 Source 相同的六道题测试中,Terra 在齿轮传动箱、元素沙盒、修 bug 等目标明确、对错可验证的任务上表现接近甚至满分,修 bug 题三次全满分;但在雪夜村庄和像素游戏两道需要自主设计决策的题目上明显偷懒:3D 场景缺少遮挡判断导致面片交叉出错,游戏关卡因跳跃参数不足而设计上打不通。根源在于思考 token 从数千压缩到几百。官方主打电脑操作与看图理解,复杂编码仍推荐 Source 和 Astral。
OpenAI 本周一发布了新模型 GPT 6.1 Terra,官方称其价格只有同系列 Source 的一半,在电脑操作测试中完成任务快三倍以上,基准跑分也逼近甚至超越 Source。但经过一整套与 Source 完全相同的题目实测后,Terra 的表现呈现出明显的两面性:在目标明确、对错清晰的任务上它又快又省,一旦需要模型自己做设计决策,它就会选择偷懒。
测试设置与速度优势
测试沿用上期评测 Gemini 4 Argon 时给 6.1 Source 跑过的题目:五道可视化题加上一道编程修 bug 题,全部使用相同的 Codex 命令行环境、相同的 Hai 思考档位。需要说明的是,Source 的数据来自上期评测,距今将近一个月,速度可能已有变化,因此横向对比只能作为参考。
速度上的差距非常明显。齿轮传动箱 Terra 只用 48 秒,元素沙盒 42 秒,醍醐骑自行车 32 秒——而 Source 动辄三五分钟。雪夜村庄场景 Terra 不到一分钟交卷,速度是 Source 的 7 到 8 倍。全部题目跑完,Source 花了 36 分钟,Terra 只需四分多钟;单价打对折,输出 token 又只有一半,按积分算消耗值少了四分之三。实测跑完整个评测,作者的 Plus 账号五小时额度只消耗了 6% 到 7%。
通过的三道题:达标但极简
齿轮传动箱的最低标准是运动模式正确、工程数值正确。Terra 做的是四齿轮方案,程序测试数值正确,运动轨迹没问题,界面干净,只有一根转速滑杆。它没有像 Source 那样额外做活塞位移曲线等设计,交付的是一个刚好满足要求的极简版本。
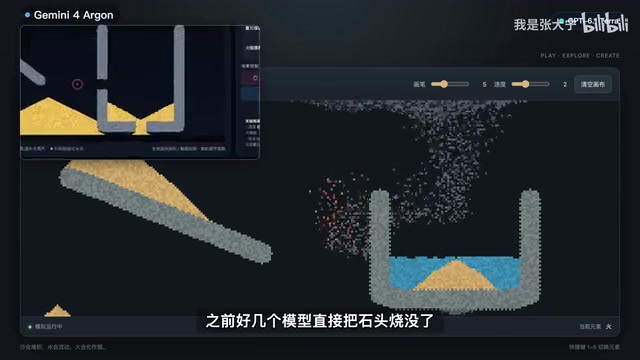
元素沙盒考验物理逻辑:沙子滑坡、水面沉浮、水火反应,火不能烧穿石头。此前多个模型直接把石头烧没了,Terra 完全正确。
醍醐骑自行车没有离谱错误,但翅膀直接贴在身上,车把都没有去扶,属于典型的"快点交卷、少做少错"。这三道题虽然都通过,完成速度却夸张得惊人——Source 同类任务往往要几分钟,Terra 的耗时远不止官方宣传的快三倍。
暴露问题的两道题:设计决策与检查缺失
雪夜村庄只用了不到一分钟,木屋、窗光、积雪的树、飘雪这些元素都在,拖拽、缩放、自动环游也正常。但问题同样明显:代码里写了月亮,可月亮仰角太高,镜头根本看不到——这和之前 Gemini 4 Argon 评测中犯的错误一模一样。换几个角度放大看,屋檐边还有三角形碎片戳出来,树的叶子穿到房子前面,树上的积雪被切成一段一段。
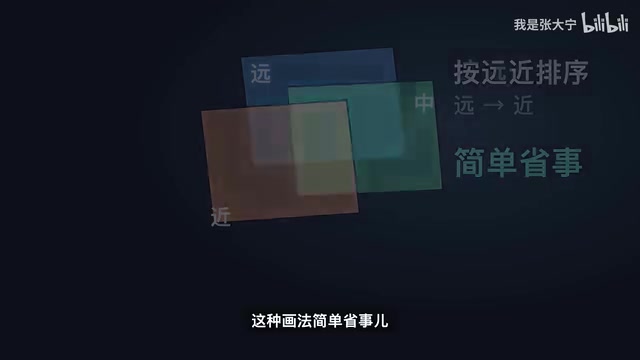
原因在于它没有做遮挡判断,而是把所有面片按远近排序,从远往近一层层画上去。这种画法简单省事,但面片一旦交叉,显示就会出错。上期 Source 用的是 WebGL,有深度判断,画面明显更精细。这道题 Terra 只能算部分通过。
超级玛丽式的像素游戏问题更严重。Source 上期做了 12 段的长关卡,花了 13 分多钟;Terra 只用了 83 秒。开局画面和进入游戏后的操作感觉还凑合,但很快暴露出设计上的偷懒:开头几段就是同一个组合反复出现,问号砖全都直接压在砖块上面纯粹是摆设,蘑菇藏在里面根本顶不到,也就无法变大。碰到第一根水管怎么跳都跳不上去——角色的跳跃参数最高只能跳 76.7 像素,而水管是 80 像素高,且水管出现在关卡 13% 的位置,后面还有 5 根一样高的。这导致游戏从设计上就打不通,这道题 Terra 不通过。
遮挡判断与画家算法
文中提到的“遮挡判断”,在计算机图形学中对应的是深度测试(Depth Testing)机制:渲染每个像素时,将其深度值与深度缓冲区中已记录的值比较,只有更靠近观察者的片元才会被写入,从而保证前后遮挡关系正确。
而 Terra 采用的“按远近排序、从远往近逐层绘制”是经典的画家算法(Painter's Algorithm)。它的优点是实现简单、无需额外缓冲区,但有一个致命缺陷:当两个面片在空间中交叉时,不存在“谁在前谁在后”的整体顺序,无论怎么排序都会出现部分区域被错误覆盖。这正是文中屋檐三角形碎片、树叶穿透房屋、积雪被切断等现象的根源。上期 Source 使用的 WebGL 默认支持深度缓冲,因此画面更精细,代价是需要正确处理深度精度、透明物体排序等额外问题。
修 bug 题:三次全满分
纯编码题给一个像素游戏项目,要求根据玩家投诉自行定位并修复四类埋入的 bug。整个测试跑三次,Terra 三次全拿满分,并且从根源上修掉了隐藏的 bug。上期 Opus 和 Argon 这一题都只修了一半。Terra 每次只用了 40 秒左右,而 Source 要三四分钟。这说明在目标明确、对错可验证的任务上,Terra 的能力与 Source 非常接近。
快和省来自哪里:思考量大幅压缩
同样是 Hai 思考强度,Source 在各类题目上的思考过程 token 一般是几千个,最多的一题接近 8000 个;Terra 顶多也就几百个,杀伐题甚至只有 56 个。这就是"又快又省"的代价——它不会多想,不会回头检查,怎么省事怎么来、怎么快怎么来,好不好全随缘。
思考 token 与推理成本
文中的“思考 token”指模型在给出最终答案前生成的内部推理内容所消耗的 token。在支持扩展思考的模型上,这部分 token 同样计入输出计费,且往往占据输出的大头。Source 单题思考数千 token、最多接近 8000,意味着它在解题时会进行多轮自我验证、方案比较和回溯;Terra 压缩到几百甚至几十 token,相当于跳过了这些步骤,直接给出第一版方案。
这解释了两个现象:一是速度与成本的大幅下降——输出 token 减半、单价再打对折,综合消耗自然降到四分之一;二是质量的分化——对于修 bug 这类“目标明确、对错可验证”的任务,第一版方案往往就足够正确,压缩思考几乎没有代价;而对于需要设计决策的开放任务,缺少自我检查就会把错误直接留在交付物里。
定位与适用场景
Terra 在目标明确、对错清楚的任务上与 Source 很接近,修 bug 题一样拿满分;但如果任务需要它自己做大量设计决定,比如一个 3D 场景用什么画法、一个关卡怎么摆,它就会明显偷懒。整体上任务结果稳定,但比 Source 差了一些。OpenAI 官方自己的表述也比较委婉,大意是复杂的编码任务仍然推荐 Source 和 Astral。
如果主力模型是 6.1 Source,Terra 恐怕无法完全取代它。实际上官方对 Terra 的主打方向是电脑操作和看图理解——Codex 本身的电脑操作能力就很强,即使用 Luna 也能满足大部分日常任务需求,只是慢一点。6.1 Terra 速度更快、成本更低,在这类场景下能带来更好的使用体验。
Codex 与模型分层
文中的 Codex 是 OpenAI 面向编码与电脑操作的智能体产品/命令行环境,模型在其中负责规划操作步骤、调用工具并执行任务。同一产品可以挂载不同档位的模型:Source 偏向能力上限,Terra 偏向速度与成本,Astral 则定位更高。
这也解释了官方为何把 Terra 的主打方向定为电脑操作和看图理解:这类任务的每一步操作目标明确、结果可即时验证(点击是否命中、界面是否变化),恰好落在 Terra 擅长的区间;而复杂编码任务需要大量架构层面的设计决策,正是它压缩思考后容易出问题的地方。因此模型选型的关键不是“谁更强”,而是任务是否需要模型自己做开放式设计。
相关推荐

beacon.sh:为AI编程助手装上自我进化记忆
beacon.sh 是一款开源、可自我进化的 AI 编程代理记忆层,支持 Claude Code、Cursor、Codex 等 20 多个 harness,把代理会话转化为复利式知识层,解决跨工具记忆断层问题。

Xmind 2027发布:思维导图进化为AI思考伙伴
Xmind 2027 在 Product Hunt 发布,主打「AI 思考伙伴」定位。新增 Xmind Agent 支持基于本地文档与导图做研究,并通过 MCP 将导图上下文接入 ChatGPT、Claude 等 AI 工作流。本文解析其产品逻辑、差异化优势与待验证的问题。

UnleashX:像雇人一样雇佣AI员工,对话直接交付成果
UnleashX在Product Hunt上线,主打像雇人一样雇佣AI员工:选角色、连CRM和工具、设规则,端到端执行工作流,人类仅在必要时介入。本文分析其产品定位、配置逻辑与人机协作边界。