GPT-6.1 Terra实测:速度惊人,效果却输给DeepSeek?

GPT-6.1 Terra 以极快速度完成前端任务,但效果不及慢工出细活的 DeepSeek。
OpenAI 中档模型 GPT-6.1 Terra 主打速度,在 B 站 UP 主实测中四道前端任务全部不到 5 分钟完成,而 DeepSeek V4.1 Flash 最快一道也要 1 小时 16 分,四道合计超 7 个半小时。Terra 的快来自首字延迟短、输出 Token 少(每道 1 万到 2 万,DeepSeek 为 28 万到 37 万)、自动开子任务并行。但因输出量小,单价贵七八倍的 Terra 总花费反而便宜四成。效果上 DeepSeek 完成度明显更高:熊猫闯关有三关与结算卡,我的世界有树有花有云并自我调整 39 次,3D 赛车有倒计时与飘移分数;Terra 的作品可玩但粗糙。官方数据与第三方评测也显示,Terra 在操作电脑方向表现接近 Soul,但真实工作任务 GDPVal 落后 100 多分,前端代码生成并非其强项。
一、速度与效果的反差
OpenAI 新发布的 GPT-6.1 Terra 主打“快”。在 B 站 UP 主的实测中,它用 3 分多钟就交出了能玩的 3D 赛车游戏,而 DeepSeek广告 花了近两个小时。但速度背后,效果却并不尽如人意。这期实测对比,揭示了模型定位与真实体验之间的落差。
二、模型定位与官方数据
GPT-6.1 Terra 是 GPT-6 家族的中档型号,价格每百万 Token 输入 1 美元、输出 5 美元,是 6.1 Soul 的一半,Astra 的十分之一。官方定位三件事:看图、操作电脑、写东西。基准测试上,Agent’s Last Exam 中档得分 57.6%,比上一代高 15 分;OS World 2.1 操作电脑 74.2%,超过上一代最好成绩;Terminal Bench 4.0 从 21.5% 提升到 50.3%。不过官方也承认,最复杂的编程任务仍建议交给 Soul 和 Astra。
第三方 Artificial Analysis 的独立评测中,Terra 综合智能指数 48 分,比 6.1 Soul 低 4 分,但每道题花费不到上一代的三分之一。在“不瞎编”一项上,不会的题硬猜比例从 88% 降到 38%。然而在 GDPVal 真实工作任务上,它比 Soul 和 Astra 低了 100 多分,官方宣传的“与 Astra 打平”并未完全复现。
Agent’s Last Exam 是一套面向 AI Agent(智能体)的基准测试,专门考察模型在真实、开放式任务中的自主规划与执行能力——不只是答题,而是要在多步操作中调用工具、读取文件、检索信息并做出决策。它被视为“Agent 能力”的高难度综合考卷,得分越高说明模型越能独立完成复杂工作流。文中 Terra 在该项拿到 57.6%,比上一代高 15 分,反映的是其“动手做事”能力的提升,而非单纯的知识问答水平。
OS World 则是评估模型操作图形界面(GUI)能力的基准环境,任务包括点击菜单、填写表单、跨应用切换等,模拟真人在桌面系统里完成操作。该基准的 2.1 版本提高了任务复杂度与界面多样性,因此 74.2% 的得分意味着模型在“像人一样用电脑”这一方向上已接近实用门槛。
Terminal Bench 聚焦命令行环境下的任务执行,考察模型能否在终端中编写并运行脚本、排查报错、完成文件与系统操作,是衡量“编程+运维”实战能力的基准。Terra 从 21.5% 提升到 50.3%,说明它在无人干预的命令行场景中进步显著。
GDPVal 则是一套以真实经济工作产出为标准的评测,直接拿实际岗位任务(如文档撰写、数据处理、代码交付)来打分,更贴近“能不能真的创造价值”。Terra 在此项比 Soul 和 Astra 低 100 多分,正解释了为何官方“与 Astra 打平”的说法在独立评测中没有完全复现——基准分数好看,不代表真实工作产出同等。
三、与 DeepSeek 的实测对决
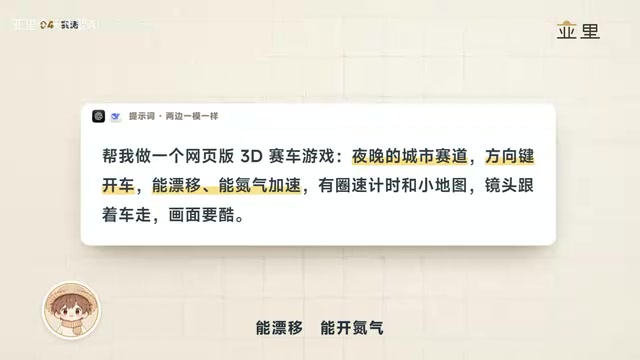
UP 主在同一台电脑上对比了 GPT-6.1 Terra(Codex 桌面版,Ultra 思考强度)和 DeepSeek V4.1 Flash 1017(闲时价,Max 思考强度)。四道题涵盖 2D 小游戏、网页版我的世界、3D 赛车和 SVG 动画。
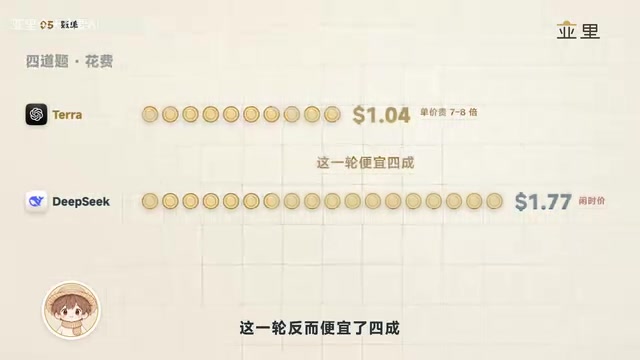
时间上,Terra 四道题全部完成不到 5 分钟,DeepSeek 最快的一道也要 1 小时 16 分,四道加起来超过 7 个半小时。花费上,DeepSeek 按闲时价算也要 1.77 美元,Terra 一共 1.07 美元——单价贵七八倍的 Terra 反而便宜了四成。原因在于 DeepSeek 每道题输出 28 万到 37 万 Token,Terra 只有 1 万到 2 万,文件体积也小一个数量级。
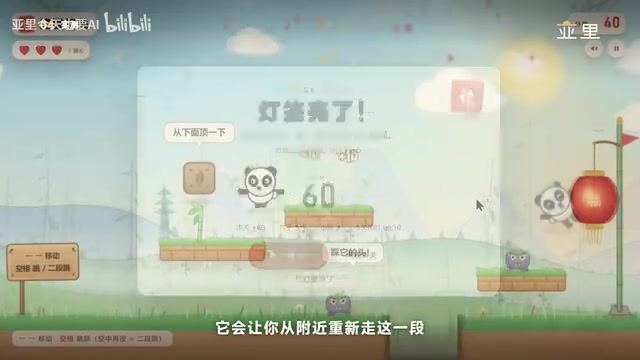
但效果上,DeepSeek 完成度明显更高。熊猫闯关游戏里,DeepSeek 做了三关,有气泡提示、结算卡和小剧情,手感更自然;Terra 只有一关,十几秒就跑完。网页版我的世界,Terra 画面乱晃、地图极小,物品栏只是平面方块;DeepSeek 有树有花有海有云,地图大得多,还自己反复截图调整了 39 次。3D 赛车对比更悬殊:Terra 车速慢、能开出赛道,一圈 15 秒;DeepSeek 有倒计时、飘移分数和完整赛道逻辑,视觉效果惊艳。
四、速度的秘密:想得少、等得短
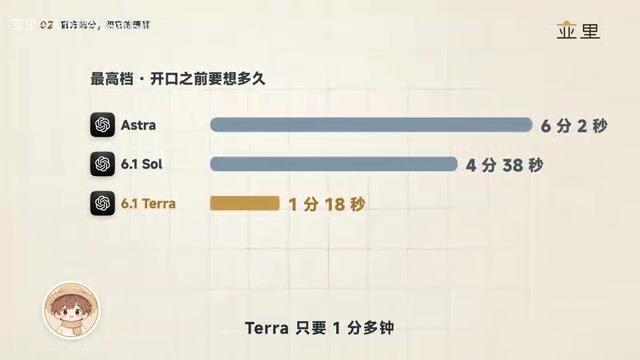
Terra 的快主要来自“想得少、等得短”。第三方数据显示,Terra 每秒输出 91 个 Token,比 6.1 Soul 的 74 和 Astra 的 66 都快,但比上一代 5.6 Terra 的 135 要慢。变化最大的是首字延迟:最高档下 Soul 要先想 4 分多钟,Astra 要 6 分钟,Terra 只要 1 分多钟;中档下 1.5 秒就开始回答。再加上画少、步骤少,整体完成速度就快得多。不过也有测试发现,最高档下 Terra 想得太多,反而比 Soul 还慢一点。
DeepSeek 慢的原因则在于“写得多、测得多”。以我的世界这题为例,它一共走了 196 步,真正出字的时间只有 45 分钟,每秒 130 多个 Token 其实不慢。最花时间的是每一步开始前的等待——它把每一步的代码和截图都带在对话里,越往后越长,最后有 36 万 Token,每走一步都要重新读一遍。加上测试环境没装子任务插件,所有事都得自己从头干到尾。而 Codex 这边,Terra 每道题都会自动开两三个子任务并行。
首字延迟(Time to First Token, TTFT) 指从发出请求到模型吐出第一个 Token 的等待时间,它直接决定用户“感觉快不快”。大模型在给出答案前往往先进行一段内部推理(尤其是高思考强度档位),这段思考不产生可见输出,却会拉长首字延迟。Terra 把最高档的首字延迟从 Soul 的 4 分多钟、Astra 的 6 分钟压缩到 1 分多钟,中档甚至 1.5 秒即开始回答,这正是“体感快”的主因。
与之相对的是每秒输出 Token 数(TPS),衡量的是“说得多快”。Terra 的 91 TPS 虽高于同代两款,却低于上一代 Terra 的 135,说明它的速度优势并不在吐字速率,而在于缩短前置思考与减少总输出量。
子任务并行(Sub-agent / Task Delegation) 是 Agent 框架里的一种调度机制:主模型把大任务拆成若干子任务,分派给并行的子 Agent 同时执行,再汇总结果。Codex 桌面版会为每道题自动开两三个子任务并行推进,因此整体耗时被显著压缩。
DeepSeek 一侧因测试环境未装子任务插件,只能串行地从头做到尾;更关键的是上下文累积问题——它把每一步的代码与截图都保留在对话历史中,导致上下文越滚越长,最后达到 36 万 Token,每走一步都要重新读取整段历史,等待时间因此被成倍放大。这解释了为何它每秒吐字并不慢(130 多 TPS),总耗时却长达数小时。
五、值不值得用?
GPT-6.1 Terra 的性价比确实高,一直被吐槽的速度这次终于提上来了。操作电脑才是它的主打方向——OpenAI 员工演示过填同一张很长的网页表单,Terra 用了 53 秒,6.1 Soul 要三分多钟;官方 OS World 跑分里准确率也和 Soul 差不多。但就前端代码生成这类任务而言,实测效果一般,甚至有点像在给 DeepSeek 做宣传。
DeepSeek 做出来的东西确实更好,但你得有耐心等。OpenAI 给 Terra 的口号是“Seize it, does it”——看到就去做。至少在“快”这件事上,它确实做到了。
相关推荐

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。

trainlint:静态检查揪出不会崩溃的 ML 训练 Bug
trainlint 是一个静态检查工具,能找出不会报错的机器学习训练 bug,包括数据泄漏、eval 模式残留、softmax 与 CrossEntropyLoss 冲突等十四类问题。本文介绍其原理、验证结果与局限。