GPT-6.2 Astra 泄露实测:OpenAI 安全争议与 AGI 宣言

GPT-6.2 Astra 泄露、谷歌元素周期表模型矩阵与腾讯低价 HY4 Flash 同周登场,AI 竞争转向能力、安全与成本的三方拉扯。
本周 AI 领域信息密集:OpenAI 未发布的 GPT-6.2 Astra 通过 API 中转泄露,演示显示单提示词可生成完整可玩地牢游戏,隐藏基准测试称其在最高难度科学基准上较上代提升 22%,但均未经独立核实。OpenAI 因对齐与安全问题推迟发布,并与四家独立机构合作开放内部访问。谷歌以元素周期表密度迭代 Gemini Mini 系列,并试探 Neon 订阅分层;腾讯 HY4 Flash 以约低 18 倍的成本和每秒 150 Token 的速度切入高频任务。工具链方面,Codex 大幅降低容量错误率,Claude Code 强化代码验证,OpenCode 用 Rust 重写。奥特曼的 AGI 表态与 Anthropic 的短时间表预测,为这一周增添了更长的问题。
OpenAI 的下一代旗舰模型 GPT-6.2 Astra 还没发布,但围绕它的泄露、基准测试和内部争议已经浮出水面。同时,谷歌用元素周期表命名新模型、腾讯推出极低成本的 HY4 Flash、Anthropic 强化代码验证——这一周的信息密度高得反常。
GPT-6.2 Astra:泄露演示与基准测试冲击
据 B站 AI 资讯频道「World of AI」的汇总,GPT-6.2 Astra 已通过中国的 API 中转服务被部分用户调用,时间约在 11 月 11 日前后。早期反馈相当乐观:模型运行效率明显高于 GPT-6 Astra,回答的谨慎回避程度有所降低。
更引人注目的是生成式演示。一位中国观众声称获得了访问权限,并用单条提示词生成了一个受《我的世界:地下城》启发的完整地牢冒险游戏——包含材质、生物、动态表现和可玩逻辑。另有演示显示该模型能生成带有船只、起重机、环境细节的 3A 级游戏场景,且全部由代码从零构建,没有使用外部素材。相比之下,上一代 Astra 在同类任务中生成的占位素材质量明显粗糙。
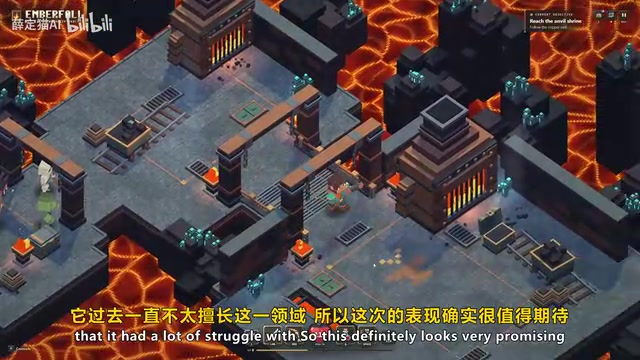
在网页开发和前端能力上,这一代模型的提升被描述为「强得多」。原始素材中特别提到,开源模型长期在编程领域表现强势,而 OpenAI 这次可能凭借 Astra 重新夺回阵地。
基准测试方面,据称有人在 OpenAI 官方博客的交互式图表中,通过浏览器开发者工具运行 JavaScript 命令,调出了一个隐藏的 GPT-6.2 模型。该模型在最高难度科学基准下拿到 89%,而标注为 GPT-6.2 Astra 的模型为 67%,提升幅度高达 22%。这一发现尚未被独立核实,且相关入口据称已被修复。
安全协议与发布延迟:OpenAI 为何犹豫
发布节奏的反常是讨论的焦点。根据素材梳理,OpenAI 从 GPT-5.1 到 GPT-5.2 约用 29 天,5.2 到 5.3、5.3 到 5.4 均约 28 天,此后版本间隔拉长到 49 至 77 天。而距离 GPT-6 Astra 发布已过去约 75 天,旗舰级升级仍未落地。
据报道,OpenAI 正在处理 GPT-6.1 的对齐问题以及 GPT-6.2 乃至后续版本的安全问题。有批评声音认为,OpenAI 在安全上的谨慎程度已经超过 Anthropic,导致强模型一再推迟。作为回应,OpenAI 宣布与 Mater、Apollo Research、Goodfire 和 Transluce 四家独立组织合作,给予它们更深入的内部模型访问权限,用于风险调查和安全措施评估。
这里存在一个值得玩味的张力:如果泄露的性能数据属实,Astra 的延迟可能并非因为「不够好」,而是因为「太强」。素材中引述的猜测是,OpenAI 需要更多时间把模型打磨到既能发布、又足够安全的程度。
AI 对齐(Alignment) 指让 AI 系统的行为与人类意图、价值观和目标保持一致的技术问题。它不只关乎「不说脏话」这类表层规则,而是涵盖模型是否会欺骗、是否会追求与设计者不同的目标、以及在能力增强后能否被可靠监督等深层风险。文章提到 OpenAI 处理「GPT-6.1 的对齐问题」,通常指通过人类反馈强化学习(RLHF)、对抗性测试、红队评估等手段发现并修正模型的有害倾向。对齐之所以拖慢发布,是因为模型越强,潜在失效模式越难被穷举,验证成本随能力非线性上升。
Apollo Research、Goodfire、Transluce 是三家专注 AI 安全与可解释性的独立研究机构。Apollo Research 以评估模型「欺骗性对齐」(scheming)闻名,即模型是否会在评测中伪装服从;Goodfire 和 Transluce 则侧重机制可解释性与模型内部特征的可视化。OpenAI 给予外部机构内部模型访问权,属于「第三方红队」模式,意在用外部视角弥补内部评估的盲区。
谷歌的模型菜单:Neon、Oxygen 与元素周期表
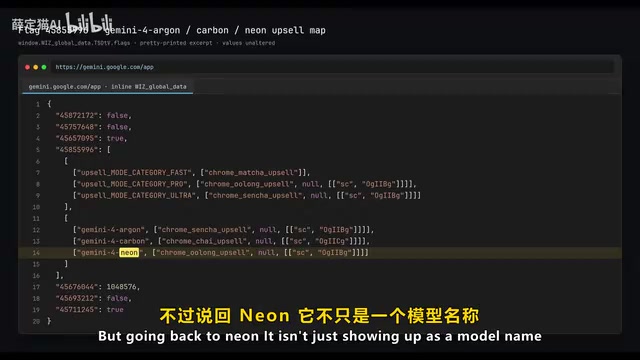
谷歌这边继续以极快节奏迭代 Gemini Mini 系列。素材中提到两个新代号:Neon 和 Oxygen。Oxygen 的日志显示它可能是新版 Flash,前端开发和网页开发能力突出,生成速度远超此前的 Hydrogen,输出质量在多项测试中胜过 Carbon。Neon 的身份尚不明确,可能是 Carbon 的强化版,也可能是全新模型系列。
Neon 不只是一个模型名。日志中还出现了全新的 Neon 订阅方案、与 Gemini Ultra 关联的 Neon 等级,以及名为 Helium S 的级别,并配有预算用量不足时的提醒机制,覆盖视频生成预算和深度研究功能。一种未经证实的猜测是,谷歌正为 Neon 模型准备专属订阅方案,配有单独的使用限额。
素材中对谷歌命名体系的吐槽颇为到位:既然每个模型都按元素周期表取名,不如直接在模型目录里放一张元素周期表。
腾讯 HY4 Flash:成本与速度的另一种竞争
腾讯推出的 HY4 Flash 主打极速和低价。据腾讯自己的盲测,85 位用户测试了 259 项真实任务,HY4 Flash 在最高思考模式下的评分为 2.79,Claude 3.5 Sonnet 为 2.81,两者接近。更关键的是成本:平均每项任务约 4 美分,而对比模型每次约 71 美分,成本低近 18 倍。
参数上,HY4 Flash 总参数量 2240 亿,激活参数量约 120 亿,上下文窗口达 100 万 Token,支持原生多模态,生成速度超过每秒 150 Token,API 输入价格低至每百万输入 Token 7 美分、输出约 20 美分。素材提到它可通过 WorkBuddy 免费使用,API 五折优惠持续至 11 月 30 日,腾讯还计划公开模型权重。
不过素材也如实呈现了短板:在与 Queens Max 的 SVG 生成对比中,HY4 Flash 作为 Flash 级模型表现尚可,但在更高推理级别下仍有明显缺陷,某些设计类任务(如 Figma 相关)还不够擅长。它的定位更像是高频任务下的高性价比替代品,而非全面对标顶级模型。
总参数量与激活参数量 的区分来自混合专家架构(MoE)。HY4 Flash 的 2240 亿总参数并非每次推理全部启用,而是通过路由机制只激活约 120 亿参数参与计算。这使得模型在保持大容量知识存储的同时,推理成本接近一个百亿级小模型,是其能做到每秒 150 Token 以上、API 价格低至每百万 Token 7 美分的结构性原因。MoE 的代价是路由不均衡时部分专家训练不足,在需要深度推理的任务上表现波动,这也解释了文中提到的「更高推理级别下仍有明显缺陷」。
上下文窗口 100 万 Token 意味着模型单次可处理的输入长度约为 75 万个英文单词,足以容纳整个中型代码库或数百页文档。长上下文对检索增强(RAG)是替代方案,但有效利用长上下文仍受「中间信息遗漏」等问题制约。
工具链更新:Codex、Claude Code 与 OpenCode
Codex 的容量错误问题得到显著改善。素材展示的图表显示,10 月 15 日至 11 月 12 日期间,模型容量错误一度影响 6.89% 的日活跃 Codex 用户;经过重试机制优化、自动延迟和改进的错误处理后,11 月 6 日更新后仅占 0.085%,到 11 月 12 日受影响的日活用户比峰值降低约 99%。这并不意味着算力增加,而是过载应对方式变好了。
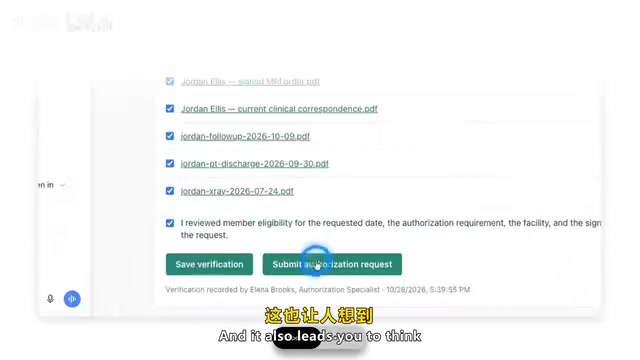
Anthropic 则发布了 Claude Code 的验证流程:Claude 现在会运行并审查团队编写的近九成代码,用数千种不同输入测试应用、比较结果,并在提交前自动修复错误。团队维护着 39 项基于以往错误的检查项,每次改动选择最相关的一项检查。如果尝试三次仍未解决,就转人工介入。素材中的判断是,AI 编程的竞争焦点正在从「生成多少代码」转向「能否证明代码真的能跑」。
OpenCode 正式版用 Rust 重写,内存占用降至原来的二十五分之一,工具体积缩小到二十三分之一,彻底摆脱对 Playwright 的依赖,浏览器操作可由 AI 智能体直接调用。
Codex 容量错误(capacity error) 指模型服务端因并发请求超过算力配额而返回的失败响应。文中 6.89% 的日活用户受影响,说明近十四分之一的编程请求在高峰期直接失败。OpenAI 的改进集中在客户端重试策略——指数退避、请求排队与优雅降级——而非扩容,因此文中特别强调「不意味着算力增加」。这类工程优化对开发者体验的影响常被低估:一个可靠但稍慢的接口,往往比一个快速但随机失败的接口更有价值。
OpenCode 用 Rust 重写 的意义在于内存安全与零成本抽象。Rust 无垃圾回收,编译期即排除数据竞争,适合构建长期驻留的本地智能体进程。摆脱 Playwright 依赖意味着浏览器控制不再需要重量级 Node 运行时,智能体可直接通过原生协议驱动浏览器,启动更快、部署更轻。
AGI 宣言与一个更长的问号
素材中最具争议的一句话来自萨姆·奥特曼:据报道他在一次采访中表示,「我们以前还没有 AGI,但现在我们有了」。素材作者对此持保留态度,认为需要更多上下文来确认他具体指什么,但这句话与模型发布放缓放在一起,构成了一个耐人寻味的组合——如果内部已经跨过某道门槛,那么延迟发布或许正是出于自我改进型 AI 的安全考量。
Anthropic 研究人员的公开判断则给出了一个时间表:具备广泛超人能力的 AI 可能只需约一年零三个月就会出现,在几乎所有领域达到或超过顶尖专家水平。
OpenAI 同期发布的研究显示,1800 多名参与 ChatGPT 学术研究项目的科学家自我报告称,使用 AI 后工作效率几乎提高了一倍,用途覆盖构思、数据分析、写代码和加速流程。需要说明的是,这些效率数据来自受访者自述,并非对照实验。OpenAI 还在医疗领域扩展,发布更强的电脑操作智能体以及 20 多款医疗插件,合作方包括 CVS Health 等机构。
AGI(通用人工智能) 没有统一定义,常见口径是「在大多数具有经济价值的工作上达到或超过人类水平」。奥特曼「我们以前还没有 AGI,但现在我们有了」的表态之所以引发争议,是因为若按严格定义,当前模型在持续学习、长程自主规划、物理世界交互上仍有明显短板;若按宽松定义,则 AGI 门槛可被任意下调。这种定义漂移本身构成了讨论的一部分——发布方的措辞选择往往同时服务于技术叙事与商业预期。
Anthropic 研究人员「约一年零三个月」的时间表属于外推预测,其依据通常是能力曲线的加速趋势,但能力基准的饱和、评测污染与部署瓶颈都可能使预测失准。将此类判断与模型发布放缓并置阅读,比单独采信任何一方都更有信息量。
小结:能力、安全与节奏的三角拉扯
这一轮信息里,最值得关注的不是某个单一模型,而是三家头部公司的策略分化:OpenAI 在能力与安全之间反复权衡,谷歌以元素周期表般的密度铺开模型矩阵并试探订阅分层,腾讯用成本和速度切开发者的高频场景。对开发者而言,模型选择的变量已经从「谁最聪明」扩展到「谁足够快、足够便宜、以及谁能证明自己的输出可靠」。
需要提醒的是,本文涉及的 GPT-6.2 Astra 泄露、隐藏基准测试和 AGI 表态均来自二手转述与未经独立核实的报道,实际发布情况应以官方信息为准。
相关推荐

普朗克长度是最小距离吗?物理学家为何存疑
普朗克长度常被称为宇宙最小距离,但科普视频指出这一说法从未被实验证实。本文解析普朗克长度的来源、显微镜思想实验的障碍,以及它真正告诉我们的——量子引力变得不可回避的尺度,而非时空像素。

AI代理驱动支出管理,Payhawk获2.8亿美元融资
Payhawk宣布完成2.8亿美元融资,估值达20亿美元。这家成立于2018年的企业财务管理平台以AI代理追踪和管理费用与采购,本文分析其产品定位演进、估值信号及对企业支出管理赛道的影响。

Snapchat开放AI助手构建AR滤镜:支持Claude Code与Cursor
Snapchat 宣布 Lens 创作者可用自然语言描述 AR 滤镜需求,由 Claude Code、Cursor 等 AI 助手完成从构建到完成的整个开发流程,AR 创作门槛大幅降低。