GPT-6.2 Astra曝光:SVG生成与OpenAI硬件野心

模型能力继续爬坡,但竞争重心正转向硬件、可信度与工程效率。
过去24小时的AI动态显示,模型能力仍在提升,但竞争焦点正在转移。传闻中的GPT-6.2 Astra最低推理档成绩已超过上一代全力水平,不过部分SVG演示被检出借助图像或视频工具,演示效果需打折。Anthropic开源Flash Proof,用密码学证明验证模型回复真实性,效率较早期方案提升数个量级,同时更新Claude Code。腾讯HY4加入视觉能力并计划开源权重,匿名模型Cruton Alpha疑似出自Meta。基础设施层面,Anthropic与OpenAI自研芯片,DeepSeek计划主用华为昇腾950训练V5,马斯克则警告芯片产量与发电能力将在2026年底相撞。
AI圈的信息密度正以肉眼可见的速度攀升。B站UP主WorldofAI最新一期的AI新闻汇总,把过去24小时里最值得关注的几条线索串了起来:OpenAI传闻中的GPT-6.2 Astra、腾讯开源的HY4、Anthropic的密码学证明项目Flash Proof,以及DeepSeek转向华为芯片的长期布局。这些事件单独看都是新闻,放在一起则勾勒出一条更清晰的脉络——模型能力在继续爬坡,但竞争的重心正在向硬件、可信度和工程效率转移。
GPT-6.2 Astra:能力传闻与真实性验证
据WorldofAI的汇总,GPT-6.2 Astra已在Codex桌面应用的模型选择器中被发现,同时模型追踪器上短暂出现过两个候选ID,几分钟后消失。UP主对这些ID的解读保持谨慎,认为"rc"可能代表发布候选版,"vm"可能暗示某种计算机使用环境,并提醒此前Aurora Alpha被误传为Astra的先例,说明命名推测并不可靠。
更值得关注的是能力数据。据视频中引述的报道,在Bench 2.0基准上,一个内部模型得分0.875,而Astra为0.594;更关键的是,该内部模型的最低推理档就拿到0.758分,已经超过Astra全力运行时的成绩。这种"下限超过上一代上限"的模式,与视频中提到的纳维-斯托克斯方程相关突破的描述相互印证。
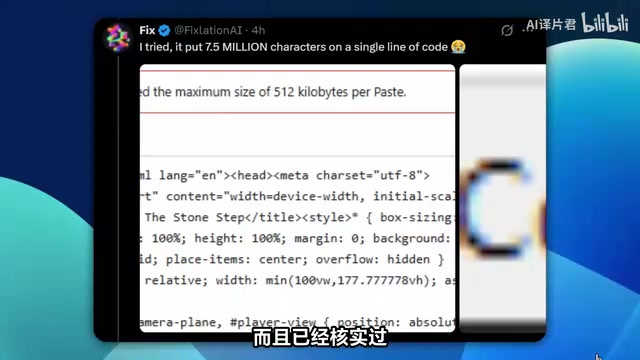
SVG生成是这轮演示中最抓眼球的部分。GPT-6.2 Astra能够用代码生成经典游戏截图、细胞结构图甚至可动画化的像素场景,其中一段演示被描述为在单行代码中放入了约750万个字符。不过UP主也做了一次重要的交叉核查:X上流传的部分作品被AI图像检测工具检出OpenAI水印,说明这些图并非纯SVG生成,而是借助了3D工具、Python工具乃至OpenAI自家的视频模型。这个细节提醒我们,演示效果和模型原生能力之间需要打一个折扣。
从代码到实体:OpenAI的硬件实验与生态扩张
OpenAI在这次更新中展示了ChatGPT和Codex如何参与现实世界的硬件设计。两名员工用GPT-6 Astra在不到一周的时间里设计出一台与Codex通信的原型设备,Astra几乎参与了外壳、电路板、用户界面和软件的全部设计环节,当然最终成品仍需多轮人工审查和修改。OpenAI还与Chip Ganassi Racing合作将3D扫描转化为可编辑的CAD模型,与马自达合作探索AI驱动的车辆设计模拟。
生态方面,Unity为Codex推出了官方插件,可直接通过OpenAI插件目录获取,让Codex调用Unity的专用技能。ChatGPT的理财功能加入了语音模式,允许用户连接财务账户后直接对话查询支出与储蓄情况——UP主对此明确表达了个人的保留态度,不会把财务数据交给ChatGPT。
Anthropic双线推进:Flash Proof与Claude Code更新
Anthropic开源了Flash Proof,这项技术试图解决一个长期存在的信任问题:你付费使用某个高级模型,如何验证服务商没有偷偷换成更便宜的模型?Flash Proof用密码学证明从数学上验证一条回复确实来自声称运行的那个模型。在Meta的Llama 4 Maverick(4000亿参数)上测试时,单块NVIDIA H100 GPU生成证明的速度达到每秒110个Token,每个证明约19MB。作为对比,UP主提到早先一个叫Burlab的系统生成的证明约93.6GB,验证要花将近一整天。Claude本身参与了Flash Proof的构建,其安全保证用Lean数学证明助手做了形式化验证。
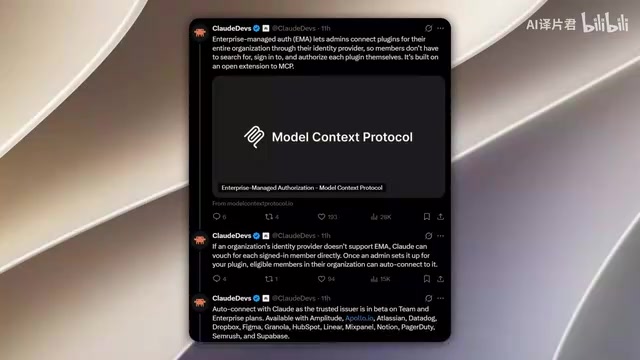
Claude Code则汇总了一批10月更新:长对话可在提示缓存过期前自动压缩以减少Token消耗,支持UltraThink临时启用最高推理强度并能给子代理分别设定推理级别,斜杠Usage命令可查看额度占用,长时间终端命令超时后转为后台继续运行。企业侧的改进是通过MCP扩展让云端充当可信身份签发方,管理员可统一配置插件访问权限。
密码学证明与模型验证:Flash Proof依赖的密码学证明,核心是零知识证明(ZKP)思想的一种工程化变体——证明者(模型服务商)在不泄露模型权重的前提下,向验证者(用户)证明某条输出确实由特定模型计算得出。传统做法是重新运行模型并比对,但代价高昂且无法防作弊;密码学方案则通过可验证计算(verifiable computation)将推理过程转化为可被数学检验的证明。此类方案长期受制于证明生成开销,Flash Proof的价值在于把单Token证明成本压到可用水平(H100上110 Token/秒、约19MB/证明),使其从理论走向工程可行。
Lean数学证明助手:Lean是一款交互式定理证明器,广泛用于形式化数学。在AI安全语境下,它的作用是把"某段代码满足某条安全性质"转化为可机器检验的数学命题,再由人工或工具完成证明。相比测试和审计,形式化验证能覆盖所有输入而非抽样,代价是需要把系统行为精确建模。Claude参与构建Flash Proof并用Lean做安全保证的形式化验证,意味着验证链条本身也经过了严格检查。
腾讯HY4与神秘模型Cruton Alpha
腾讯发布HY4,加入视觉能力,覆盖前端开发、金融、游戏研究和办公效率等场景。按腾讯自己的测试,HY4在Apex Agents上拿到75.2分,超过DeepSeek广告 4.1 Flash十月版本的72到73分左右,但UP主也指出两个模型在其他基准上互有胜负。定价为每百万输入Token 83美分、输出Token 2.5美元,腾讯还计划发布模型权重。一个值得注意的细节是训练数据策略:腾讯删除了用于攻击性网络安全的训练数据,保留防御性安全数据,让模型专注于找漏洞和威胁分析而非发动攻击。演示中最惊人的是一个通过MCP桥接虚幻引擎做出的可玩第一人称射击游戏,经过多轮提示迭代才达到该细节水平。
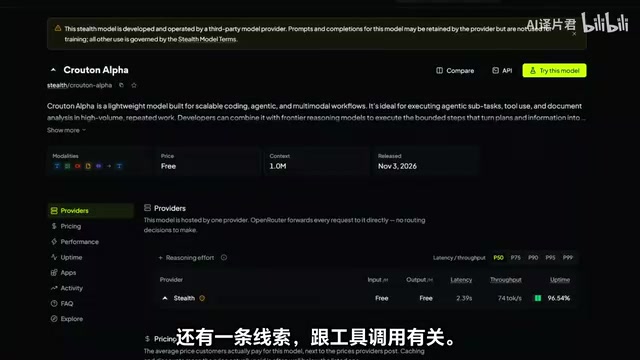
另一个匿名模型Cruton Alpha出现在OpenRouter上,完全免费,支持100万Token上下文和多模态输入。多项线索指向Meta:屏蔽的国家列表与Meta API一致,在某个生僻日语词上的错误与Meta的Muse模型相同,工具调用只接受自动选择这一设置也与Muse Spark 1.3 API一致。但UP主也指出反证——它的Tokenizer与Meta公布的不匹配。实测表现以智能体编码见长,速度接近GPT-6.1级别,配合OpenCode等框架效果更好。
芯片、算力与监管:基础设施层的博弈
据The Information报道,Anthropic正用Claude帮助自己设计AI芯片,芯片设计团队仅有15名工程师,Claude对芯片和模型架构的理解让公司能在远短于传统所需的时间内上线新的加速器平台。OpenAI也在研发自己的芯片。话说回来,据报道DeepSeek计划主要用华为昇腾950芯片训练下一代大模型,从4月起就与华为紧密合作优化软件栈,9月发布多款昇腾优化工具,10月推出同时支持英伟达和华为硬件的推理引擎。DeepSeek V5可能成为首个主要用国产芯片训练的大模型,目标定在2027年。
马斯克则发出另一个维度的警告:AI芯片产量正以惊人速度增长,但中国以外的发电能力扩张跟不上,两股趋势可能在2026年底相撞,届时企业手里的芯片可能因电力不足而无法运行。这是预测而非事实,但背后的电力瓶颈确实存在。监管层面,德州作为美国最大的数据中心枢纽之一翻蓝,即将上任的州长支持在建立更严格监管前暂停数据中心开发,而微软刚宣布当地一个吉瓦级数据中心项目,谷歌承诺到2027年投入400亿美元。
昇腾950与国产算力栈:华为昇腾系列是国产AI加速器的代表,其软件栈CANN对标英伟达CUDA。训练大模型迁移到昇腾,难点不在单卡算力,而在编译器、算子库、通信库和框架适配的成熟度——这也是DeepSeek从4月起与华为联合优化软件栈、9月发布优化工具、10月推出双硬件推理引擎的原因。推理引擎同时支持英伟达和华为,说明短期仍是混合部署,而V5若真以昇腾950为主力训练,将是国产芯片在超大规模训练上的首次完整验证。
AI数据中心的电力约束:马斯克所说的"电力墙"指的是AI集群的功率密度与电网扩容速度之间的错配。一座吉瓦级数据中心相当于数十万户家庭的用电量,而新建发电、输电和并网审批通常以年计,芯片产能则以季度计。德州作为数据中心聚集地,其监管转向会直接影响项目落地节奏;谷歌承诺的400亿美元投资能否兑现,也取决于电力与许可。电力正从后台成本项变成选址与扩张的一阶约束。
其他值得留意的动态
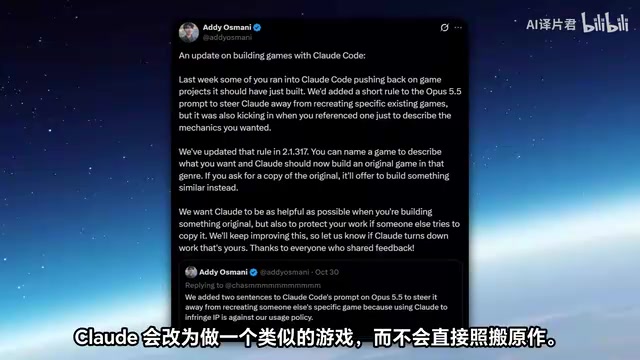
Anthropic在Opus 5.5中加入的版权规则一度矫枉过正,连完全原创的游戏都拒绝制作。据Claude Code开发者确认,该规则已在21.3.1.7版本更新:现在可以引用现有游戏来描述想要的玩法机制,Claude会做出受启发但原创的作品,只有明确要求复刻时才会改为制作类似游戏。
开源项目Terminal Mac允许在现有终端里运行完整macOS环境,通过MCP和agent技能支持计算机操作,可以让Claude Code等工具在隔离环境中操作应用而不干扰主桌面。ZIFO推出的分层注意力机制将信息组织成树状结构只搜索相关分支,据称在1000万Token时最高快35倍、10亿Token时可达400倍,且能适配现有模型无需从头训练。小米的CyberOne人形机器人在自家电动汽车工厂完成了8小时班次,分解和更换汽车零件并与自主移动机器人配合,背后是预训练超过10万小时真实机器人数据的RoboticsOne基础模型。
安全方面,币安承认10月29日一起严重安全事故,据报导致约63.4亿美元数字资产被盗,有报道将其关联到一名开发者在搭建项目时安装Homebrew引入的漏洞。这条提醒所有用AI辅助写代码的人:开发工具链本身就是攻击面。
纵观这一轮更新,模型能力的绝对提升仍然是最显眼的部分,但真正决定下一阶段格局的,可能是Flash Proof这样的可信度基础设施、DeepSeek与Anthropic的芯片自研路径,以及马斯克口中那道电力墙。演示可以惊艳,落地要靠这些不那么上镜的东西。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。