GPT-6.2 Astra实测:办公、游戏、3D与视频全通关
UP 主实测 GPT-6.2 Astra:多任务独立交付,token 效率显著提升
OpenAI 发布 GPT-6.2 系列后,B 站 UP 主对 GPT-6.2 Astra 进行了多场景实测。该模型在 Epoch AI 综合能力榜以 174 分并列第一,在 Artificial Analysis 的 3D 生成榜以 1318 分居首。实测中,它 11 分钟完成 Excel、Word、PPT 投资分析三件套,16 分钟生成可玩的赛车游戏,21 分钟产出可交互拆解的 3D 机械模型,8 分钟修复真实开源贪吃蛇项目的食物重叠 bug,18 分钟生成动画短片,且 token 消耗比 GPT-6.1 少近 25%。作者认为,agent 自主工作能力与 token 效率是本次最突出的两点提升,但复杂任务耗时较长,实时交互场景仍受限。
OpenAI 正式发布了 GPT-6.2 系列,包含 GPT-6.2 Astra 和 GPT-6.2 Asset 两款模型。据 B 站 UP 主实测,Astra 版本在 Epoch AI 综合能力排行榜上拿到 174 分,与 CloudFable 5.2 并列第一;在 Artificial Analysis 的交互式 3D 生成排行榜上以 1318 分拿下榜首。这些数字来自第三方评测,而 UP 主更关心的是:它在真实任务中到底有多强?
办公三件套:11 分钟生成完整投资分析包
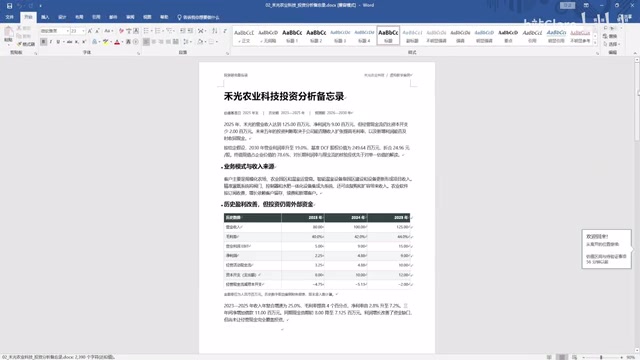
UP 主首先把 Excel 表格、Word 文档和一份 PPT 模板一起拖给 ChatGPT,要求预测公司未来收入、构建财务模型、生成投资分析报告,并按照模板产出投资人汇报 PPT。模型切换到 GPT-6.2 Astra,性能拉满。
处理完毕只用了 11 分钟,三个结果文件全部交付,PPT 内容填充完整。对比来看,效果直观且完成度高。更关键的是,UP 主提到 GPT-6.2 消耗的 token 比 6.1 少近 25%,在长流程办公任务中这意味着成本显著下降。这种“一次输入、多文件输出”的能力,已经接近一个初级分析师加设计师的组合。
Token 消耗是大模型 API 计费的基本单位,一个 token 大致对应英文的 0.75 个单词或中文的 1–2 个汉字。对于 agent 类长流程任务,模型需要反复读写文件、调用工具、维持上下文,累计消耗的 token 量往往远高于单轮问答,因此 token 效率直接决定单次任务的实际成本。文中提到 GPT-6.2 比 6.1 少消耗近 25% 的 token,在规模化使用场景下(如企业批量处理文档、持续运行的编码 agent)会带来可观的费用差异,也让长时间自主运行更具备经济可行性。
代码与 3D:赛车游戏和机械模型都能搞定
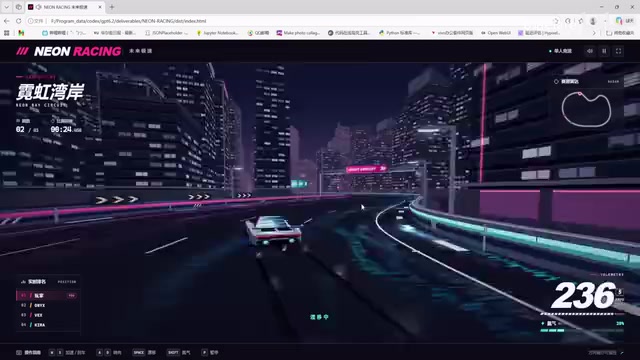
编码任务被交给 Codex,模型同样选择 GPT-6.2 Astra 并开启最高性能。UP 主要求做一款未来都市风格的赛车游戏,大约 16 分钟后游戏生成完毕。本地打开后,WASD 控制、Shift 氮气加速、漂移和暂停功能全部正常,侧边游戏窗口也能直接弹出试玩。
空间理解与设计能力测试中,UP 主让模型生成越野小车的 3D 交互模型。21 分钟左右完成,模型支持自由旋转、视角切换、爆炸视图和装配演示,还能查看所有单件及设计说明。UP 主特别提到,这一环节同样比 GPT-6.1 更省 token。从游戏到工业级 3D 展示,Astra 展现出的不只是写代码,而是对空间结构和交互逻辑的理解。
Codex 是 OpenAI 面向代码场景的 agent 产品形态,与普通聊天窗口的区别在于它能直接读写项目文件、运行命令、迭代调试,而不只是输出代码片段。文中把编码任务“交给 Codex”,意味着模型在一个具备执行环境的工作区中自主完成从编写到验证的闭环,这也是它能在 16 分钟内产出可直接运行的游戏、并在后续修复真实开源 bug 的前提。
修复真实开源 Bug:8 分钟定位贪吃蛇食物重叠
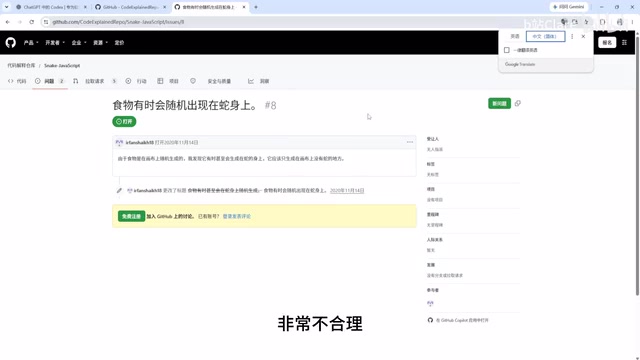
UP 主在 GitHub 上找到一个贪吃蛇开源项目,issue 中有人反馈食物偶尔会生成在蛇身上。作为“高玩”,主播先手动复现了一次,确实发现了这个 bug。
回到 Codex 输入提示词,要求根据项目和问题修复 bug。约 8 分钟后修复完成,模型给出了修复前后的截图对比。UP 主本地运行并多次测试,食物重叠问题没有再出现。这个测试的价值在于:它不是凭空造一个 demo,而是在真实开源项目的代码上下文中定位并解决问题,对开发者来说更具参考意义。
仓库级代码理解是评估编码 agent 的关键维度。真实开源项目往往包含数十个文件、多层依赖和既有代码风格,bug 的根因可能藏在与报错位置相隔较远的逻辑中。模型需要在完整代码上下文中检索、定位问题点,并给出不破坏其他功能的修改,这与在空白环境里生成 demo 的难度完全不同。文中贪吃蛇食物重叠的修复,正是对这一能力的检验:它要求模型理解食物生成逻辑与蛇身坐标判断之间的耦合关系。
视频生成:18 分钟产出动画短片
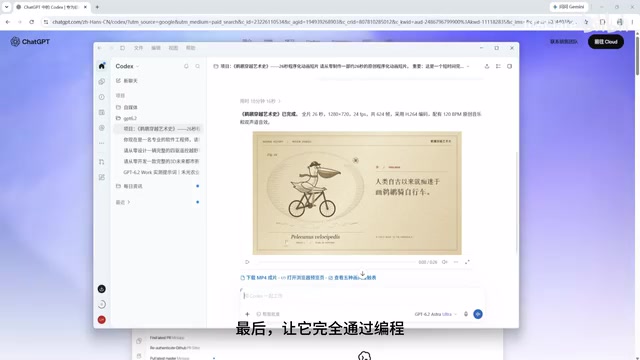
最后一项测试是视频生成。UP 主输入提示词,要求生成一段骑自行车的动画短片。GPT-6.2 花了 18 分钟完成,效果让 UP 主直呼“很不错”。
从办公文档到游戏开发,从 3D 建模到 bug 修复,再到视频生成,GPT-6.2 Astra 在 UP 主的实测中覆盖了多种复杂任务。其突出特点可以归纳为两点:一是 agent 自主工作能力更强,能在较长流程中保持目标不跑偏;二是 token 消耗更低,让高强度使用更具可持续性。
实测结论与观望点
这次实测来自单一 UP 主的个人体验,样本有限,但任务设计覆盖了办公、编码、3D 和视频四个方向,参考价值不低。Epoch AI 和 Artificial Analysis 的榜单成绩提供了第三方佐证,说明 Astra 的综合能力确实处于第一梯队。不过,视频生成耗时 18 分钟、3D 模型耗时 21 分钟,说明复杂任务仍需要等待,实时交互场景还谈不上。
对于开发者和创意工作者,GPT-6.2 Astra 的吸引力在于“一个模型打通多类任务”的潜力,以及 token 效率提升带来的成本优化。至于它是否“强得离谱”,实测结果至少证明:在结构化任务上,它已经能独立走完从输入到交付的完整链路。
Epoch AI 与 Artificial Analysis 是两家常被引用的第三方模型评测机构。前者以综合能力基准和趋势分析见长,后者侧重多模态与交互式任务的横向对比,其排行榜分数通常由标准化测试集汇总而来。需要注意的是,榜单分数反映的是受控条件下的平均表现,与具体任务的完成质量、耗时和成本并不完全对应,因此文中 UP 主的实测与榜单成绩互为补充:榜单说明模型处于第一梯队,实测则揭示其在真实工作流中的可用性与局限。
相关推荐
GPT Plus订阅全攻略:从注册到选档一步到位
基于B站教程整理:ChatGPT Plus订阅全流程指南。从零注册账号、Go/Plus/Pro三档套餐对比,到快速完成支付的实操步骤,帮你避开注册失败、选错档位、付款卡壳三大坑,找到最适合自己的订阅方案。
GPT-6.2 Sol/Astra发布:ChatGPT Plus订阅指南与套餐对比
GPT-6.2 Sol/Astra发布后,ChatGPT会员怎么选?本文整理B站教程精华,详解Go、Plus、Pro三档区别与适用人群,并附账号注册与快速订阅实操步骤,帮你选对套餐不花冤枉钱。
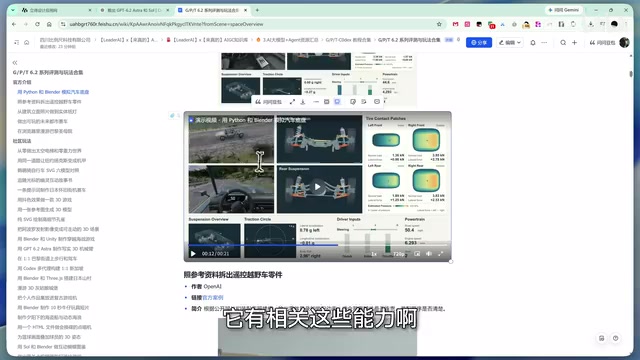
GPT 6.2 Astra/Sol社区玩法合集与深度评测
GPT 6.2 Astra/Sol 社区玩法合集与深度评测:3D建模和Computer Use能力突出,但美学对齐与意图理解短板明显。对比Claude Fable 5.2的实测数据与性价比分析,帮你判断适用边界。