GPT-6.2 Astra泄露实测:前端能力炸裂,OpenAI为何迟迟不发?

GPT-6.2 Astra 泄露显示能力跃升但被安全顾虑按住,竞争焦点转向验证与发布节奏。
本期汇总了前沿模型的多项动态:疑似 GPT-6.2 Astra 在 BioBaseExpand 基准上从 67% 跃升至 89%,早期案例显示其前端与游戏生成从占位符直接产出成品级素材,但 OpenAI 因安全与对齐问题推迟发布,并与四家独立机构合作开放内部模型审计。谷歌 Gemini Neon、Oxygen 等命名密集出现,迭代节奏处于历史高位;腾讯 HY4 Flash 以每任务 4 美分、便宜近 18 倍的成本提供接近的用户满意度。开发者侧,Codex 容量错误下降约 99%,Claude Code 转向验证自身代码,Hugging Face 与 OpenRouter 打通。Altman 的 AGI 表态与超人类时间线亦被提及,但需谨慎看待。
OpenAI的下一代旗舰模型GPT-6.2 Astra,在正式发布前就被推到了聚光灯下。据B站UP主WorldofAI的梳理,距离GPT-6 Astra发布已过去约75天,而GPT-6.2 Astra的早期访问结果和疑似泄露的基准测试成绩,正在描绘一个能力显著跃升、却因安全顾虑被按住的模型。
泄露的基准测试:科学推理提升明显
最引人注目的线索来自OpenAI自己的网站。据WorldofAI援引一份报告,OpenAI在一张新版交互图表中,意外暴露了一个隐藏的第八个模型——疑似GPT-6.2 Astra。在BioBaseExpand基准测试中,该隐藏模型在最高设置下达到89%,而GPT-6 Astra为67%,提升约22个百分点。WorldofAI在视频中明确表示,这一发现尚未经过他的独立验证,且相关问题据称已被修复。
如果这一数据属实,它指向的是模型在科学推理类任务上的大幅跨越,而非单纯的对话体验改进。这类基准往往更能反映模型在复杂推理上的真实水位。
BioBaseExpand 并非业界通用基准,从名称看属于面向生物医学/科学文献推理的扩展型评测集,通常用于衡量模型在需要多步专业推理、跨段落信息整合任务上的能力。这类领域基准(如 GPQA、PubMedQA)往往比通用对话评测更能区分模型的推理深度,因为题目要求模型具备专业背景知识并避免表面模式匹配。需要说明的是,单一基准上的大幅提升未必能线性外推到其他能力,且该数据来自疑似泄露的图表,未经独立复现,解读时应保持谨慎。
前端与游戏生成:从占位符到成品素材
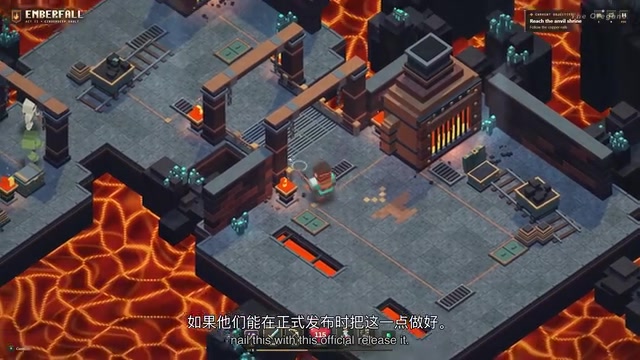
比基准数字更直观的,是早期用户放出的生成案例。WorldofAI展示了一个据称由GPT-6.2 Astra仅凭单条提示生成的完整地牢探索游戏,包含可开启的宝箱、多种怪物、复刻原版游戏的动态机制,以及细致到纹理层面的场景细节。
更值得关注的是生成方式的变化。据WorldofAI观察,此前用GPT模型生成游戏时,模型会先放置基础占位对象,再替换为合适的三维素材;而GPT-6.2 Astra直接产出的占位符本身就已接近成品游戏素材,代码完全由模型自行编写,未使用外部素材或工具。在3JS自行车生成对比中,GPT-6.2 Astra的整体生成质量也优于前代Astra。
据WorldofAI和部分提前获得访问权限的用户反馈,GPT-6.2 Astra在网页开发和前端任务上的表现明显优于前代,同时“少了一些防御性和限制性”。这恰好是OpenAI模型此前相对吃力的领域。
安全协议与发布节奏的拉扯
能力越强,发布越慢。据WorldofAI援引的报道,OpenAI正艰难应对影响GPT-6.1、GPT-6.2乃至GPT-6.5的安全与对齐问题;模型能力已足以支撑大规模训练,但转化为安全可靠的公开可用模型需要额外数周时间。有报道甚至称,OpenAI在安全顾虑上变得比Anthropic还要谨慎,这也是GPT-6.1 Astra最初发布被取消的原因之一。
与之呼应的是,OpenAI宣布与Apollo Research、Goodfire、Transluce等四家独立机构合作,让它们获得对内部模型的更深访问权限,以调查风险并评估安全防护。WorldofAI还提到,OpenAI工程师有几条已被删除的推文,暗示公司在一次安全事件后变得极其谨慎。
在WorldofAI看来,延迟的原因可能是双重的:模型确实还没完全准备好,同时它也强大到需要额外防护才能发布。
Apollo Research、Goodfire 与 Transluce 均属于 AI 可解释性与安全评估领域的研究机构:Apollo Research 以模型欺骗行为(deceptive alignment)的红队评估著称;Goodfire 专注机械可解释性,通过识别模型内部特征来理解和干预行为;Transluce 则致力于用可解释性工具审计模型输出。让外部机构获得对内部模型的深度访问权限(而非仅通过 API 调用),意味着研究者可以检查模型权重、激活值和训练细节,这是前沿实验室在发布前进行第三方风险审计的常见做法,也反映出监管与行业自律对“发布前验证”的更高要求。
谷歌的模型命名已接近元素周期表
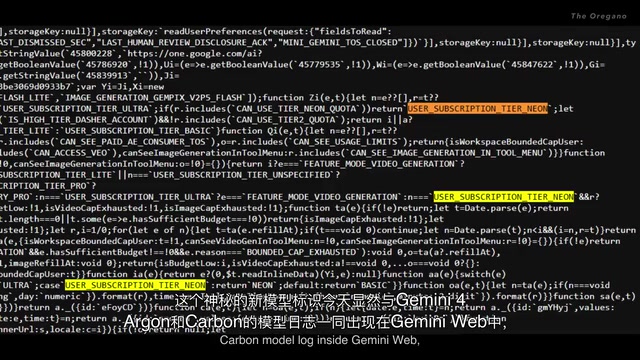
另一边的谷歌,发布节奏处于历史高位。据WorldofAI在X上发布的后端日志观察,Gemini Neon和Gemini Oxygen两个新标识出现。Neon不仅作为模型名出现,还与一个独立于现有Ultra的订阅层级关联,同时出现了与Gemini Plus关联的Helium层级,以及针对视频生成和深度研究低使用预算的警告系统。Oxygen则疑似Gemini 4家族的新Flash成员,速度极快,在前端和网页开发上表现突出,部分测试中甚至优于Carbon。
WorldofAI的吐槽颇为精准:如果谷歌打算用元素周期表上的每一种元素来命名模型,不如直接把元素周期表摆进模型目录。这背后是谷歌模型迭代速度前所未有的事实,也让人重新讨论谷歌是否已经跨过了某个门槛。
腾讯HY4 Flash:便宜近18倍的Flash竞争者
腾讯推出的HY4 Flash主打极低价格下的极快性能。据腾讯自己的盲测,该测试涉及85名用户和259个真实世界任务,HY4 Flash在最高思考模式下用户满意度为2.79,而HY4 5.5为2.81,差距极小;但平均任务成本仅4美分,对比后者的71美分,便宜近18倍,且平均每个任务耗时约6.7分钟,速度更快。
规格上,HY4 Flash总参数量2240亿、激活参数120亿,上下文窗口100万Token,具备原生多模态能力,生成速度超过每秒150个Token,API定价起步为每百万输入Token 7美分、每百万输出Token约28美分。腾讯还计划发布开放权重。WorldofAI的判断是,它难以在原始智能上匹敌Claude Haiku 5.5,但对需要大量日常任务、且速度与成本同等重要的开发者而言,是一个有吸引力的替代选项。
“总参数量”与“激活参数”的区分对应混合专家(MoE)架构:模型整体包含 2240 亿参数,但每次前向推理只激活其中约 120 亿参数,因此计算成本接近一个 120 亿参数稠密模型,却能借助更大的参数池获得更强知识容量。这正是 HY4 Flash 能做到低价、高速(每秒 150+ Token)且仍具备原生多模态能力的关键。百万级上下文窗口则意味着单次可处理超长文档或代码库,但实际有效上下文长度往往低于标称上限,使用时仍需验证长文本下的检索与推理稳定性。
开发者工具链:从生成转向验证
Codex方面,OpenAI公布了容量错误的修复进展。据WorldofAI引用的图表,10月15日至11月12日期间,一度有6.89%的Codex日活月用户至少经历过一次容量相关错误;经过重视指令、自动延迟、WebSocket错误处理等改进后,11月12日该比例降至0.085%,降幅约99%。WorldofAI指出,这不一定意味着算力增加,更多是系统应对过载的方式改善了。
Anthropic则发布博文解释Claude Code如何验证自己的工作。据其披露,Claude现在编写和审查了Claude团队近90%的代码。核心问题是:谁来确保AI生成的代码真的能跑?他们的做法是让Claude实际运行真实应用、测试数千种输入并比较结果,在提交前自动修复漏洞,还创建了斜杠验证技能,三次尝试后仍失败则交由人类介入。团队维护了39项基于以往漏洞的检查,每项变更核查最相关的一项。WorldofAI的评价是,AI编程的竞争重点已从“能生成多少代码”转向“能否证明代码有效”,尤其在同时运行几十个编程智能体时,验证与生成同等重要。
“验证与生成同等重要”背后是 AI 编程范式从单轮补全向多智能体编排的转变。当开发者同时运行数十个编程智能体时,代码产出的速度远超人工审查能力,瓶颈从“写得出来”变成“确认写得对”。Claude Code 的做法——实际运行应用、用数千种输入做差分测试、在提交前自动修复、失败三次后升级给人类——本质上是在智能体循环中嵌入自动化测试与形式化检查,把传统软件工程中的持续集成与回归测试思路迁移到 AI 生成流程中。39 项基于历史漏洞的检查清单则相当于把已知故障模式固化为回归用例。
开源模型接入与生态更新
Hugging Face与OpenRouter的集成让开发者可以用现有的Hugging Face令牌和API直接调用模型,由OpenRouter根据价格、速度和可靠性自动选择最佳提供商,并在提供商不可用时自动故障转移,无需管理多个供应商。另一项更新允许将请求追踪记录直接保存到Hugging Face存储,用于评估、调试甚至微调。
其他动态包括:谷歌为Gemini Notebook加入将资料转化为可交互、可分享网站的功能,面向全球18岁及以上网页端用户开放;反重力(Anti-Gravity)据报将Gemini for Carbon、Hydrogen和Argon的上下文窗口从256K翻倍至512K tokens,上下文压缩次数减少3.5倍;OpenCode Browser 0.10用Rust重写,内存占用降低25倍、体积缩小23倍,并移除了对Playwright的依赖;微软在Ignite大会前泄露了MAI Code to Flash模型卡,预计作为Flash层级模型发布。
AGI表态与超人类时间线
据WorldofAI援引的采访,Sam Altman表示“我们之前没有AGI,但现在我们有了”,并提到可能在递归自我改进上比现在更激进。WorldofAI对此持谨慎态度,认为需要更多上下文才能判断其真实含义,但若属实则可能解释OpenAI放慢模型发布节奏的原因。
同一期内容还引用了一位Anthropic研究员的判断:广泛意义上的超人类AI可能只需约1.3年就会到来,时间点指向2027年底前后,届时AI在几乎所有领域都能达到甚至超越顶尖专家水平,包括编程。这类时间线预测分歧极大,读者宜将其视为单一来源的观点而非共识。
OpenAI同期发布的研究显示,ChatGPT学术研究者项目中超过1800名参与者报告,使用AI后生产力几乎翻了一倍,用途涵盖头脑风暴、数据集分析、写代码和加速科研流程。需注意这是自我报告数据。OpenAI还宣布了更强的计算机使用智能体和超过20个医疗健康插件,Abridge、Ambiance、Signa以及CVS Health等机构将其用于保险事前授权、患者转诊、出院规划和外联等行政任务。
小结
这一轮信息里,最确定的信号是:头部模型的竞争焦点正在从“能不能生成”转向“能不能验证”和“敢不敢发布”。GPT-6.2 Astra的前端能力泄露让人兴奋,但OpenAI的安全协议和发布延迟说明,能力与可控性之间的张力正成为旗舰模型发布的真实瓶颈。对开发者而言,Codex容量错误的大幅下降、Claude Code的验证工作流、Hugging Face与OpenRouter的打通,都是比模型跑分更直接影响日常效率的变化。
相关推荐

AI时代为何必须掌握Git:从版本控制到Agent协作
Git和GitHub有什么区别?AI Agent写代码后如何用Issue、分支和Pull Request管理改动?本文基于NetworkChuck的Git教程,梳理从git init到冲突处理的完整流程,并分析AI时代版本控制为何成为必备技能。
OpenAI 6.2 Astra实测翻车:跑分惊艳,为何开发者却说难用?
OpenAI 6.2 Astra 跑分全面领先且价格更低,但早期测试者反馈其在长任务中频繁卡死、输出难以解析、资源管理失控。本文梳理实测中的真实体验与官方数据之间的落差,并分析这对开发者选型的意义。
GTA VI咖啡系统细节曝光:热咖啡竟能泼人?
Vergecast播客揭秘GTA VI咖啡系统:玩家可在公寓冲泡、自动贩卖机购买、餐厅点单,甚至将热咖啡泼向他人。这种对日常交互的细致还原延续了荒野大镖客2的沉浸感设计,引发对游戏细节与玩法平衡的讨论。