GPT-6.2 Astra与Sol实测:降价20%为何更贵更慢?
GPT-6.2 降价但同题实测更贵,关键在任务难度与推理档位的取舍。
文章从 OpenAI 对 GPT-6.2 系列的价格调整切入,指出 Astra 的 API 单价虽降约两成,但同题开到 Max 档位实测反而从 63 美分涨到 89 美分。官方定位 Astra 做复杂多步骤硬任务、Sol 管日常场景,升级仅覆盖 GPT-Work、Codex 和 API。作者用估值表、机甲城市、百合花教具和代码回归四类测试对比四款模型,发现旧版 Astra 在教具任务中以约 20 万 token 八分钟交付,新版约 40 万,6.2 Sol 补跑高达约 205 万 token。结论是先用“够用标准”定任务难度,再决定推理档位;同时 OpenAI 与 Anthropic 正围绕等待时间定价,形成“花钱买速度”与“用时间换折扣”两种模式。
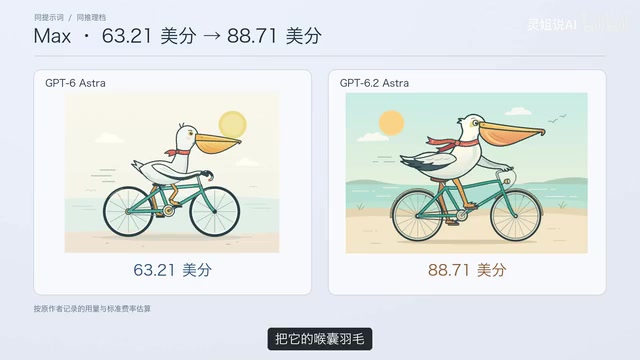
OpenAI 对 GPT‑6.2 系列做了价格调整,Astra 的 API 输入输出费用都降低了约两成。但降价并不等于省钱——有网友用同一句话、同样开到 Max 推理档位,结果旧版 Astra 花了 63 美分,新版 6.2 Astra 却花了 89 美分。这期视频从官方文档解读出发,结合四款模型同题实测,试图回答一个问题:什么样的任务才值得切到 GPT‑6.2?
官方定位:Astra 做难活,Sol 管日常
这次升级只落在 GPT‑Work、Codex 和 API 上,普通聊天入口的用户基本感受不到变化。官方给两款模型的定位很明确:Astra 负责复杂、多步骤的硬任务,Sol 则是日常款。官方重点展示的能力方向,是文件处理、电脑操作、搭建交互,以及让多步骤任务更省事。
一个官方案例很有代表性:新旧两代 Astra 拿同样的数据做估值表。旧版把各业务收入放在另一个标签页,估值算法和每股结果放在表格下方;新版则把收入构成、估值推导、假设变动摆到同一页。开会时有人问“哪个业务在撑着公司估值”,顺着同一页就能查到。生成结果更贴近实际决策场景,这是 6.2 Astra 最核心的升级逻辑。
但问题也随之而来:普通人真的需要那么复杂的估值表吗?实测中用一份公开 Excel 题测试,题目明确数据位置、画什么线、纵轴范围,两代 Astra 和两代 Sol 四款模型都找对了 41 天的数据,也都交付了可编辑图表。这说明在接近日常工作强度的任务上,各档位模型都能完成得不错:如果任务不够复杂,新模型带来的收益有限,成本却没有明显下降,切换的意义就不大。
创意三维能力:滚珠连锁与机甲城市
官方文档里另一个亮点是创意与三维审美。OpenAI 公开的滚珠连锁演示案例,制作过程从波道和多米诺起步,接着做机关、修镜头、加声音、修回放。这个案例说明 6.2 Astra 能把原型一轮一轮往前推,在 3D 交互场景里有优势。
网友的测评更直观:给两款 6.2 模型同一道题,让纽约州一座城市从地图上站起来变成机甲,走过纽约几个区。Astra 版本是一块发亮的地图上黄色机甲先蹲着再站直;Sol 版本是灰色机甲,肩膀上还能看到几栋楼。两台机甲都站起来了,但细节处理不够到位——顺着地图很难看出哪个街区变成手、哪块地变成脚。
GLB 是 glTF 二进制格式的文件扩展名,属于 Khronos Group 制定的 glTF(GL Transmission Format)3D 场景交换标准。它把模型的几何、材质、纹理、动画和场景层级打包进单个 .glb 文件,相比 .gltf + 外部贴图的组合更便于分发,浏览器和多数 3D 查看器可直接加载。对模型生成任务而言,GLB 既是交付物格式,也是可验证的中间产物:能否导出合法 GLB、层级结构是否合理、贴图是否正确内嵌,往往比渲染截图更能反映生成质量。
四款模型同题实测:百合花教具
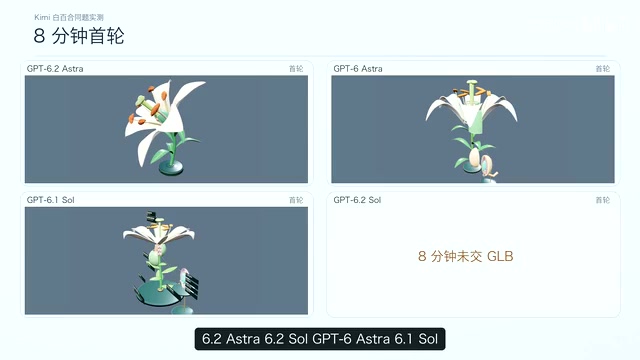
我拿一道更接近教学场景的题目测试四款模型:6.2 Astra、6.2 Sol、6.1 Astra、6.1 Sol。要求做一株百合,六片花瓣、六根雄蕊,能拆开看见内部胚珠,还要演示花粉管往里生长的路径。四组独立绘制,推理档位都开到 high,交付一个打开就能旋转的 GLB 文件,第一轮限时 8 分钟。
结果分化明显。6.2 Sol 在 8 分钟内没写完脚本;6.2 Astra 交出了花头朝向观众、花瓣有弧度、拆开能看到成对胚珠的成品;旧版 Astra 把一枚胚珠单独放大摆在旁边;6.1 Sol 加了标牌和影线。如果老师要指着画面讲某个部位,旧版 Astra 那一份反而最顺手。6.2 Sol 后来补跑,换了导出方法,额外花了 11 分多钟才交完文件。补跑版本低角度花瓣挡视线,稍微俯一点能看到子房一层层打开,三条授粉路径都能跟着珊瑚色那条从花顶看到胚珠入口。
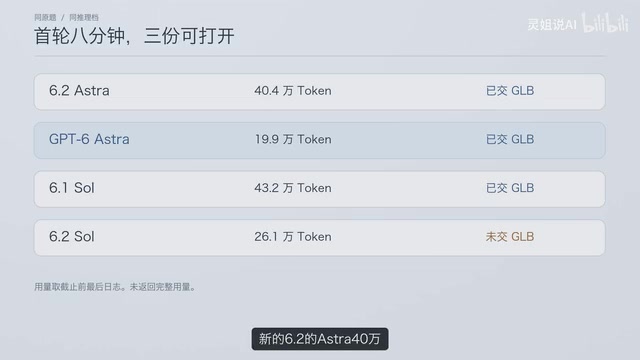
用量数据更能说明问题。旧版 Astra 用量最低,8 分钟限时内交出成品,约 20 万 token;新版 6.2 Astra 约 40 万;6.1 Sol 约 43 万;6.2 Sol 限时内跑了 26 万 token 没交出来,补跑一轮约 205 万 token,其中 188 万是缓存输入,输出约 2.3 万。如果目标只是做一株能拆的教具,旧版 Astra 就够了;如果想让观众看清花粉管最后钻进哪里,6.2 Sol 补跑那一组效果更清楚。
缓存输入(cached input)指提示词中与上一次调用完全相同的部分被服务端缓存后,按较低单价计费的那部分 token。在多轮补跑或长上下文任务中,系统提示、题目描述、已有代码等未变内容会命中缓存,因此账单上会出现“缓存输入”与“普通输入”两栏。缓存能显著压低单位成本,但也意味着总 token 消耗与实际花费不能简单画等号:一次补跑消耗 205 万 token,其中大部分是低价缓存输入,真正推高成本和延迟的是输出 token 与新增输入。
代码与网页回归:能力持平,个别退步
除了成品生成,我也用小工具做了回归测试:剪掉视频中一段、把后面字幕前移、旧命令还要能用。后三款都通过了对应检查。新版 Astra 能力与旧版基本持平;新版 Sol 在仓库问题上漏了信息,看起来还略有退步。旧项目能否稳定使用,每个人还得用自己的回归用例实际判断。
手机网页题也一样:6.1 Sol 的页面被撑宽了,6.2 Sol 在同样宽度下能放得下,细节和适配性优化更好,外部浏览器检查也都过了。另有研究对比让模型做自家数据中心标注,6.2 Astra 比旧版有进步,但园区标注时 6.2 只标了一栋,人工标了六栋,Faber 5.2 在这个任务上更接近外部研究人员水平。
成本与收益:先定够用标准,再决定开多大
新版 Max 档位把湖考题的喉囊羽毛和踩踏姿势做得很细,代价是更多输出 token。同一句题把推理降到 high,新版反而从 18 美分降到 12 美分,踩踏姿势也还挺清楚——只配一张图的话,high 档就可以收工。
Sol 本身没有降单价,但测评显示 6.2 Sol 在某些情况下能追平或接近旧版 Astra 的总分,从这个角度理解,可以算某种程度的降价:以前要找旗舰模型干的活,现在日常款也能做出来。
更值得留意的是定价逻辑的变化。OpenAI 和 Anthropic 正在正面竞争,两家都在给“愿意等多久”标价。OpenAI 在部分后台 API 任务里设定:愿意多等就能少花钱,为排队时间给优惠;Anthropic 反过来,在 Fable 上加钱就能跑得更快。落到使用者身上就是两句话:活有多难决定用哪款,别一味追求最高推理;你有多急决定要不要花钱买速度。以后富裕与否可能要看是否 token 自由——富人花钱买时间,穷人用更少的钱换时间;以后是富人花钱买 token,穷人为了省 token 花更多时间。
推理档位(reasoning effort)是当前推理模型常见的一个可调参数,通常分为 low / medium / high 等几档,控制模型在给出答案前进行内部思考的 token 预算。档位越高,模型用于自我检查、拆解步骤和试错的 token 越多,复杂任务的成功率往往更高,但延迟和成本也同步上升。文章中的“Max”档位可以理解为最高一档,适合一次性难题;而对只需要一张图或一段短代码的任务,降到 high 甚至更低往往性价比更高。
相关推荐
Jingle Jam 2026 报名开启:Lewis 用旧素材喊你组队募捐
Jingle Jam 2026 募捐报名已开放。Lewis 用旧素材剪辑成新视频,号召观众在 jingle jam.tiltify.com 建立募捐页面,支持八家慈善机构,活动于 12 月前两周举行。
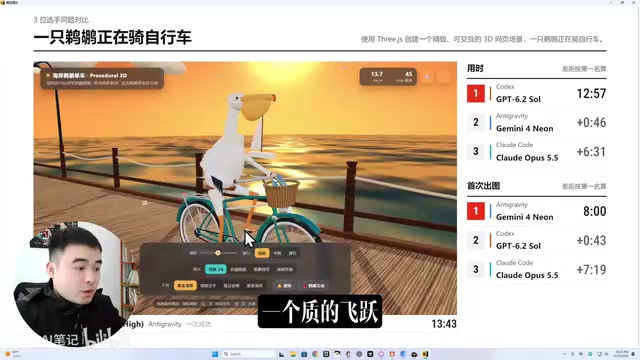
Gemini 4 Neon实测:能否平替Claude Opus 5.5?
B站UP主用三款AI Agent工具同题实测Gemini 4 Neon、Claude Opus 5.5和GPT 6.2,从鹈鹕动画、3D赛车到代码生成视频,看Gemini 4 Neon能否平替Opus 5.5。
FBI警告的Artex:无自研模型的AI攻击框架如何撬开企业大门
FBI警告的开源AI攻击框架Artex没有自研模型,靠接入Claude、GPT等外部大模型驱动代理循环,把Nmap等普通工具变成自动化攻击流水线。本文梳理韩国金融业、ConnectWise、Barracuda三起真实案例,解析速度、成本与噪音三重原因,并给出暴露面清点、短时效凭据等防御要点。