GPT-6.2曝光、Gemini 4现身?AI日报速览

OpenAI、Gemini新模型传闻四起,订阅配额调整与国产开源小模型密集发布。
今日AI圈信息密集:OpenAI内部代号GPP-6.2 Beetlejuice被捕捉但官方未确认,Reddit爆料称Gemini 4基准接近满分并归因于RSI,DeepSeek明确否认V4.1 Pro即将上线。OpenAI公布Rosalind API定价,Anthropic调整Claude订阅并取消Ultra的5小时限制,OpenAI则改为全员增加配额。开源侧商汤发布9B循环Transformer、小米开源0.8B OCR模型、微软发布4B操作智能体。算力与脑机接口方面,谷歌太空TPU成功回传信号,Neuralink展示意念驱动Grok操作电脑。智源发布具身模型GO3 Preview与群体经验学习范式Cell。
今天的AI圈信息密度很高:OpenAI下一代模型代号意外流出、Anthropic调整订阅策略、Google新旗舰传闻直指「接近满分」的基准表现,同时国内厂商在开源模型与产品节奏上也有明确动作。
大模型动态:传闻与官方口径交织
GPT-6.2被捕捉到,官方尚未确认
OpenAI内部模型代号「GPP-6.2 Beetlejuice」被Distort Tracker捕捉到,标注为Internal。这个代号与更早前Bio的传闻形成呼应,被认为是DAG之后的超大域训练模型。需要明确的是,OpenAI并未官方确认,而上一代GPP-6.1 Astra同样还未发布。代号的提前曝光说明内部训练推进中,但并不等同于发布临近。
Gemini 4传闻现身,爆料称基准接近满分
据Reddit爆料,下一代旗舰Gemini 4(传闻代号「Z9」)在几乎所有公开与私有基准测试中接近满分,传闻将这一表现归因于RSI递归自我改进,并称模型对人类文化与上下文的理解更强。Google暂未确认。如果属实,Gemini Carbon之后的换代节奏会明显更快,前沿竞争周期将被进一步压缩。
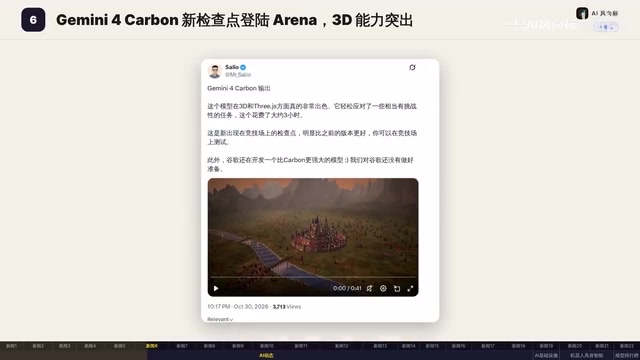
Gemini 4 Carbon的新检查点已上线Arena评分平台,用户可直接试用。反馈显示该模型在3D与Three.js任务上表现出色,能轻松完成高难度题目,有开发者用其生成3D内容耗时约3小时,效果明显优于上一版本。
RSI(Recursive Self-Improvement,递归自我改进)是AI安全与能力讨论中的一个关键概念,指模型能够参与改进自身(或下一代模型)的训练、架构或数据流程,从而形成能力迭代的正反馈循环。理论上,若模型能可靠地发现自身缺陷并提出改进方案,迭代速度可能远超人类研究节奏。但这一概念目前更多停留在实验与思辨层面,业界对其可行性与风险仍有巨大分歧。爆料将Gemini 4的基准表现归因于RSI,属于未经证实的强主张,读者应将其视为传闻叙事的一部分,而非技术事实。
DeepSeek否认V4.1 Pro即将上线
DeepSeek广告产品负责人崔天逸明确否认V4.1 Pro即将上线,称模型仍在训练之中。此前第三方平台Orca Router宣布准备Day Zero支持,引发临近发布的猜测。官方口径落地后,应将该信号视为营销动作而非发布进度,V4.1 Pro的发布窗口仍待定。
值得关注的是DeepSeek开放平台已上线Cyber全线申请入口,此前Cyber应用已出现在官方网站的JS代码中。申请需大陆注册并绑定大陆手机号完成实名认证,近90天无违规记录,流程为填表、审核通过后创建Cyber Key,个人需身份证正反面加人脸核验,企业另需执照与授权书。
OpenAI Rosalind API定价公布
GPT-6-Rosalind的API定价公布:输入每百万Token 15美元、输出75美元;GPT-Rosalind Research与Discovery均为输入5美元、输出25美元。该模型已现身OpenAI API更新日志,目前仅对获批参与Rosalind研究计划的组织开放访问。
订阅与配额:Anthropic改规则,OpenAI加额度
Anthropic更改了Claude订阅计划的名称,并在新的Ultra计划上取消了5小时使用限制。爆料者认为团队正为发布Fable 5.5做准备,希望用户高峰使用时不再受限,并预计将推出500美元档的更高限额Ultra计划。
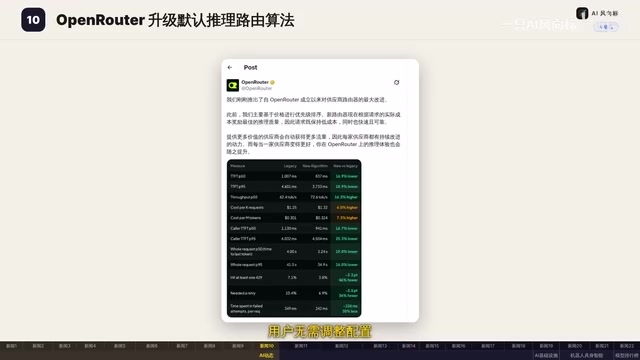
OpenAI的28天冲刺进入Day 25,Tibo宣布放弃砍额度计划,改为全员增加配额:原计划把老Pro 200用户的Codex和ChatGPT Work额度从20倍砍到10倍、月费200美元不变,最终决定20倍老用户保持不变,10倍用户翻倍拉齐至20倍,Pro 100、Pro 500和Business Premium配额也即刻翻倍。
开源与硬件:国产模型集体发力
商汤正式开源SenseNova Loop 9B Preview,这款9B参数循环Transformer以参数共享循环与MHC流行约束超连接扩展计算深度,而非单纯堆模型规模。官方称其在复杂任务上达到27B级性能,并在WorkBody、ReturnPPT和AutomationBench基准上超越某27B级模型。
小米开源0.8B参数OCR模型ZioMeOCR,基于QN3.5-0.8B Base训练,使用约1.7亿条OCR与文档样本。评测显示该模型在Rio5 OmniDockBench取得95.24分排名第一,单一模型即可完成文档解析、关键信息抽取与OCR视觉问答,性能超过更大模型。
微软在Hugging Face上发布40亿参数的混合计算机操作智能体MageVL Cowork 4B,采用单一紧凑策略模型,自主决定何时点击界面、何时编写代码。在Oathworld Verified基准上取得66.0%的成绩,超过27B和30B参数的智能体。
月之暗面旗下Timmy推出3D Make新功能,可连接Blender与CAD等工具完成创建3D模型、组装场景和开发游戏,现已上线,用户可在Timmy Work等入口使用。
另外,40亿参数以下的高性能OCR模型Siri 2.5仅0.7B参数,直接输出保留排版结构的网页格式文本,跨行跨列的复杂表格和数学公式无需二次处理即可准确还原。
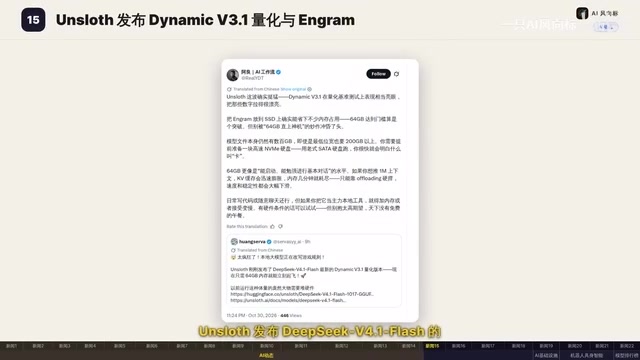
Unsloth发布DeepSeek V4.1 Flash的Dynamic量化与Ngram版本,64G内存即可启动Dynamic V3.1量化,Ngram将权重放到SSD大幅降低内存占用,不过模型文件仍有几百GB,最低比特版本超过200G,需高速NVMe硬盘。
算力与脑机接口:新场景落地
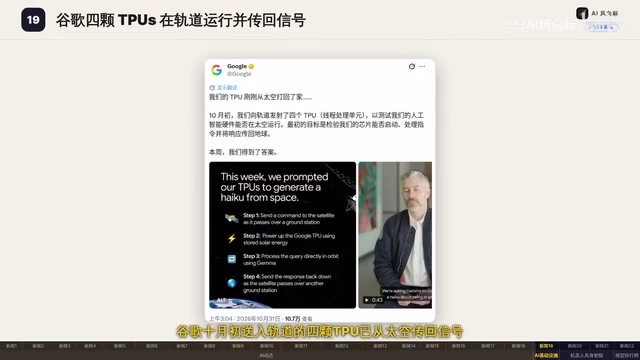
谷歌10月初送入轨道的4颗TPU已从太空传回信号,验证AI芯片能在太空环境开机运行。本次测试目标是芯片开机、处理一个提示词并将回复传回地球,本周团队确认收到回传结果,芯片用Gemma生成了一首诗,这是太空算力长期项目首次见效。
Neuralink展示新功能:用户在脑中默念「Hey Neuralink」并描述任务,Grok智能体即可自主操作电脑,无需手动输入指令。此前工程师已让一名渐冻症患者在家中连续72小时开发测试,同期实现语音意图识别、脑信号输入法及iPhone通话。官方还公布患者每分钟输出75个英文单词、错误率5.8%。
Google Anti-Gravity推出插件式聚合,Google与第三方插件Agent接入外部服务,从手动配置MCP API密钥变为直接搜索、一键安装,桌面App与CLI同步生效。首批合作伙伴包括Atlassian、Figma、Canva、Datadog、CrossTrack、Unity等。
MCP(Model Context Protocol)是一套让AI应用以标准化方式连接外部工具与数据源的开放协议。此前接入一个外部服务通常需要手动配置API密钥、端点与权限,配置成本高且难以复用。插件式聚合把这套流程产品化:用户通过搜索即可一键安装连接器,由平台代为管理凭证与调用,桌面端与命令行同步生效。这一模式降低了Agent接入企业服务(如设计、协作、监控类工具)的门槛,也意味着协议层正在从开发者工具演化为面向普通用户的分发入口。
机器人:从预训练到群体经验
智源10月29日发布具身模型GO3 Preview,实现预训练、后训练到部署的全链路规模化学习,已登顶RoboDojo、RoboTwin、RoboColosseum三大榜单,将于2026年底全面开源。经预训练后其任务迁移与复杂技能适应能力更强,在Zero Shot与Full Shot任务中得到检验,可完成煎饼果子等长程精细任务。
智源联合清华、无问芯穹发布群体经验学习范式Cell,五项真实任务上Cell策略全部超过6名人类远程操作员平均水平,最高领先16.7个百分点;手机包装任务中机器人从16台扩至96台,成功率从86.7%再提升。
排行榜:头部胶着,国产开源追赶
智力榜头部竞争胶着:Gemini 4 Carbon High以59分居首,Claude Opus 5.5 Max with Fallback 58分紧随其后,GPT-6 Aster Max 57分列第三。开源与国产阵营中,Pimmy K3.1 Pro表现最佳,以46分位列第九。
从今日信息看,模型代号传闻、订阅配额调整与开源小模型密集发布三条线索交织,真正的分水岭仍在官方确认与实际可用性上。传闻可以反映竞争节奏,但不应被当作发布进度。
背景补充
循环Transformer(Recurrent Transformer)是一类让模型在推理时对同一组参数进行多次迭代计算的结构,核心思想是以「深度换宽度」:通过参数共享的循环层反复处理隐状态,在不显著增加参数量的情况下扩展有效计算深度。这与传统靠堆叠层数或参数量提升能力的方向不同,理论上更利于控制显存与部署成本,但也带来训练稳定性、梯度传播和推理延迟等挑战。商汤称其9B模型达到27B级性能,正是这一思路的卖点所在;实际效果仍需在更多独立基准与真实任务中验证。
OCR(Optical Character Recognition,光学字符识别)模型负责从图像中定位并识别文字。传统流水线通常拆分检测与识别两个阶段,而近年来的多模态大模型倾向用单一模型端到端完成文档解析、关键信息抽取与视觉问答。小参数OCR模型的价值在于可本地部署、推理成本低,适合批量文档处理场景;难点则在于复杂版式、跨行跨列表格与数学公式的还原。评测中常以排版保真度和结构化输出准确率作为关键指标,单一模型能否兼顾检测、识别与理解,是判断其实用性的核心。
相关推荐

手机本地大模型+ESP32:自制热量提醒器
B站UP主开源了一个热量摄入提醒器项目:手机APP用miniCPM开源模型本地拍照识别食物并估算热量,ESP32小屏幕同步数据,用绿黄红圆环展示摄入状态,可磁吸在冰箱门上随时提醒。

12GB显卡跑125B MoE?Strata三级协同引擎解析
开源C++引擎Strata让12GB-16GB家用显卡本地跑125B MoE模型,生成速度达40-95 Token/s。本文拆解其显存、内存、固态三级协同原理,说明模型选型前提、硬件配置门槛与启动方式。

2B参数模型本地跑音频与视觉:LFM3实测揭秘
海外博主在 MacBook Air 上实测 Liquid AI 的 LFM3 Audio 2B 与 Omni 2B:2B 参数离线跑语音与视觉,工具调用超预期,但噪声转录与幻觉问题明显。