GPT-6.2双模型Astra与Soul怎么选?三维交互实测与定价分析
GPT-6.2让三维场景在浏览器内可玩,并以Astra与Soul双线覆盖复杂项目与日常效率。
OpenAI 发布的 GPT-6.2 将三维场景生成推进到浏览器内可交互操控的程度,官方展示的飞行器赛道与社区用图片参考生成的金属轨道场景均可直接运行。更关键的是产品线拆分为 Astra 与 Soul:Astra 面向硬核项目,专业工作评测较前代提升 6.2 个百分点且输出用量减少 22%;Soul 编程测试与 Astra 差距不到 0.5 分,成本约为其五分之一,两者均支持最高推理档位。早期反馈中三维效果获得好评,但给已有网页添加组件时模型易坚持自身风格,需要反复调整。定价上 Astra 每百万输入 8 美元、输出 40 美元,较前代便宜 20%,两款模型已进入 ChatGPT WorkCodec 与 API。
OpenAI 最新发布的 GPT-6.2 把「三维场景生成」从演示视频拉进了浏览器:未来城市里的飞行器沿着发光赛道穿梭,打开网页就能直接操控。比起单纯的视觉惊艳,这次更新更值得关注的是模型矩阵的拆分——Astra 与 Soul 两条产品线,分别瞄准硬核项目与日常效率。
三维交互:从「能看」到「能玩」
官方展示的赛车飞行器场景是这次最直观的卖点。发光赛道、未来城市背景、飞行器操控逻辑被整合进一个可在浏览器运行的三维交互页面,用户不再是旁观者,而是能上手操作。社区里也有人用图片做参考,生成了带金属轨道的三维场景,同样能在电脑浏览器中跑起来。
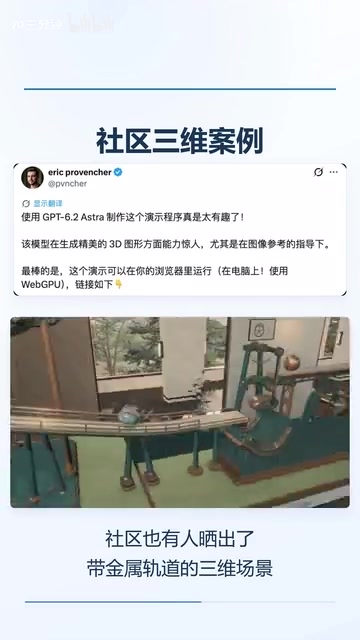
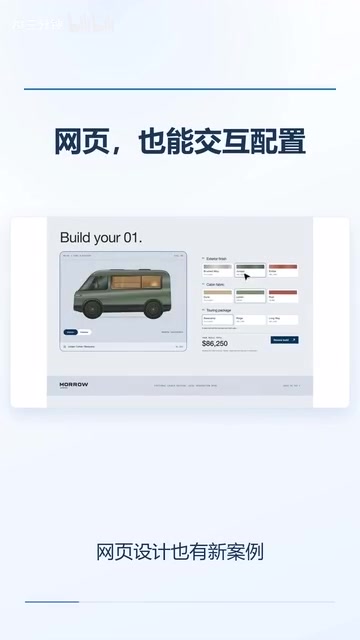
这意味着 GPT-6.2 在空间理解与交互逻辑生成上的能力有了实质性推进。网页设计侧也有新案例,比如一个可以交互配置车辆的露营车网站,用户能直接调整车辆选项并看到反馈。对做前端和交互原型的人来说,这类「一句话出可玩 Demo」的能力正在改变验证想法的速度。
三维场景生成之所以在浏览器中“能玩”比“能看”难得多,核心在于额外的工程约束。模型不仅要生成几何形状与材质,还要输出可被 WebGL/Three.js 一类渲染管线消费的场景结构,包括物体的层级关系、坐标变换、碰撞与边界、以及相机和操控输入的处理逻辑。传统流程中这些工作由美术与前端分头完成,生成式模型则试图一次性给出可运行的整体。
Astra 与 Soul:两条路线的取舍
两款模型的定位差异很清晰:Astra 面向更难的项目,Soul 更注重日常使用的效率。
在官方的专业工作评测中,Astra 比前代提高了 6.2 个百分点,同时输出用量还少了 22%。这个组合值得注意——更强且更省,意味着在复杂任务上不仅结果更好,token 消耗反而下降。
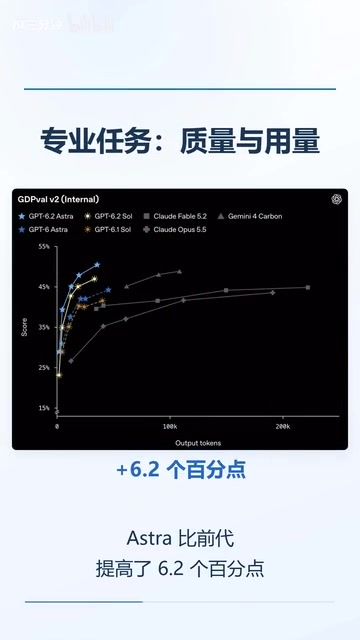
Soul 的定位则更务实。在编程测试里,Soul 与 Astra 的成绩相差不到 0.5 分,而成本约为 Astra 的五分之一。两者都支持开到最高推理档位,也就是说 Soul 并非「阉割版」,而是在多数日常编程任务中把性价比拉满。
推理档位(reasoning effort)指模型在给出答案前允许投入的思考量,档位越高,模型越倾向于展开更多中间推理步骤,通常提升复杂任务的正确率,但会增加延迟和 token 消耗。文章提到两款模型都能开到最高档位,意味着 Soul 的能力上限并未被人为压低,其成本优势主要来自模型规模或推理效率的差异,而非关闭深度思考。
早期用户反馈:强项与摩擦并存
三维效果获得的评价普遍正面,但社区体验并非一边倒。有早期用户指出,当需要给已有网页添加组件时,模型容易坚持自己的风格,导致需要反复调整才能贴合原有设计。
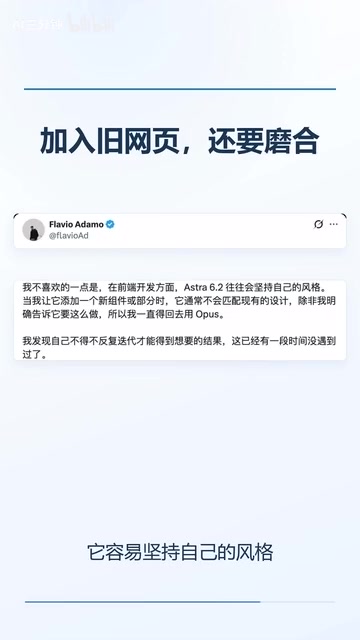
这个反馈指向一个现实问题:从零生成和增量修改是两种不同的能力。前者模型可以自由发挥,后者需要在既有约束下工作,风格一致性就成了考验。如果你的工作流大量涉及在现有项目上迭代,这一点需要在试用时重点验证。
从零生成与增量修改的差异,在工程上对应“无约束生成”和“约束满足”两类问题。前者只需产出合理结果,后者必须在既有代码结构、命名习惯、样式体系等条件下工作,模型需要先理解上下文再改动。风格漂移是这类任务的常见失败模式,实践中通常靠提供组件示例、明确设计规范或分步小改动来缓解。
定价与适用场景
价格方面,Astra 每百万输入 8 美元、输出 40 美元,两项都比前代便宜 20%。两款模型已经进入 ChatGPT WorkCodec 和 API,开发者可以直接接入。
选择逻辑可以简化成两条:要做三维交互类项目,Astra 值得优先试;日常编程任务,先看成本更低的 Soul,在测试成绩差距不到 0.5 分的前提下,五分之一的价格很难被忽略。
真正需要权衡的是任务复杂度与容错空间——当项目对输出质量极其敏感、返工成本高时,Astra 的溢价是合理的;而当任务量大、迭代频繁时,Soul 的单位成本优势会被放大。
按 token 计价的模型选择,本质是单位成本与返工概率的权衡。若一次输出质量不足导致的返工成本(人工审查、重试消耗、时间延误)高于模型单价差,则高价模型更划算;反之任务量大、单次错误代价低时,低成本模型的总成本更低。这也是文章建议日常编程先试 Soul、复杂项目优先 Astra 的经济学依据。
相关推荐
Jingle Jam 2026 报名开启:Lewis 用旧素材喊你组队募捐
Jingle Jam 2026 募捐报名已开放。Lewis 用旧素材剪辑成新视频,号召观众在 jingle jam.tiltify.com 建立募捐页面,支持八家慈善机构,活动于 12 月前两周举行。
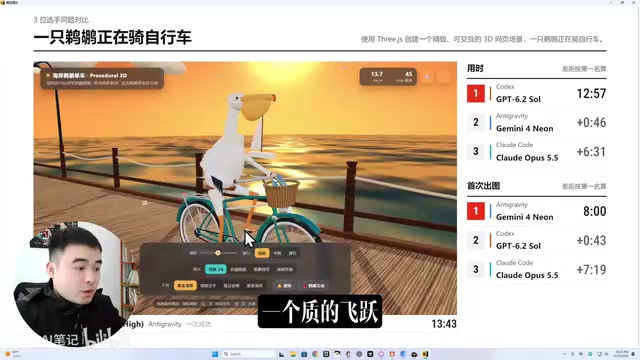
Gemini 4 Neon实测:能否平替Claude Opus 5.5?
B站UP主用三款AI Agent工具同题实测Gemini 4 Neon、Claude Opus 5.5和GPT 6.2,从鹈鹕动画、3D赛车到代码生成视频,看Gemini 4 Neon能否平替Opus 5.5。
FBI警告的Artex:无自研模型的AI攻击框架如何撬开企业大门
FBI警告的开源AI攻击框架Artex没有自研模型,靠接入Claude、GPT等外部大模型驱动代理循环,把Nmap等普通工具变成自动化攻击流水线。本文梳理韩国金融业、ConnectWise、Barracuda三起真实案例,解析速度、成本与噪音三重原因,并给出暴露面清点、短时效凭据等防御要点。