GPT-6.5泄露疑云与MiniMax M3.1 Flash:AI模型混战升级

本周AI圈模型发布密集:OpenAI传闻、Anthropic意图理解突破、MiniMax低价冲击与谷歌Gemini 4 Carbon不及预期。
本周AI领域信息密集,主要玩家均有新动向。OpenAI方面,恶搞网站opensi.lol的GPT-6.5线索被证伪,但微软评估配置中出现GPT-6.1T更值得关注。Anthropic新模型展现出从修复单个Bug到识别整类问题的意图理解能力,代表自主编码智能体的重要跃升。谷歌Gemini 4 Carbon早期检查点实测不及Claude Opus 5.5,甚至弱于现有Gemini Argon,此前“媲美Opus 5.5”的说法不成立。MiniMax M3.1 Flash以每百万输入Token 15美分的定价和超200 Token/秒的速度冲击市场,实测成本比Opus 5.5低近88倍,但输出质量仍有差距,更适合作为脚手架工具。此外,OpenAI传统语言现代化、智谱GLM系列、Kimi K3.1泄露、NVIDIA推理优化及Dream1机器人模型等动态同样值得关注。
本周AI圈:泄露、发布与价格战齐飞
这一周的开局信息量极大。从OpenAI可能存在的GPT-6.5线索,到Anthropic新模型在自主编码上的突破,再到MiniMax用极低价格冲击市场,几乎所有主要玩家都有新动静。据B站UP主World of AI的梳理,以及The Information、路透社等来源的交叉信息,我们正处在一个模型发布密度显著升高的窗口期。
OpenAI:GPT-6.5传闻与微软代码泄露
一个可疑的倒计时网站
有人发现一个名为opensi.lol的网站,其HTML源代码中埋藏着对“6.5”的引用,并附带一个指向旧金山时间11月1日上午10点的倒计时。这个时间点恰好与OpenAI“28天交付承诺”的第28天重合,引发了不少猜测。
但需要泼一盆冷水:域名历史存档显示,该网站早在9月23日就被描述为“待售的独立OpenAI恶搞网站”。所以这大概率不是官方信号,只是巧合得有些刻意。
微软评估配置中的GPT-6.1T
相比之下,另一条线索更值得关注。据报道,微软的拉取请求中出现了18项评估配置,从GPT-5.6T更新为GPT-6.1T。这不是某个恶搞网站上的文字,而是微软评估基础设施中的实际代码变更,暗示OpenAI的下一代模型可能已进入测试准备阶段。
Anthropic新模型:从“修一个Bug”到“修一类问题”
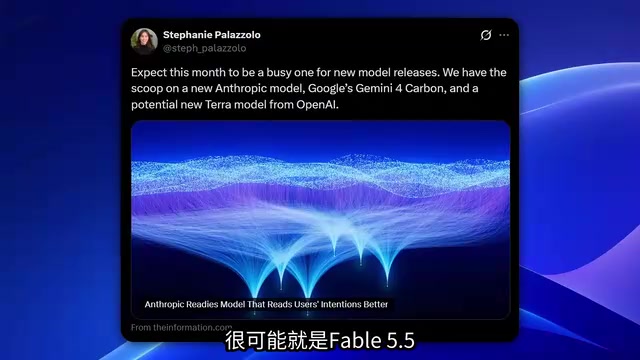
The Information的一篇报道预告了接下来一波模型发布潮,其中Anthropic的新模型细节尤其引人注意。据一位匿名测试者描述,该模型不再只是修复你指定的那个Bug,而是能识别出这是一个更大问题的一部分,并主动询问是否要一并处理整类相关问题。
这对自主编码智能体来说意义重大。当前模型最大的局限之一,就是你必须明确告诉它找什么、修什么。一个能理解更广泛意图、发现你还没注意到的问题的模型,是另一个层级的辅助能力。报道还称该模型更擅长跳出框架思考,而非重复传统方案。
自主编码智能体(Autonomous Coding Agent) 指能在最少人工干预下独立完成编码任务的AI系统,其能力谱系通常分为几个层级:最基础的是根据明确指令修改指定代码;进阶的是能自主定位问题、规划修改方案并执行;更高层级则要求模型理解代码库的整体结构与开发者意图,主动发现潜在问题并提出超出原始指令范围的建议。当前主流模型大多停留在前两个层级,核心瓶颈在于“意图理解”——模型只能处理显式给定的任务边界,无法推断开发者真正想达成的目标。Anthropic新模型所展示的“识别整类问题并主动询问”,正是从“指令执行者”向“协作伙伴”跨越的关键标志,也是自主编码智能体走向实用的分水岭。
谷歌Gemini 4 Carbon:早期检查点令人失望
此前Business Insider报道称,谷歌内部测试的Gemini 4 Carbon在编码能力上能媲美Claude Opus 5.5。但根据实际测试两个不同检查点(Carbon B和Carbon C)的结果,这个说法“绝对是错的”。
在与Opus 5.5的同类编码任务对比中,Carbon检查点完全不在同一水平。更意外的是,和谷歌现有的Gemini Argon模型相比,几乎没看到有意义的提升——Carbon稍快一些,但实际编码质量甚至更差。当然,这些只是早期检查点,后续还有提升空间,但所谓“达到Opus 5.5级别”的说法目前不成立。
MiniMax M3.1 Flash:低价高能的冲击波
性能与定价
MiniMax M3.1 Flash已结束预览正式发布。官方确认,此前在排行榜上匿名出现的“SpaceMoney Alpha”就是它的早期版本。新模型速度超过每秒200个Token,比上一代M3快三倍,成本还便宜约70%。
基准测试方面,AutomationBench上M3.1 Flash得分62.2%,对比Claude Opus 5的50.3%和GPT-5.6的45.8%。价格上,每百万输入Token仅15美分、输出60美分,缓存输入最低可至每百万1.5美分——而Claude Opus 5是输入5美元、输出25美元。
实测对比:成本差距惊人
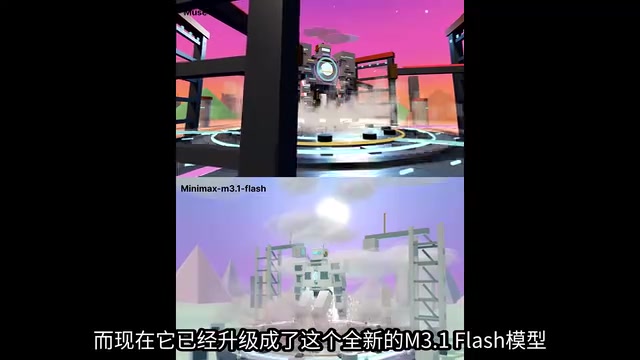
在网页设计测试中,MiniMax仅用1美分完成落地页任务,Opus 5.5则花费1美元22美分,便宜近88倍且速度快4倍。水下潜艇追逐场景测试中,MiniMax约21美分完成,Gemini 3.8 Flash约1.43美元,Claude Haiku 5.5约17美分。
必须说明:成本低不代表输出更好。Opus 5.5的成品质量明显更优。更现实的用法是把MiniMax当作脚手架工具,再用更强模型精修。
Pro版本在路上
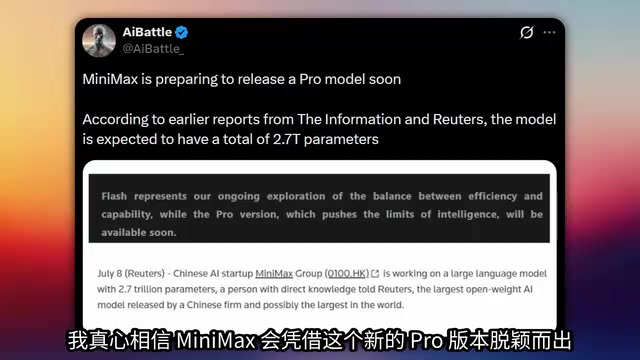
据报道,MiniMax还在准备更强大的M3.1 Pro系列,可能拥有高达2.7万亿参数,有望成为规模最大的AI模型之一。参数不等于性能,但结合Flash版本的表现,Pro值得期待。
Token定价与缓存输入(Cached Input) 是大模型API成本结构的两个核心变量。Token是模型处理文本的基本单位,约等于0.75个英文单词或半个汉字,输入Token指用户发送的提示词,输出Token指模型生成的内容,后者通常定价更高。缓存输入则是一种成本优化机制:当多次请求包含相同的前缀内容(如系统提示词、长文档)时,服务商可缓存这部分计算结果,避免重复计算,从而以极低价格计费。MiniMax M3.1 Flash将缓存输入压至每百万Token 1.5美分,意味着在智能体等需要反复携带相同上下文的场景中,实际成本可进一步大幅下降。理解这一结构,才能明白为何其标价与Opus 5.5的差距会在实测中被放大到近百倍。
其他值得关注的动态
OpenAI传统语言现代化:OpenAI强调其最新模型在理解COBOL、Fortran、Visual Basic等传统语言方面有显著提升,能帮助开发者在不破坏现有功能的前提下迁移旧系统。这是AI编码最被低估的应用之一——大量银行、政府基础设施仍依赖这些语言。
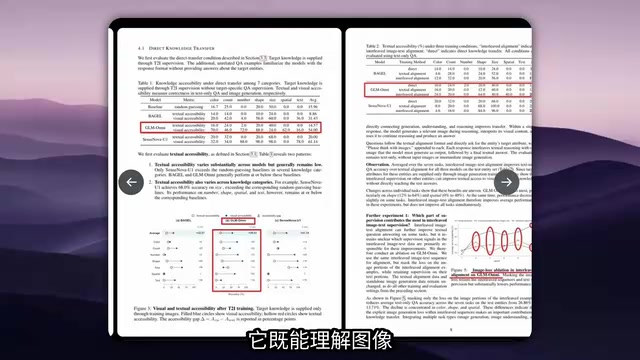
智谱GLM系列:编码平台Zcode推出工作流模式,可同时编排多个AI智能体并实时追踪进度。研究论文披露内部多模态模型GLM Omni,既能理解也能生成图像,图像与文本对齐准确率从12.57%提升到26.86%。GLM 5.3仅通过后训练,在Terminal Bench上从4.6跃升至28.3。
Kimi K3.1:出现在某拉取请求中,7分钟后被关闭。泄露信息显示其使用与Kimi K3相同的Tokenizer和聊天格式,引入低、中、高、Max四个推理级别(Max为默认),支持图像输入。
NVIDIA推理优化:在2.8万亿参数的Kimi K3模型上实现每用户每秒423个Token,同架构下速度提升1.68倍,归功于约12000行高度优化的CUDA内核代码和Mega Kernel Fusion技术,无需额外硬件。
Dream1机器人基础模型:Dreamlabs走出隐身模式,其模型能操作从未训练过的双臂机器人完成陌生任务,访问价格每小时3美元起,API已向开发者开放。
传统语言现代化(Legacy Code Modernization) 是AI编码中商业价值极高但公众关注度较低的方向。COBOL、Fortran、Visual Basic等语言诞生于上世纪,至今仍支撑着全球大量银行核心系统、政府税务平台和航空调度基础设施。这些系统的维护者逐年减少,而迁移成本极高——据估计,仅美国联邦政府的遗留系统现代化每年就耗费数百亿美元。AI模型若能准确理解这些语言的语义与业务逻辑,并在不破坏现有功能的前提下生成现代语言等价代码,将直接切入一个规模庞大且付费意愿强烈的企业市场。OpenAI强调这一能力,本质上是在编码红海之外开辟差异化场景。
小结
这一周的核心信号不是某一个模型,而是竞争维度的分化:OpenAI在传统代码现代化上找场景,Anthropic在自主编码的“意图理解”上做深,MiniMax用价格和速度撕开缺口,谷歌则还在追赶。对开发者来说,工具选择正在变得更多元——用便宜模型搭骨架、用强模型做精修,可能比押注单一模型更务实。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。