GPT-6 Astra 接入 Blender 实测:AI 能取代 3D 艺术家吗?

实测GPT-6 Astra接入Blender:27分钟出一张远看以假乱真、近看破绽明显的别墅渲染图,当前更像高效助理而非替代者。
一位B站UP主对GPT-6 Astra接入Blender的能力进行了实测,结果呈现出AI建模工具的真实现状:模型自我定位为"技术美术助理",擅长程序化场景搭建、材质灯光设置和重复性资产处理,而非完整的创意替代。核心测试是根据豪华别墅参考图重建场景,耗时27分钟,第一眼足以以假乱真,但仔细审视后树木等细节破绽明显。作者还发现,让AI自己生成提示词再配合参考图发送,是提升输出质量的实用技巧。综合来看,AI目前在速度和精度上均未能对熟练3D艺术家形成碾压性威胁,但其压缩重复劳动、快速出草稿的价值不可忽视。
AI 建模浪潮下的"存在主义焦虑"
对不少 3D 艺术家来说,社交媒体上每周涌现的新 AI 建模工具已经成了一种持续的心理压力。一位 B 站 UP 主在最新视频中调侃道:每当刷到"某个专为 Blender 打造的超强 AI 模型",都会陷入一轮"要不要转行"的自我怀疑。这一次的主角是被称为 GPT-6 Astra 的模型,作者决定把它拉进 Blender 做一次真实测试,看看它究竟能不能"抢走饭碗"。
值得关注的一个细节是:使用这类工具时,你甚至不需要在后台开着 Blender。整个测试在 ChatGPT 桌面端完成,模型档位设置为"中等"(作者坦言不想把积分全花光)。这意味着 AI 建模的交互方式正在从"人操作软件"转向"人下达意图、AI 生成结果"。
让 AI 自我评估:它认为自己能做什么?
作者没有直接给出复杂需求,而是先问模型"你觉得自己在 Blender 里能做什么、会抢走谁的饭碗"。这个开放式提问反而暴露了当前 AI 建模能力的真实边界。
模型的回答相当克制且专业:它自称最适合当"技术美术",能快速出草稿,具体包括——用 Python 搭建程序化场景、建模道具、设置材质和灯光、布置摄像机、自动化重复编辑,以及排查几何体或渲染问题。它举了个例子:给它一个方向,比如"一个阴暗的水下研究站",它就能生成具体场景并与用户迭代。
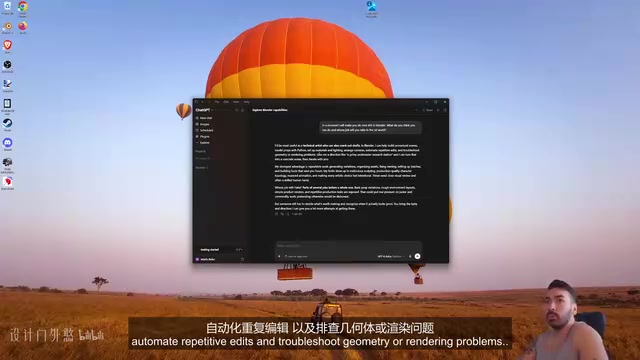
关于"抢饭碗",模型的自我定位值得从业者细读:它承认会替代"重复性工作、生成变体、整理资产、修正命名、批量处理"这些环节,但明确表示"还不到完全取代"的程度。换句话说,AI 目前更像一个高效的助理,而非独立的创作者。
模型提到的"程序化场景"是指通过参数或脚本批量生成3D内容,而非逐个手工建模。Blender内置的几何节点(Geometry Nodes)系统就是典型实现方式:艺术家定义规则,软件自动生成符合规则的大量物体,例如一片随机分布的森林或整齐排布的城市街道。AI通过Python脚本调用Blender API,本质上是在"编写并执行"这类程序化逻辑,因此对于高度重复、规律性强的场景构建效率较高,但对于需要主观审美判断的不规则有机形态(如角色、自然地貌细节),其输出质量则明显受限。
第一次测试:几秒钟的动画与"心理暗示"
作者让 AI"做点酷炫的东西",并特意加了一句"我在做 YouTube 视频,你最好做得漂亮点"。有趣的是,他对比了之前一次没有这句话的测试——这次的产出"好了 100 万倍"。这当然是夸张的调侃,但也点出了提示词措辞对生成结果的影响。
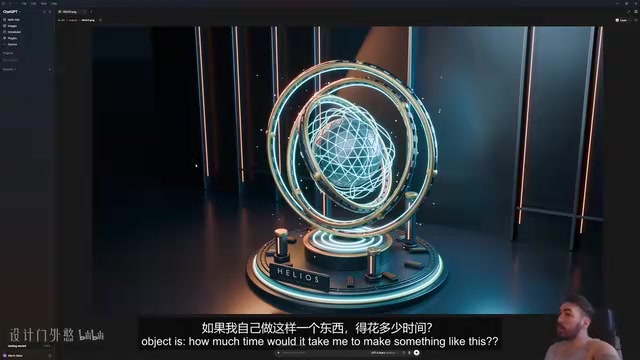
生成过程需要等待两三分钟,最终 AI 渲染出了一个物体,还附带了一段 6 秒的动画。作者的评价很诚实:"看起来挺酷的",但要说惊艳,"其实也没有"。他甚至提出想做一期"3D 艺术家对战 AI"的对比视频,看自己能否用更短时间重建同样的场景——因为 AI 花了六七分钟。
硬核测试:根据参考图重建豪华别墅
真正有价值的测试是建筑可视化。作者从 Google 图片搜索了一张"豪华别墅"参考图(这栋房子他自己曾做过可视化),并且做了一个聪明的动作:先让 AI 自己给出"如何写好这段提示词"的建议,理由是"它应该比我更了解自己"。

这个思路对普通用户很有启发——与其绞尽脑汁写提示词,不如让模型帮你生成结构化提示词,再连同参考图一起发送,要求 3D 场景尽可能贴近参考图。
建筑可视化(Architectural Visualization,简称 ArchViz)是3D艺术中商业价值较高的细分领域,通常用于房地产销售、室内设计提案和建筑方案展示。从业者需要在贴近参考图的前提下,把控光线真实感、材质质感(如混凝土、玻璃、水面反射)以及植被配景等大量细节。这类项目对"还原度"要求极高,客户往往能一眼看出透视关系或材质是否"不对味",因此成为检验AI建模能力的理想压力测试场景——比生成一个抽象酷炫的科幻物体要苛刻得多。
27 分钟的等待与"两秒印象"的陷阱
从按下回车到拿到结果,整整过去了 27 分钟。作者在展示结果前抛出了一个很有洞察力的观点:人对一件事物的第一印象往往取决于最初两三秒看到的东西,而这通常和实际情况完全不同。他建议观众记录"看图前两秒"和"盯着看一两分钟后"两种截然不同的感受。

结果确实"以假乱真"——第一眼作者以为自己打开的是参考图本身。游泳池部分渲染得相当不错,场景里有几处细节乍看也挺好。但深入观察后,问题浮现:比如那棵树,作者形容它像老游戏《寂静岭》里追着人跑的诡异存在。整体上是"远看惊艳、近看破绽"的典型 AI 生成结果。
27 分钟一张图,够格威胁饭碗吗?
作者把最核心的问题留给了观众:一个需要 27 分钟才能生成这种结果的服务,真的先进到能威胁建筑可视化、游戏设计、环境设计、产品可视化这些领域的从业者了吗?
从这次实测能得出几个相对理性的判断:
- 速度尚未构成优势:27 分钟一张仍带明显瑕疵的静态图,对熟练的 3D 艺术家而言并没有碾压性的效率优势。
- 第一印象具有欺骗性:AI 结果最擅长营造"惊艳的头两秒",但经不起专业眼光的细看,树木、结构等细节仍是短板。
- 定位是助理而非替代:连模型自己都承认,它的强项是重复性、变体化、资产整理类工作,而非从零到一的完整创作。
对 3D 从业者来说,与其焦虑"该不该转行",不如把这类工具当作压缩重复劳动、快速出草稿的加速器。真正的创意判断、审美把控和细节打磨,短期内仍牢牢握在人类手里。
提示:本文基于一位 B 站 UP 主的单人实测视频整理,测试环境为 ChatGPT 桌面端中等档位,结果具有一定主观性,仅供参考。
值得注意的是,文章测试的是"中等"档位,且运行环境为ChatGPT桌面端而非本地部署。云端推理的耗时不仅取决于模型能力,还受服务器负载、网络带宽和任务队列等因素影响,27分钟的等待时间并不完全代表模型的"智能上限"。随着算力成本持续下降和推理加速技术(如模型量化、投机解码)的普及,同等质量的生成速度有望在未来一两年内显著压缩。因此,"速度尚未构成优势"这一判断具有较强的时效性,从业者需要持续关注而非一次测试定论。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。