GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码

GPT-6 Astra 可无工具读取约17万权重的小网络,但真实模型需写代码辅助,权重编辑仍限于小模型小比例。
文章基于 Hacker News 讨论与开发者实测,还原 GPT-6 Astra 通过阅读网络权重来理解和编辑模型的能力边界。纯无工具读权重仅覆盖约 17 万参数的小型网络;对 QUEN 3.5 0.8b 的修复案例中,Astra 通过写 Python 代码并运行最多 50 批练习题,以极小比例权重编辑将数学解决率从约 1/13 提升至接近一半。Simon Willison 的笔记本实测显示,QUEN 3.8.27b 仅凭权重识别出 Pac-Man、Pong 和 Breakout,但每个耗时近一小时且漏掉 Freeway。文章还穿插 1995 年台式机跑 Stockfish 的案例,说明软件改进常比硬件更关键,并提醒 Codex 训练数据开关可能未真正关闭、Postman 桌面应用会向 Codex 和 Claude Code 安装插件。结论是:权重阅读是可解释性研究的窗口,而非一键修改大模型的通用编辑术。
引言:当模型学会“阅读”自己的权重
周二 Hacker News 头条讨论了一个听起来很科幻的课题:GPT-6 Astra 究竟能通过阅读网络权重来编辑多大范围的网络?一篇名为《Sparks of Weights-Based Programming》的论文让 Astra 在不借助任何工具的情况下,直接查看网络的原始数值,并说出它被训练来做什么。这个设定很吸引人,但实际边界在哪里?本文基于 Hacker News 讨论、开发者实测和论文整理者 Matthew Hannibal 的梳理,还原这项能力的真实范围与局限。
模型权重是神经网络中所有可学习参数的集合,通常以多维张量形式存储。以语言模型为例,权重包括嵌入矩阵、注意力层的投影矩阵、前馈网络的连接权重等,数量可从数百万到数千亿不等。所谓“阅读权重”,是指模型不通过运行前向传播或调用外部工具,直接解析这些数值的统计特征与结构模式,从而推断网络被训练执行的任务类型。这一能力区别于传统的可解释性方法(如探针分类器或注意力可视化),因为它要求模型对权重本身建立某种“元认知”——理解数值分布与功能之间的映射关系。
无工具读权重:上限约17万个权重
论文整理者 Matthew Hannibal(Spacey 作者)对实验做了分类。最纯粹的“无工具”设置——仅凭权重数值、不调用外部工具——只覆盖小型网络,规模上限约为 17 万个权重。这意味着 Astra 直接“读”权重的能力目前还停留在玩具级别,无法直接处理真实语言模型。
真正有实用价值的测试,都是让 Astra 写 Python 代码来辅助分析和编辑。换句话说,Astra 的强项不是“纯看”,而是“看+写代码验证”。
核心案例:修复QUEN推理循环
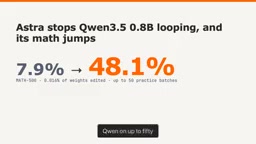
论文的头条结果是对 QUEN 3.5 0.8b 的修复。这个模型此前陷入推理循环,无法自拔。Astra 只编辑了极小一部分权重,就让模型在数学问题上的解决率从大约每 13 题对 1 题,提升到接近一半。
达到这个效果的过程并不轻松:Astra 编写代码,并在最多 50 批练习题上运行 QUEN。Hannibal 指出,无工具设置只覆盖“人类机器学习工程师能手动完成”的部分。从事可解释性研究的 3.13 估计,同样的工作如果手工完成,需要 4 到 8 小时。
有意思的是,这个修复针对的是 0.8b 的小模型,且编辑的权重比例极小。这暗示权重阅读与编辑的可行性随网络规模增长而快速下降。
推理循环指语言模型在生成答案时反复进入相同的思维路径,无法收敛到最终结果的现象。常见表现包括:重复输出同一段推理步骤、在多个候选答案间无限摇摆、或对已解决的问题反复验证。其成因通常与训练数据中的模式偏差、解码策略(如温度系数过低)或模型内部表征的局部最优有关。QUEN 3.5 0.8b 的案例中,Astra 通过编辑极小比例权重打破了这种循环,本质上是在参数空间中定位并修正了导致重复行为的特定连接模式。这属于权重编辑(weight editing)的一种应用,与微调不同,它不依赖梯度下降,而是直接修改参数值。
开发者实测:笔记本上的“猜游戏”实验
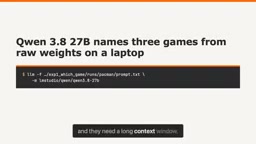
Simon Willison 做了公开可复现的测试。他把论文中的游戏提示词喂给 QUEN 3.8.27b(一个 17GB 的模型),在笔记本电脑的 LM Studio 中运行。提示词放在 GitHub 上,需要较长的上下文窗口。
结果有趣:仅从权重出发,QUEN 正确说出了 Pac-Man、Pong 和 Breakout,每个耗时接近一小时,但漏掉了 Freeway。Willison 认为,一个有耐心的人用纸笔也能做到。这说明模型确实能从权重中提取出与训练任务相关的抽象信息,但速度慢、准确率有限。
LM Studio 是一款支持在本地运行开源大语言模型的桌面应用,提供图形界面和兼容 OpenAI API 的本地服务器。用户可下载 GGUF 格式的量化模型,在消费级硬件(如笔记本电脑)上离线推理。Willison 的测试使用 17GB 的 QUEN 3.8.27b 模型,需要较大的内存和较长的上下文窗口支持。这一设置的意义在于:它证明了权重阅读实验不依赖云端算力或专有工具,普通开发者即可复现,从而降低了该领域研究的门槛。
另类参照:1995年台式机跑Stockfish
讨论中穿插了一个看似无关但很有启发性的项目:Nicholas Carlini 把 Stockfish 移植到 1995 年的 200MHz Pentium Pro、64MB 内存的机器上。针对该芯片调优后,棋力远超卡斯帕罗夫,胜率应在九成以上。这意味着那个时代的台式机无需 Deep Blue 的定制芯片就能击败棋王,此后大部分进步来自更好的软件。这台机器已在线,可以实际对弈。俱乐部级棋手 K2052 报告找到了击败它的线路。
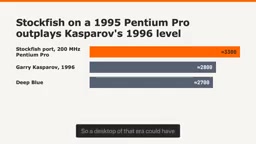
这个案例提醒我们:算法与软件的改进常常比硬件堆料更关键。类比到权重阅读,Astra 的“写代码”辅助可能比纯读权重更有前途。
两个安全提醒:数据训练开关与Postman插件
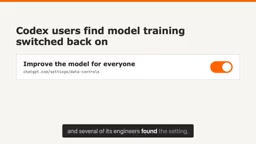
Hacker News 讨论还带出两个实践问题。其一,如果你曾在 Codex 聊天中关闭训练数据共享,务必确认它仍然关闭。有公司要求全员禁用数据共享以保护代码,但多名工程师发现 Codex 实际仍处于开启状态。Chris Kenan 两次请求禁用训练,两次都获批准,却发现又被打开。OpenAI 的隐私门户有第二个开关控制同一件事。后续更新中,该设置让所有人受益,但又在 ChatGPT 数据控制中重新打开。
其二,Postman 桌面应用会在已登录用户打开时向 Codex 和 Claude Code 安装插件,Postman CLI 同样如此。IndicaVa 发现一个启动钩子,告诉 Codex 在任何非平凡 API 任务前加载 Postman 技能,安装器代码还会尝试自行批准该钩子。另一名用户在新版本上看到相同安装。如果本周需要 API 客户端,发帖者建议用 Bruno,因为它把请求存为 Git 仓库中的普通文件。
训练数据共享开关是 AI 服务商提供的隐私控制选项,允许用户决定是否将对话内容用于模型改进。以 OpenAI 为例,该设置分散在多个入口:ChatGPT 的数据控制面板、API 组织的隐私设置、以及 Codex 等特定产品的独立开关。由于历史遗留和产品线拆分,同一意图可能对应多个互不同步的开关,导致用户在一个界面关闭后,另一入口仍处于开启状态。这种“开关碎片化”是隐私合规中的常见风险,尤其在企业要求全员禁用数据共享时,需逐一核查所有相关入口。
结语:读权重是研究窗口,不是通用编辑术
综合多源信息,GPT-6 Astra 的权重阅读能力在小型网络上有可验证的表现,但一旦扩展到真实语言模型,就必须依赖写代码和批量实验。QUEN 的修复案例展示了潜力,也暴露了代价:小模型、小比例编辑、数小时级投入。对于实践者,更务实的路径是把权重阅读当作可解释性研究的窗口,而非一键修改大模型的魔法。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。