GPT-6 Astra实测:论文配图1:1还原并转可编辑PPT
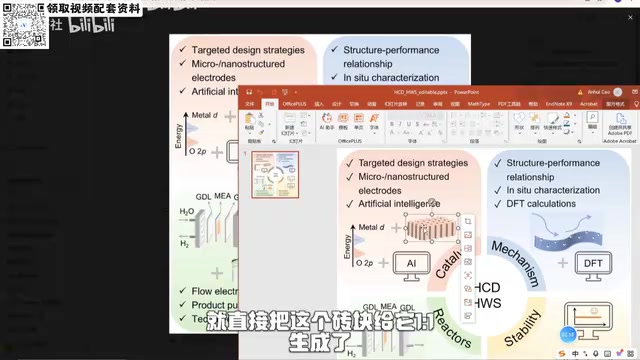
GPT-6 Astra可将复杂论文插图1:1还原为可编辑PPT,多模态能力在数月内实现显著跨越。
本文记录了B站UP主使用GPT-6 Astra将复杂学术插图直接转化为可编辑PPT的实测过程。相比几个月前GPT-5.5产生杂乱结果的表现,GPT-6 Astra通过"复杂视觉保真+主要文字可编辑"的混合还原策略,成功将箭头、图标、正态分布图乃至密集流程框等元素拆解为可逐个编辑的PPT对象,而非整页截图贴图。处理超密集流程图耗时约6分钟,识别出20个流程框及连线。UP主认为此能力对论文配图、组会汇报等学术场景有明显生产力价值,但同时指出功能并非100%成功、token消耗较快,并提醒用户注意版权与学术规范问题。
从杂乱无章到近乎完美的进化
把一张论文插图直接扔进AI,让它输出一份可编辑的PPT,这个想法在几个月前还只是半成品。据B站UP主的实测演示,早期用GPT-5.5尝试同样的任务时,复现结果往往杂乱无章——文字与图形叠在一起,复杂插图基本无法识别。
而这次用GPT-6 Astra重新跑了同一张复杂插图,结果发生了质的变化。UP主提到,之前有观众在评论区提出的"图太复杂识别不了"的问题,如今被完美解决:箭头、符号、类似化学模型的"砖块"结构、小电脑logo,乃至嵌入的正态分布图,都实现了接近1:1的还原,连字体和线条走向都被保留了下来。
从演示来看,这不是简单的截图贴图,而是把视觉元素拆解重建成可以在PPT中逐个编辑的对象。对于经常需要处理学术配图的人来说,这种能力的跨越确实值得关注。
核心方法:混合还原策略
实现这一效果的关键在于提示词的设计。UP主使用的核心指令大致是:请把图片还原成可编辑的PPT格式,采用"复杂视觉保真 + 主要文字可编辑"的混合还原策略,并明确要求"不要将单页铺成一个背景图"。
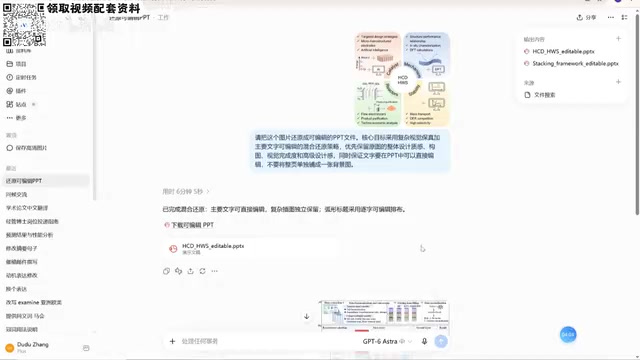
这条提示词的巧妙之处在于区分了两类元素:对于难以矢量化的复杂图形,保留其视觉保真度;对于文字、表格、流程框等结构化内容,则转为真正可编辑的对象。这样既避免了整页变成一张死图,也保证了后续修改的灵活性。
操作路径也不复杂:在对话界面选中GPT-6 Astra模型(区别于5.5、5.6等版本),把token消耗档位调到中或强,再上传图片配合提示词即可。UP主实测中使用的是"中"档,若追求更好效果可以调成"强"。
混合还原策略的本质是对图像内容做语义分层处理。PPT文件格式(PPTX)本身基于XML结构,每个文字框、形状、图片都是独立的XML节点,可以单独修改。当模型将复杂插图"还原"为PPT时,实际上是在生成这些XML节点的代码,而非简单截图嵌入。这意味着模型需要同时完成两件事:识别图像的视觉结构(位置、尺寸、颜色、层级关系),并判断每个元素应被表示为文字框、SmartArt、形状还是保留为嵌入图片。对于无法精确矢量化的复杂图形(如手绘风格插图、显微镜图像),降级为嵌入图片是合理妥协;而对于规则几何形状和文字,则应优先生成真正的矢量/文字对象,以保留可编辑性。提示词中明确要求"不要铺成背景图",正是在指导模型优先选择前者而非后者的降级路径。
极限挑战:超密集流程图
第一张图还原成功后,UP主进一步挑战了一张"超密集型流程图"——由大量小方框堆叠而成,夹杂密集文字和图标,空间极为紧凑。这类图对识别和布局能力是更严苛的考验。
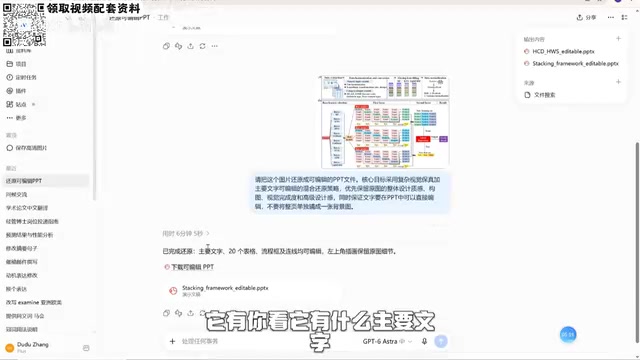
生成耗时约6分5秒,模型在过程中识别出了20个表格流程框及连线。最终结果中,文字、箭头、小点、表格、阴影部分乃至小图标都实现了可编辑还原,在如此紧凑的排版下没有出现明显错乱或堆叠。UP主用"喝一杯奶茶的时间"来形容这段等待——对于如此复杂的工作量,几分钟的处理时长可以接受。
对学术生产力的现实意义
UP主认为,绘图能力过去是许多研究者投稿路上的隐形门槛。配图优美与否会直接影响审稿印象——布局和配色差的论文,甚至可能连送审都过不了。
如果能把顶刊级别的配图色彩、构图一键复用并改成自己的版本,论文配图的档次会明显提升。除了论文,这一能力对组会汇报、学术演示和工作汇报PPT同样适用——不必从零编排,让模型生成图片再转成可编辑PPT即可。
需要提醒的是,这类"拿来改用"的做法涉及版权与学术规范问题,直接套用他人配图存在风险,实际使用时应保持谨慎。
客观看待:进步显著但非万能
UP主也坦言,这项功能并非100%成功,只能说相比上一版GPT-5.5进步了一大截。是否成功与图片复杂度、提示词设置都有关系,遇到失败案例仍需调整。
此外,能力提升的代价是token消耗较快,处理复杂图像时的等待时间也明显偏长。从6月到9月短短几个月,同类任务的效果就发生了明显迭代,这也从侧面反映出多模态模型当前的进化速度。UP主还提到国内外大模型在多模态能力上仍存在差距,这一观点属于个人判断,可作参考。
对普通用户而言,最实际的建议是:用自己的真实素材去验证,而不是只看演示效果。毕竟宣传视频往往展示的是最理想的结果。
Token消耗在多模态任务中值得特别关注。与纯文字对话不同,上传高分辨率图像时,模型会将图像切分为若干图块(tile)分别编码,每个图块消耗数百至数千个token。图像越复杂、分辨率越高,消耗越大。GPT系列对图像token的计费方式与文字token相同,因此处理一张密集流程图的单次调用成本,可能相当于数十次普通文字对话。将"token消耗档位"调至"强"意味着模型被允许在推理过程中使用更多计算步骤(类似于o系列模型的扩展思考),这会显著提升复杂任务的准确率,但同时成倍增加耗时与费用。对于高频使用场景,建议先用"中"档验证可行性,再视结果决定是否升档。
相关推荐
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
一位开发者让Claude构建物理精确、可实时漫步的O'Neill圆柱太空栖息地模拟。本文解析其中的科里奥利力、重力梯度等物理挑战,以及AI生成交互式3D模拟的现实意义与局限。

破解数据锁定:用REGISTER与UNREGISTER API实现目录可移植性
湖仓架构下,开放表格式解决了存储可移植性,但目录锁定成为新难题。本文解析REGISTER与UNREGISTER API如何实现元数据松耦合,帮助企业避免厂商绑定、支持多目录协作并安全迁移数据。
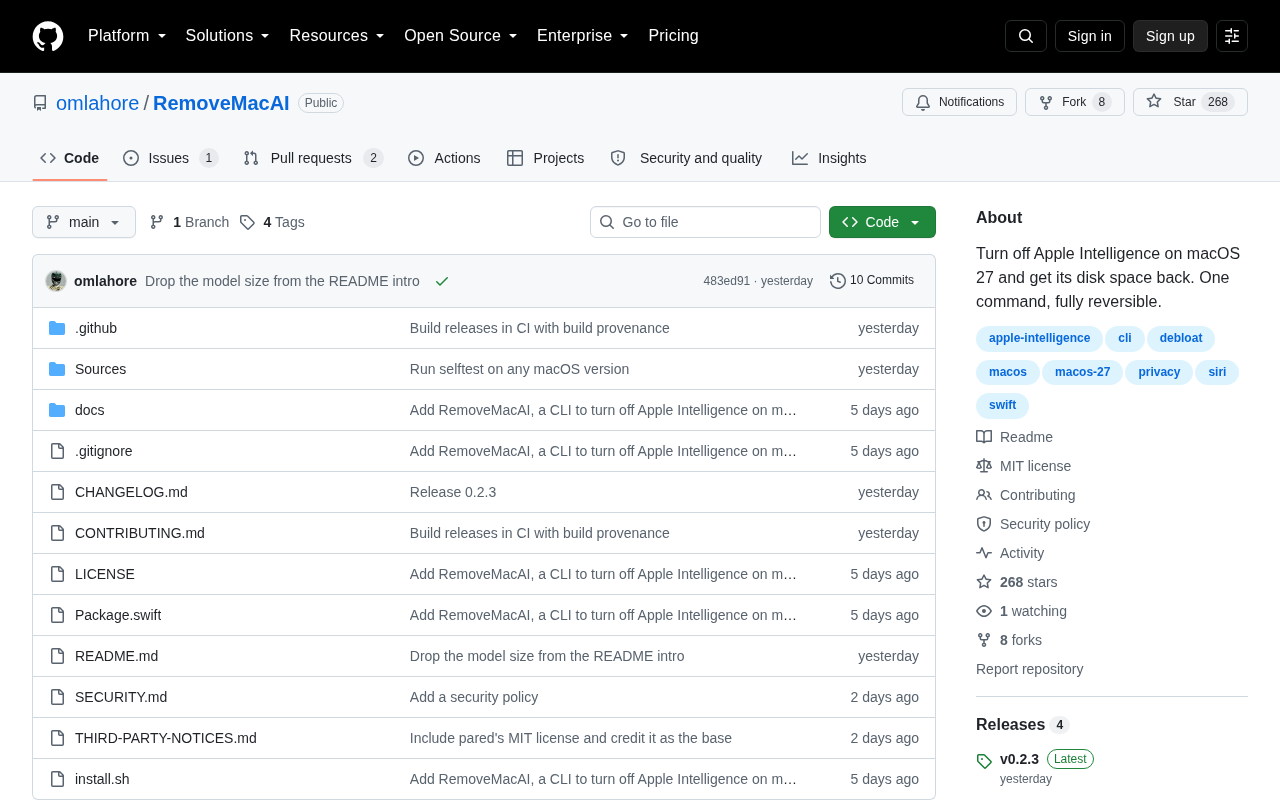
macOS 27 AI模型清理工具:如何移除与禁用Apple本地AI
一款登上Hacker News热榜的开源工具可移除和禁用macOS 27中的Apple本地AI模型,帮助用户释放磁盘空间、节省资源并提升隐私可控性。本文解析其工作原理、风险与背后的用户诉求。