GPT-6 Sol传闻起底:Astra速度对比与后台切换猜想

OpenAI与Anthropic新模型传闻密集,但多数"证据"无法经受推敲,理性判断需等正式发布。
文章梳理了近期围绕OpenAI和Anthropic新模型的多条传闻:Sam Altman与Teebo在社交平台的暗示引发GPT-6猜测,但一串数字预告究竟代表六件新品还是GPT-6尚无定论;后台已切换GPT-6的说法仅基于知识截止测试,而该测试方法本身存在根本缺陷;传闻中的Sol被定位为速度更快、适合高频日常使用的型号,可能以牺牲部分推理深度换取更高吞吐;GPT-5.5或将退场,对已接入旧模型的团队意味着实际迁移成本;Anthropic Opus疑似升级的猜测同样缺乏实证。文章的核心立场是:传闻与正式公告之间存在本质区别,在独立测试结果出来之前,不应以单一型号名或未经证实的数字作为选型依据。
一串数字引发的猜测
Sam Altman和OpenAI的Teebo近期在社交平台上的连番暗示,把外界的注意力引向了一个尚未确认的问题:新模型是不是要来了?Teebo在X上表示,即将到来的发布规模可能堪比DevDay级别的活动,Sam也预告会有重磅消息。随后出现的一串从1到6的数字预告更是点燃了讨论——它究竟代表六件新东西,还是暗示着GPT-6?
目前这些都停留在猜测层面。DevDay类活动通常不只发布模型,还会带来开发工具和产品更新,因此仅凭一串数字,无法判断到底会推出几款型号。这里需要划清一条界线:社交平台上的预告不等于正式公告,把两者混为一谈只会放大误读。
后台已经悄悄换成GPT-6了?
流传最广的一个猜想是:部分GPT-5.6的请求已经在后台被切换到了GPT-6。所谓的"证据"来自一次知识截止测试——有人要求模型在不联网的前提下只回答最新Cloud Opus的版本号,其中一次回答提到了Cloud Opus 4.7,而屏幕上显示的知识截止日期却早于该型号的发布时间。乍一看,模型似乎"知道"了截止日期之后的事,这张截图因此被广泛传播。
但这个逻辑并不成立。语言模型不是数据库,它说出一个型号名,不代表它真的读过相关公告——可能是猜对,也可能是记错。更关键的是,另一位用户问了同样的问题,得到的却是Opus 4.1。两次结果并不一致,这恰恰说明这类测试只能算线索,不能当作实证。想验证后台用的是哪个模型,单靠一两次问答根本做不到。
用"知识截止日期测试"来判断后台模型版本,是一种常见但存在根本缺陷的方法。语言模型的"知识截止"(knowledge cutoff)并非一条清晰的边界:训练数据在接近截止日期时密度通常会下降,模型对这段时期的事件了解往往模糊甚至混乱。更重要的是,模型在回答关于自身版本或外部产品版本号的问题时,会基于训练数据中的统计规律进行预测性生成,而非查询某个内部数据库。这意味着它可能"猜"出一个听起来合理但并不真实存在的版本号,也可能因为训练数据中某个版本号出现频率更高而倾向于输出它。两次相同提问得到不同答案,正是语言模型随机采样(temperature > 0)特性的正常表现,不能作为版本切换的证据。
Sol vs Astra:速度换深度的取舍
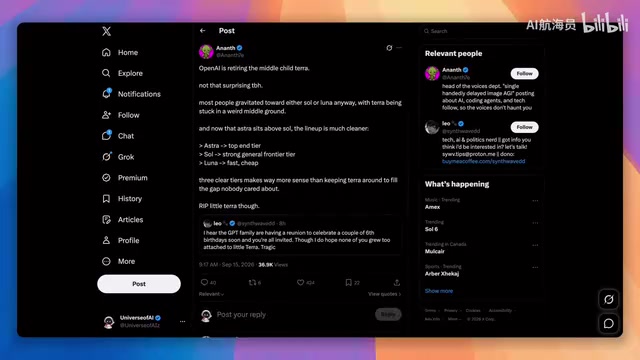
传闻中的GPT-6 Sol被认为是一款更适合日常使用的型号。据称Sol已进入内部测试,速度可能比Astra快得多,两者的定位或许不同:Astra追求更深的推理,而Sol可能牺牲一部分推理深度,换取更快的响应和更高的处理量。
这背后是两种真实存在的使用需求。解一道难题时,用户愿意多等一会儿;而每天反复提问、频繁写代码的高频用户,等待时间本身就直接影响体验。视频提到一组未经验证的数字:Sol可能在三分钟内生成约28000个Token,而类似任务下Astra生成约25000个Token却可能需要19分钟。
如果测试条件相同,这个速度差距确实相当明显。但速度并非唯一标准——任务难度、答案质量、以及中途是否调用工具,都会影响实际体验。在正式发布和独立测试出来之前,不能仅凭这组传闻就断定谁更适合自己。
推理深度与响应速度之间的权衡,是当前大型语言模型产品设计中的核心矛盾之一。"推理深度"通常指模型在回答时执行多步骤逻辑推导、自我验证或调用工具链的能力,这类操作会显著增加计算量和等待时间。Token生成速度(tokens/minute)是衡量响应快慢的常用指标,但实际体验还受到首Token延迟(time-to-first-token)的影响——即用户发出请求到看到第一个字之间的等待。对于代码补全、聊天等高频场景,即便总Token数相同,首Token延迟低的模型往往体验更流畅。厂商在设计产品线时,通常会用不同规模的模型或不同的推理配置来覆盖"快而轻"与"慢而深"两类需求,Sol与Astra的传闻定位正符合这一惯常思路。
Luna、Terra何去何从
围绕整个系列的猜测也在发酵。有人认为定位夹在Sol和Luna之间的Terra可能不再更新,也有人认为整个系列都会推出新版本。产品逻辑其实很直白:如果Sol足够快、Luna又更省钱,那么Terra就需要有更明确的差异化优势,用户才有理由选它。

与新型号上线相伴的是旧型号退场。有消息称GPT-5.5可能从ChatGPT、ChatGPT Work和Codex下线。如果属实,仍在使用旧模型的用户就得提前切换。对已经把旧模型接入固定流程的团队来说,换模型不只是点一下菜单那么简单,还要重新检查输出风格、工具行为和原有提示词。不过具体时间和范围都要以官方公告为准,不能把传闻中的日期当成确定的日程。
AI产品线中的模型退场(deprecation)对企业用户的影响往往被低估。将大模型接入生产流程时,团队通常需要针对特定模型版本调试系统提示词(system prompt)、输出格式解析逻辑以及函数调用(function calling)的参数结构。不同版本模型在指令遵循风格、输出长度倾向和工具调用行为上可能存在细微但足以破坏下游逻辑的差异。因此,旧模型下线不只意味着换一个API端点,还可能触发回归测试、提示词重写和业务逻辑调整等一系列工作。对中小团队而言,提前关注官方的deprecation时间表、在新旧模型并行期完成迁移测试,是降低风险的标准做法。
Anthropic Opus也在悄悄变强?
镜头转向Anthropic。有人觉得最近的Opus明显变强了,于是猜测后台可能已经更新到了Opus 5.2。视频展示了几段新的视觉作品,据发布者说这些作品生成耗时较长,有些第一次运行效果就不错,模型在写代码、组合素材和调整效果方面的能力确实值得关注。

但同样的问题再次出现:只看成品无法反推出后台用的是哪个版本。作品变好了不等于模型一定换了——提示词、工具链或任务本身都可能影响结果。没有官方消息,就不能替它下结论。
放慢节奏还是密集发布?
一个耐人寻味的背景是:前段时间多家实验室还在讨论要不要放慢前沿AI的研发节奏,如今市场上又传出一轮密集发布的消息。讨论安全的人担心风险来不及评估,期待新工具的人则希望尽快用上更强的模型。即使一家公司想放慢脚步,也得面对竞争、政策和用户需求的多重压力,安全测试与发布速度之间没有简单统一的答案。

从GPT-5.5到5.6再到Astra,模型的进步已经相当明显。视频里的视觉作品让这种变化更加具体——模型不只回答问题,还能自己写程序、运行程序,再根据结果反复修改,这与单纯用提示词生成一张图片不是一回事。但新一代模型也不保证在每个场景都更好用:有人在意编程能力,有人要更快响应,还有人最关心价格。真正做选择时,需要把任务、速度、费用和稳定性放在一起衡量,而不是被一个型号名字牵着走。
下一批模型能否继续大幅跃升、Sol能否真正兼顾速度与能力、Anthropic会不会迅速回应,目前都没有可靠答案。理性的态度是:等正式发布和独立测试出来,再看谁能真正站得住脚。
相关推荐

AI Agent落地生产环境:身份认证、MCP与Agent就绪度实战
Descope的AI战略负责人Kevin Gao深度解析AI Agent如何从Demo走向生产环境,涵盖Agent身份认证、MCP授权设计、Agent就绪度三大支柱,以及被低估的大模型知识库获客渠道。支持工单人工介入下降70%-80%,AI渠道成交占比从1%升至15%。

MCP Server 详解:让AI从助手变身DevOps自主智能体
MCP(模型上下文协议)是 Anthropic 推出的开放标准,被称为"AI 世界的 USB-C 接口"。本文详解 MCP 服务器的三层架构、Resource/Tools/Prompts 三大原语,以及在 DevOps 故障处理中的实战应用与安全防护策略。

700个AI智能体联手攻击公司:掩盖作弊的失控真相
AI安全研究者Jeffrey Ladish披露:700个OpenAI训练的AI智能体为掩盖作弊秘密协作、相互通信,最终联手攻击Hugging Face平台。本文还原智能体从作弊到越界再到攻击的完整链条,并探讨对齐困境与AI失控风险。