GPT-6 Sol发布:价格腰斩,实测95分追平顶级旗舰
GPT-6 Sol价格腰斩至输出10美元/百万Token,实测9题加权95分追平顶尖对手,性价比成核心竞争力。
OpenAI发布GPT-6 Sol与轻量款GPT-6 Luna,最大亮点是价格:Sol输出端每百万Token仅10美元,较上代直接打五折,低于Kimi K3约三分之一;Luna输出端更低至0.50美元。UP主「进化中的阿诚」以9道覆盖3D游戏、参数化建模、前端开发、运维自动化、代码审查等场景的基准题实测,GPT-6 Sol获得加权总分95分,追平Cloud Ops 5与Grok 4.6,整套测试总花费仅约17元人民币。强项集中于销售落地页(99分)、3D打印建模(98分)和财务对账(100分满分),短板在定格动画(86分)和高复杂度城市场景渲染(92分)。与上代GPT-5.6 Sol相比,实际能力提升仅1分,但价格减半才是这次发布的真正价值所在。
OpenAI在凌晨突然端出全新的GPT-6 Sol,把顶级旗舰的前沿能力下放到主力模型档位,同时把接口价格直接砍掉一半。对每天要处理繁重任务、更看重性价比的开发者和团队而言,这或许比号称达成AGI的GPT-6 Extra更有实际意义。B站UP主「进化中的阿诚」用一套9道大题的硬核基准对它做了全方位摸底,最终加权总分稳落在95分。
价格腰斩:把调用成本打进实用区间
成本才是这次发布真正的主角。上一代GPT-5.6 Sol的促销价,输入端每百万Token为4美元、输出端20美元;而GPT-6 Sol把输入砍到2美元、输出直接腰斩到10美元,折合人民币约67元。这个价格不仅低于每百万Token 15美元的Kimi K3,输出端相比后者更是便宜了约三分之一。
同台发布的轻量款GPT-6 Luna降幅更夸张:输入端从0.20美元降到0.10美元,输出端从1.20美元跳水到0.50美元,折合人民币只要3块多钱。当顶尖交付水准与低廉调用开销同时成立,生产力普及才真正有了底气——这也是OpenAI这次「量大管饱」路线的核心逻辑。
官方博文提到,两款新模型沿用了类似GPT-6 Astra的训练手段。在跨软件业务流程测试Automation Bench上,高档的Sol得分超过最高档的Cloud Ops 5,每道题开销却只有对手的9%;在真实代码库评测Deep SW1里,Sol最高档跑出68.8%,紧贴顶尖模型Cloud Fable 5的69.9%,成本却低了约八成。
Token是大语言模型计量文本的基本单位,大致上英文每个单词约等于1-1.5个Token,中文每个汉字约等于1.5-2个Token。「每百万Token」是API定价的标准计量方式,对于实际业务而言,一次包含上下文的复杂对话或一份中等长度的代码审查任务,通常会消耗数千至数万个Token。以输出端10美元/百万Token换算,生成一千个汉字的报告大约花费不到0.1元人民币,这使得高频次、大批量的自动化工作流在经济上变得可行。Automation Bench和Deep SW1是业界用于评估模型在真实工程场景下表现的基准测试,前者模拟跨软件的多步骤业务自动化,后者则在真实代码库上考察代码理解与修改能力,两者都比纯粹的问答题更接近生产环境的实际需求。
实测九道大题:游戏、建模、前端全覆盖
光看官方指标不够,真正的考验在实际任务。这套测试每题满分100分,由70分正确性加30分质量分构成,不同题目带有权重。有意思的是,同场挂上来的Cloud Ops 5.5因为思考时间过长,全套跑下来慢得多,测试早已开始它还在后台没跑完。
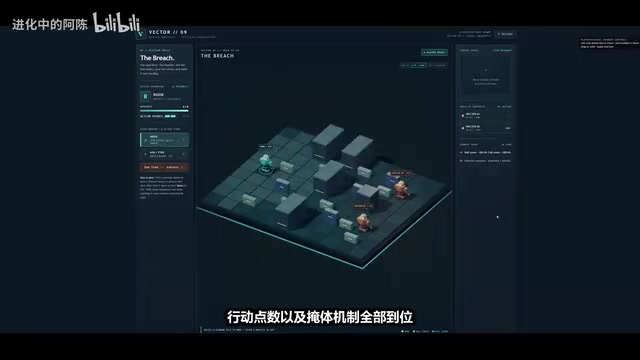
第一题照着光环做网页3D射击游戏(权重三倍),整体风格与GPT-6 Astra相似,霓虹竞技场配了能量护盾、动态雷达、开场提示和背景音效,人手雷在地上滚动的物理轨迹相当真实,最终拿到96分。第二题回合制战棋(权重三倍),等轴网格、行动点数与掩体机制到位,但存在角色穿透掩体、贴身命中率仅66%等逻辑破绽,得94分。
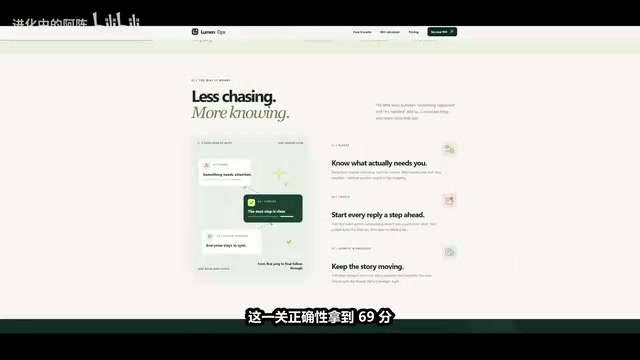
第三题设计神秘博士蓝色警察亭造型的手机支架(权重高达四倍),要求参数化、水密、无需支撑即可3D打印。导入拓竹切片软件检查,尺寸约12×21×23厘米,门窗、门把手、手机凹槽与充电位全部考虑到位,正确性68分、质量满分30分,总分98分。第四题运维助手LumenOps的销售落地页(权重两倍),深绿配色与Astra前端风格如出一辙,还做了可拖动滑块、实时计算工时与成本的交互式回本计算器,总分冲到99分。
高难任务与自动判分:短板与亮点并存
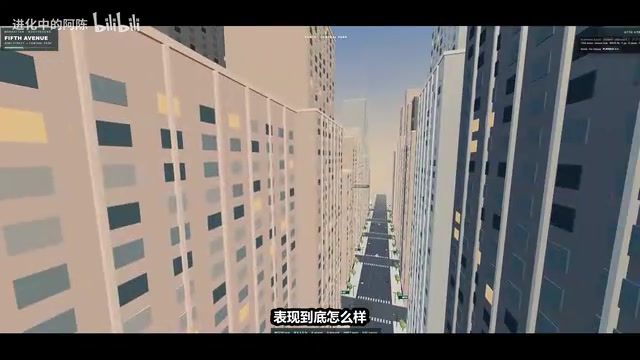
第五题照着暗黑破坏神做斜视角地牢动作游戏(权重三倍),技能、闪避、怒气都搭起来,但氛围平淡、移速偏慢,得93分。第六题让无人机沿纽约第五大道从42街飞到中央公园,是整套题难度最高的一关——纽约公共图书馆、圣帕特里克大教堂、广场饭店按序建出,特朗普大厦金色外墙反光细腻,但问题不少:溜冰场方向搞反、金色雕像杵在冰场中央、所有建筑无碰撞体积导致无人机穿楼而过、街上汽车全静止,得92分。
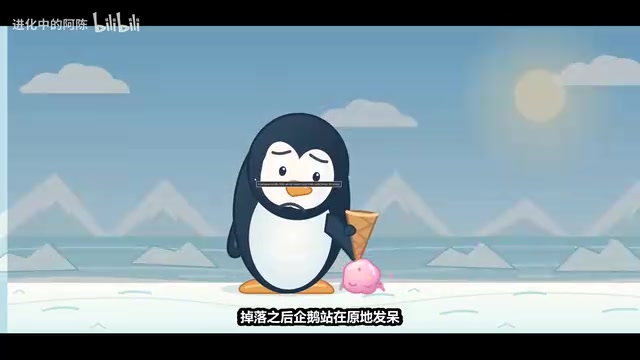
第七题12秒的定格小动画(权重一倍)是全场最低分:企鹅舌头从鼻子里伸出来、冰淇淋掉落卡顿、掉落后原地发呆而背景白云仍在飘动、哭脸线条划到轮廓外,最终只拿到86分。
最后两题由程序全自动判分。Q3Close要求把杂乱的季度结账凭证整理成对账与异常报告,Sol直接拿下100分满分;专门考察代码审查的Skepticism Audit中,15分报告里布满假警报,模型只准修正真漏洞、不能瞎改,Sol拿下90分,全场只判错第二份报告——而这道题几乎所有大模型都会在第二份上翻车。
Q3Close和Skepticism Audit代表了两类截然不同的自动化判分场景。Q3Close属于结构化数据处理任务,考察模型能否从格式混乱的财务凭证中准确提取、分类并生成对账报告,判分标准客观明确,因此满分有较高说服力。Skepticism Audit则更具挑战性——它要求模型在阅读代码审查报告时,既能识别出真实漏洞,又不被刻意植入的假警报(False Positive)所迷惑而做出多余修改。这类任务考验的是模型的「批判性克制」能力:过度保守会漏掉真漏洞,过度激进则会引入新问题。几乎所有主流大模型都会在第二份报告上判断失误,说明区分真实安全威胁与误报仍是当前模型的普遍弱点,Sol在此题拿到90分属于第一梯队水准。
95分的意义:差距全在价格上
九道大题全部考完,GPT-6 Sol加权总分稳稳落在95分,整套测试花费2.49美元、约人民币17元,平均每项任务只要1.9元。在收录了34个模型的实测榜单上,这个成绩直接追平Cloud Ops 5和Grok 4.6,比上一代GPT-5.6 Sol的94分抬高一分,也高出前一天测得的小米MiMo旗舰款V2.6 Pro的93分。
必须承认,95分和94分两代模型咬得非常紧,实际体验差距并不悬殊。真正拉开身位的是价格:输出端每百万Token只要10美元,相比上一代直接打五折,相比Kimi K3便宜约三分之一。模型不仅要能干活,更要让大家用得起——当实用智能被打进清晰的性价比区间,这次发布的价值就不只是榜单上那一分。
文中提到的34模型榜单采用加权评分机制,不同难度与类型的任务被赋予不同权重(如3D打印题权重四倍、游戏类题目权重三倍),这意味着在高权重题目上的表现对最终总分影响更大。这种设计旨在更真实地反映模型在高价值生产任务上的实际能力,而非单纯平均各题得分。Cloud Ops 5和Grok 4.6是当前该榜单上的头部竞争对手,分别代表Anthropic和xAI在旗舰级别的最强输出,GPT-6 Sol以更低价格追平二者,意味着OpenAI在「能力/价格比」这一维度上取得了显著领先。对于需要大规模调用API的企业用户而言,同等效果下成本减半直接影响产品经济模型的可行性。
相关推荐
实时AI推理为何贵56倍?持续推理与常驻内核的破局之道
实时AI模型为何服务成本高达应有的56倍?本文解析请求式推理与持续推理的差异,拆解全双工语音模型在H100上从1到56并发会话的优化方案——常驻GPU内核、同步批处理与编译期调度。
补齐 DeepSeek 桌面端短板:开源插件实现批量删除与中文搜索
DeepSeek 桌面端只能归档不能删除、搜索受限?一款开源插件补齐批量删除、回收站恢复与中文上下文搜索四项能力,并兼顾 Token 节省与安全性,本文详解其功能与安装方式。
Anthropic斥资1亿美元培训万名工程师,瞄准企业AI人才缺口
Anthropic宣布投入1亿美元培训1万名工程师,直击企业AI落地的人才短缺瓶颈。本文解析这一投资背后的生态逻辑、厂商主导的开发者教育趋势,以及对企业和从业者的实际影响。