GPT-6 Sol屎山代码实测:能撼动Astra吗?
GPT-6 Sol实测34道屎山代码题,得分40.48%,稳定性不足但API单价仅为Astra的20%,性价比突出。
本文通过一套贴近真实开发环境的「屎山代码」基准测试,对GPT-6 Sol(索尔)进行了实战评估。测试共34道功能题,涵盖隐性Bug修复,规则严苛:只给一轮提示、不能修坏原有功能。索尔最终通过14项,得分40.48%,并在三道压轴难题中过了两道,排查逻辑清晰、高难度题表现亮眼。然而功能退化问题——修好目标的同时影响原有功能——是其明显短板,也是与头部模型Astra差距的核心所在。索尔的最大竞争力在于定价,其API单价仅为Astra的20%,使其在对稳定性要求相对宽松、注重成本控制的日常开发场景中具备相当吸引力。
一场针对"屎山代码"的极限考验
最近新上线的GPT-6 Sol(索尔)成为社区热议对象,一个绕不开的问题是:它能不能撼动Astra(阿斯特拉)当前的头部位置?为了给出答案,这次测试没有走常规评测路线,而是直接把AI丢进真实项目的"屎山代码"里,看它在混乱环境下的修复能力。
从AA综合能力榜来看,在Max(麦克斯)档位下,索尔相比上一代Terra(泰拉)实现了小幅领先,但与Astra之间仍有明显差距。这个基础定位很重要——它决定了后续实测结果该如何解读:索尔不是来碾压对手的,而是来验证性价比与实战能力的。
34道功能题,只给一次提示
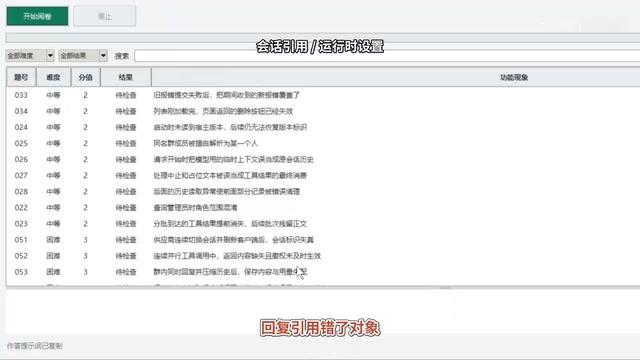
本次测试采用群友提供的屎山基准,共34道功能题,覆盖了各种典型的"隐性Bug":工具明明执行失败,界面却显示成功;切换绘画时回复引用错了对象;运行中修改设置后,后续行为却没有跟着变化。这些问题贴近真实开发中最令人头疼的场景。
题目按难度分为简单、中等、困难和压轴四档,并设有一条硬性规则:不能把原本正常的功能修坏,否则要倒扣5分。这条规则直击AI修复代码的核心痛点——很多模型能修好目标问题,却会引入新的破坏。
测试条件相当严苛:只给一个提示词,只修一轮,中途不追加任何提示,要求必须一次说清楚。这意味着模型的"一击命中"能力被放到了放大镜下。执行环节使用Codex模型,配合索尔的思考档位调到极高。
「屎山代码」(Legacy Spaghetti Code)是开发社区的俚语,指长期迭代、缺乏规范、耦合严重的历史代码库。这类代码的典型特征是:逻辑分散在多个文件、变量命名混乱、副作用难以追踪,修复一处往往牵一发而动全身。用屎山代码作为AI评测基准,比LeetCode式算法题或干净的单元测试更接近真实工程环境——它要求模型不仅能理解局部逻辑,还要具备全局上下文感知能力,在不破坏已有行为的前提下精准介入。这也是为何「不能修坏原有功能」这条扣分规则如此关键:它直接衡量的是模型在复杂依赖关系下的手术级修复能力,而非单纯的代码生成能力。
排查思路清晰,最终得分40.48%
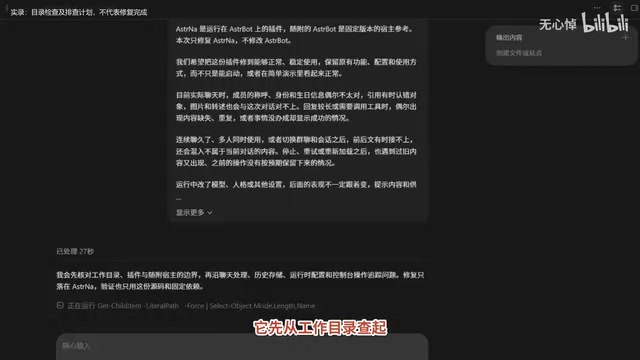
索尔的排查过程展现出不错的工程思维。它从工作目录查起,给出的排查方向包括聊天处理、历史存储和运行时配置等多个层面,逻辑链条比较完整。
最终结果是:34项验证中通过了14项,扣分前的原始得分为40.48%。其中一个亮点值得单独提出——三道压轴难题里,索尔成功通过了两道,说明它在处理高复杂度问题时确实具备一定实力,而不是只会解决简单任务。
与Astra的差距:稳定性是短板
把索尔放回这套屎山测试的排行榜上对比,不少模型的成绩只有十几分到二十几分,而索尔以已收录的一条记录排在第四位。需要特别说明的是,排行榜上那条记录与本次实测并非同一次成绩,这里只作参考。
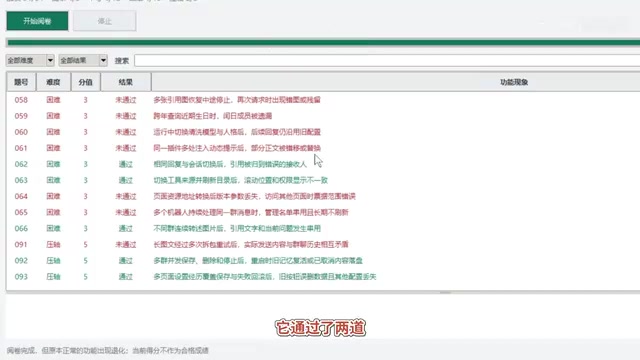
即便如此,说这一轮就能撼动Astra仍然谈不上。更关键的是,这次验收暴露了一个不能忽视的问题——功能退化。索尔在修好一部分问题的同时,也影响了原本正常的功能,触发了倒扣分规则。对于面向生产环境的开发场景来说,这种"边修边坏"的不稳定性是硬伤。
价格是最大的杀手锏
索尔真正的竞争力体现在定价上。按短上下文的标准API定价,它的输入和输出单价都只有Astra的20%。
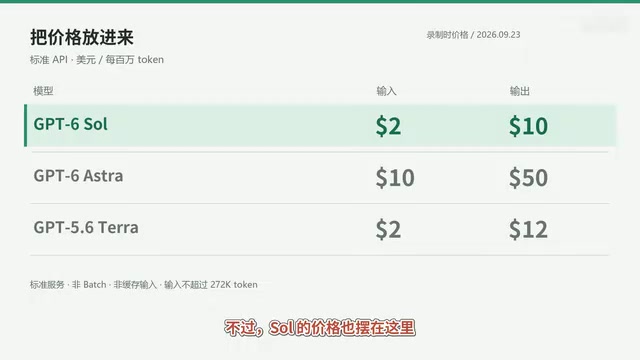
和上一代Terra相比,输入价格持平,输出还更便宜一些。当然这里说的是Token单价,实际花费还要结合具体用量来算。但在这个价位区间内,能在一轮修复中跑出这样的结果,对日常开发而言确实具备相当的吸引力。
换句话说,索尔的价值主张不是"最强",而是"够用且便宜"。当你只需要花五分之一的成本就能获得可观的修复能力时,性价比本身就是一种竞争力。
AI模型API的定价通常以Token为计量单位,输入Token对应发送给模型的文本(包括代码、提示词、上下文),输出Token对应模型生成的回复。在代码修复场景中,Token消耗量往往较大——完整的代码库上下文加上详细的修复说明,单次调用轻松达到数万Token。因此,即便单价差距看起来是数字游戏,落到实际项目中的累计费用差异会相当显著。索尔输入/输出单价均为Astra的20%,意味着在相同预算下,团队可以进行五倍数量的修复迭代,或者在同等工作量下将AI调用成本压缩到原来的五分之一,这对需要频繁调用API的自动化开发流水线尤为重要。
结论与后续悬念
目前可以下的判断是:索尔修得动屎山,但修复后的稳定性还需要打磨。它的排查思路清晰、压轴题表现亮眼、价格极具优势,这些都是加分项;而功能退化问题则是它冲击头部的最大障碍。
一个留给下一轮实测的悬念是:如果把没通过的题目和回归问题反馈回去,再给两轮机会,索尔能否修得更完整,甚至全部修好?这将决定它在实际开发流程中的真正上限。至少现在,它已经证明了自己是一个值得关注的高性价比选项。
相关推荐

谷歌AMIE临床研究登上《柳叶刀》:AI问诊首次真实诊所验证
谷歌与BIDMC合作的AMIE对话式诊断AI研究登上《柳叶刀》主刊,首次在真实诊所前瞻性验证。鉴别诊断与医生吻合率达90%,75%病例帮助医生准备问诊,开创患者端AI问诊临床落地新路径。

自然语言 vs SQL:AI 驱动数据可视化的变革
探讨 AI 驱动的数据分析如何用自然语言替代传统 SQL 进行数据可视化,分析两种方式的优势、局限与融合趋势,以及对企业数据团队角色的影响。

NVIDIA Megatron Core实现位级确定性预训练解析
NVIDIA Megatron Core引入位级确定性预训练能力,让大规模模型训练在调试、验证与恢复中实现逐位可复现。本文解析位级确定性的原理、技术挑战及其对AI工程实践的意义。