GPT-6对战Claude:能力与价格双线开火
GPT-6推Sol/Luna降价抢市,Claude用Opus 5.5以数据反击,但两家对比口径不同,胜负远未定论。
GPT-6发布Sol和Luna两款新模型,API输入输出单价相比上代促销价减半,主打性价比;Claude则推出Opus 5.5,官方称运营成本比上代降四成,并直接在发布页拿GPT-6旗舰Astra对标,声称代码任务得分略高而成本仅约五分之一。然而两家的对比口径并不统一——GPT-6对标的是旧版Opus 5,Claude对标的是GPT-6旗舰而非其日常版,降价百分比的算法也截然不同。文章指出,对普通用户而言,真正应该关注的是完成一份可用成果的总成本和总时间,而非单次调用标价。这场竞争格局尚未定型,用户应按实际需求挑选工具,而非替厂商站队。
两大AI巨头再度短兵相接。GPT-6一口气推出了Sol和Luna两款新模型,Claude这边也拿出了Opus 5.5正面应战。这一次双方不再只比拼能力上限,而是把"每天用谁干活"这个最实际的问题摆到了台面上——能力和价格一起拼。
GPT-6这一边:顶配继续冲,日常版更便宜
GPT-6的产品线出现了明显的分层。原有的Astra继续承担最难的任务,稳坐旗舰位置;而新推出的Sol和Luna,则把这一代的技术下放到更快、更便宜的模型里。
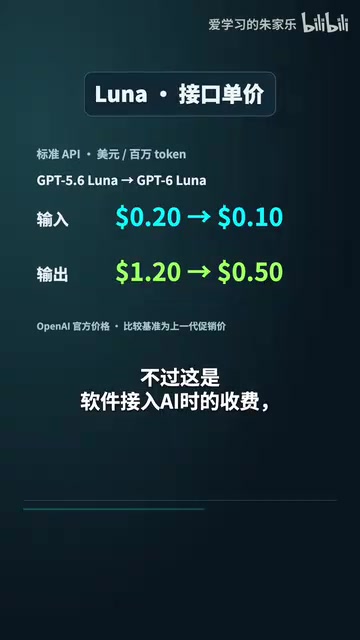
可以这样理解:顶配继续往上冲刺极限,日常使用的版本则要更有性价比。最直接的一招体现在定价上——Sol的开发接口(API)价格相比上一代促销价,输入和输出单价都砍了一半。Luna也在持续降价。需要留意的是,这里说的是通过接口调用AI时的收费,而不是普通用户的会员订阅费。
对开发者来说,接口单价直接打对折意味着调用成本大幅下降,这是GPT-6抢占日常应用场景的核心筹码。
API(应用程序接口)定价是AI厂商向开发者收费的主要方式,通常按"每处理一百万个Token"计价,Token可以粗略理解为文字的计量单位,一个汉字约等于1-2个Token。这与普通用户购买的月度会员订阅是两套完全独立的体系:订阅费是固定月费,API费用则随调用量浮动。对于把AI能力嵌入自己产品的开发者或企业来说,API单价直接决定了产品的运营成本——调用越频繁,单价的影响越大。因此API降价对普通消费者的直接感知有限,但会通过压低开发者成本,间接推动更多AI功能以更低门槛出现在各类应用中。
Claude这一边:用数据强调"难活也不贵"
Claude的策略是把价格和数据一起摆上桌。按照官方的典型任务测试,Opus 5.5相比上一代Opus 5,运营成本降低约四成,而能力还在往上走。
更有火药味的是,Opus 5.5的发布页直接拿GPT-6的Astra来对比。在一项检查"AI修改代码能不能被项目接受"的测试里,官方给出的结果是:Opus 5.5用默认档得分略高于Astra的最高公开成绩,而单次任务成本大约只有五分之一。
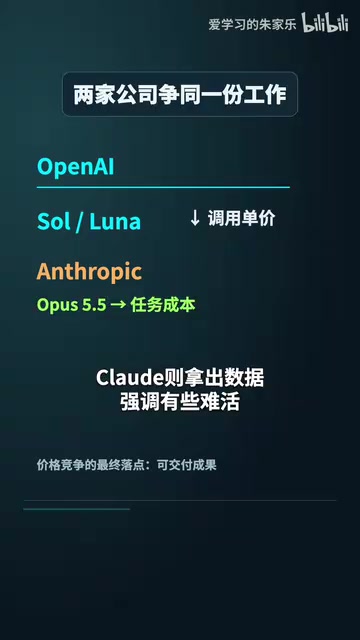
这一招的意图很清楚:GPT-6把更便宜的Sol和Luna推上来抢日常市场,Claude则用数据强调——有些难活,你根本不用花到Astra那个价钱。
别急着宣布胜负:两张排行榜不能直接拼
看热闹的同时也需要保持冷静。两家的对比口径其实并不一致,不能简单地把排行榜拼在一起就宣布谁把谁打趴下。
关键的几点差异值得厘清:
- GPT-6发布稿里的多项对比,用的还是旧款Opus 5,而不是最新的Opus 5.5;
- Claude这边主要对标的是Astra,也就是GPT-6的旗舰,而非Sol或Luna;
- 因此不能把这些结果直接拼成"Sol对Opus 5.5"的胜负结论。
价格上的百分比同样存在口径问题。GPT-6说的"降价一半"指的是接口单价,Claude说的"降低四成"指的是官方测试里的任务成本——两种算法完全不同,不能只比谁的百分比数字大。这类跨口径的对比,恰恰是营销发布会最容易制造误导的地方。
AI模型的评测基准(Benchmark)是衡量模型能力的标准化测试集,覆盖编程、数学推理、语言理解等维度。各家厂商发布新模型时往往选择对自己最有利的基准进行对比,且测试时的参数设置(如温度、采样策略)也会影响结果。"任务成本"与"接口单价"的差异尤其值得注意:接口单价是厂商公布的固定报价,而任务成本是完成某项具体任务实际消耗的Token数量乘以单价的综合结果——一个更聪明的模型可能用更少的对话轮次完成任务,即便单价更高,总花费反而更低。这正是单纯比较"降价幅度百分比"容易产生误导的根本原因。
对普通人到底意味着什么
抛开跑分之争,这场竞争真正影响的是日常使用体验。
设想你开一家小公司,拿到客户一堆资料,希望AI先整理需求、再做报价表,最后产出一份能提交的方案。第一版客户不满意要改,加了新要求还要再改。你真正关心的是:它有没有漏掉条件?数字对不对?改完之后前后还能不能对得上?
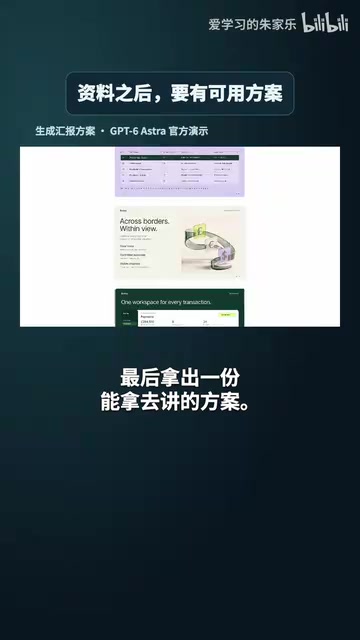
一个模型便宜,却要反复返工,最后未必省钱;另一个模型贵一点,但一次就能做对,反而可能更划算。真正该比的,是拿到一份能用的成果,总共花了多少钱、多少时间,而不是单次调用的标价。
这也是这场双雄争霸最狠的地方:谁能让你更放心、更经常地把工作交过去,谁才有机会成为你的日常工具。今天用它整理资料,明天用它改方案,后天用它做个小工具——用得越顺手,下次有事你就越容易先打开它。
结局远未到下定论的时候
这场竞争会不会最终二分天下,现在还远没到结论的阶段。对普通用户而言,也没必要替哪家公司"守阵地"。
他们争第一,我们挑好用的。谁能把活干好,又让我少花钱,我就把钱给谁。如果只能留下一个付费AI,你会更看重能力上限,还是更看重每天都用得起?这或许才是每个用户真正要回答的问题。
希望两家继续竞争,但别只在发布会上喊"自己最强",也得让用户在实际工作里看到——更少的返工、更合理的账单。
相关推荐

气态巨行星上的浮空城市:为什么人类终将移居木星云端
SFIA 主持人 Isaac Arthur 重新定义气态巨行星浮空城市:它们不是等待聚变的燃料站,而是散装氢、氦、氮的"质量城市"。本文解析其工程原理、供电方案与从工业前哨到文明家园的演化逻辑。

用Claude Code一天半做出AI测验:Vibe Coding的真实样本
一位开发者用Claude Code结合Opus 5.5与Fable 5.1,在一天半内做出一款PS1复古风格的AI主题测验游戏。本文解析这个业余项目背后的AI辅助编程实践与行业启示。

用Claude+Muse打造自动化膳食规划:AI如何替代HelloFresh
一位不懂编程的Reddit用户用Claude和Muse搭建了自动化膳食规划系统,涵盖菜单规划、沃尔玛自动下单、厨房平板界面,号称HelloFresh杀手。本文解析其工作流与AI生活自动化的启示。