GPT-6深度测评:6大实战案例,离AGI还有多远?

UP主自费200亿Token实测GPT-6:工具调用与空间推理惊艳,Computer Use翻车,离AGI仍有距离。
B站UP主「AI小王子」自费约200亿Token,从视频制作、游戏开发、三维建模、前端设计、自动剪辑到电脑操作六个维度对GPT-6进行了完整实测。官方给出的ARC-AGI-3满分级成绩(99.9%)令人瞩目,但缺乏第三方验证。实测中最显著的进步是模型从"生成内容"转向"主动调用工具"——自动调用Blender建模、主动上GitHub补充素材、预判用户下一步需求。三维建模能力尤为惊艳,仅凭单张参考图在14分钟内还原出可交互的三维场景。反差最大的是Computer Use,官方宣传最猛,但每次按键耗时约21秒,连续性操作任务明显力不从心。价格涨至上代2.5倍,背后是"循环深度"新架构而非单纯堆参数。测评者的最终判断颇为克制:GPT-6很强,但离AGI仍有距离,真正的使用心法转变在于"讲清目标、留空间给模型自主发挥"。
OpenAI 的 GPT-6 正式发布上线,被官方称为「全球最智能、最对齐」的模型。B站UP主「AI小王子」用三个晚上、自费约 200 亿 Token,从视频制作、游戏开发、三维建模、前端设计、自动剪辑到电脑操作六个维度做了一轮完整测试。相比堆砌参数的纸面提升,这次真正让人关注的,是模型开始展现出「举一反三」和「主动干活」的迹象。本文梳理这份测评的关键发现,也客观评估它离想象中的「贾维斯」到底还有多远。
纸面数据:接近满分,但要打个折扣
先看官方给出的跑分。在 ARC-AGI-3 测试中,上一代 GPT-5.6 的成绩为 7.8%,而 GPT-6 直接冲到 99.9%;在高难度数学测试 Frontier Math 上,GPT-5.6 为 83%,Claude Code 5.1 为 87.8%,GPT-6 则达到 97.6%,接近满分。
这些提升幅度确实惊人,但需要冷静看待——数据均由 OpenAI 自行统计,缺乏第三方验证,作为参考即可。测评者也特别提醒,此前用过 Codex 的用户在使用前最好先排查已有的 Skill 或 Agent 是否存在规则冲突,否则会限制新模型的发挥。这个细节其实点出了一个趋势:随着模型能力增强,过去为「弱模型」写的繁琐规则,反而可能成为束缚。
ARC-AGI(Abstraction and Reasoning Corpus for Artificial General Intelligence)是由人工智能研究员 François Chollet 设计的基准测试,专门用来衡量模型的泛化推理能力,而非记忆能力。每道题都是模型从未见过的视觉图案规律,要求从极少量示例中归纳出变换规则并应用到新样本。正因为很难通过"背题库"取巧,它长期被视为衡量 AI 接近通用智能程度的重要参照。ARC-AGI-3 是 2025 年推出的最新难度版本,加入了更复杂的多步推理场景。GPT-6 从 7.8% 跳升至 99.9% 的幅度之所以令人震惊,是因为此前业界普遍认为 ARC-AGI 对现有深度学习范式构成根本性挑战——这一数字若经第三方复现,将具有里程碑意义;若无法复现,则说明评测方式本身存在需要审视的问题。
视频与游戏:AI 开始「调用工具」而非单纯生成
GPT-6 最明显的变化,是从「生成内容」转向「操作软件」。在 AI 视频制作这一传统难题上,场景不一致、人物走位偏移一直是反复「抽卡」的痛点。GPT-6 的做法是直接调用 Blender 生成场景推演和白膜视频,用白膜精确控制镜头和走位。
测评中一个实用经验值得记录:生成白膜视频时要求模型只保留头和身体、不带四肢,因为白膜的四肢会严重限制成片的动作表现——带四肢的失败案例效果颇为「猎奇」。
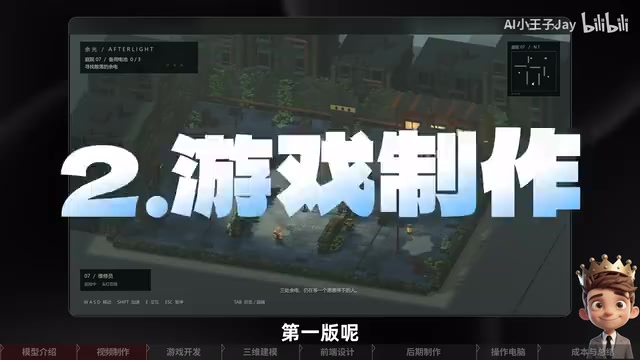
游戏制作方面测试了两版:一版用 Blender 建模配合 Godot 引擎,光影处理被评价为「像专业打光师」,暗街道、暖光窗户、地面水面明暗层次都相当到位;另一版用 Three.js 做出可在浏览器直接运行的三维街景。不过测评者坦言,当前建模更适合几何体组合的规则物件或 low-poly 风格,人物五官、发型、服装等精细细节仍做不到位。代价也不小:游戏和建模这类任务较耗 Token,每个案例约消耗 5X Pro 周额度的 30%。
三维建模:单张参考图还原空间,能力惊艳
最让测评者惊艳的是三维视觉理解与空间渲染。测试特意设置了刁钻难点:只提供一张单一角度的参考图,不给三视图、不给平面图,让模型自己推测背面、侧面和被遮挡的部分。
仅凭一张环形建筑图和一句「还原成可查看的三维场景,可在网页中查看」,模型在约 14 分钟内搭出了环形建筑、玻璃外墙、周围湖面和雪山,且交付结果支持旋转、缩放,甚至能移开屋顶查看内部结构。提示词中并未要求这些交互,模型却主动完成了——这种「预判用户下一步需求」的能力,是本次测评反复强调的亮点。
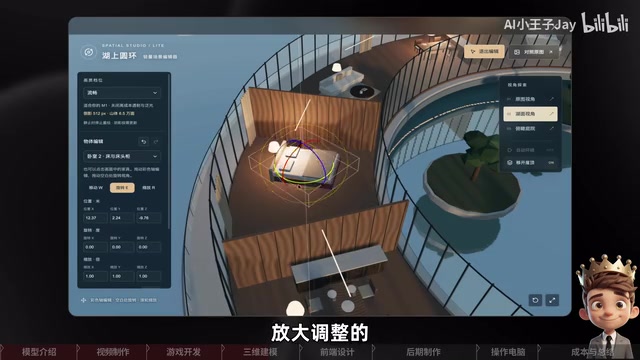
当然,测评者也保持了清醒:初版建模在细节、材质和质感上与专业还原仍有差距,隐藏结构是模型推测的,要做到尺寸和布局精确,仍需补充多角度参考和尺寸信息。「故意刁难」下能有此表现算不错,但不应作为专业工作流的最终交付标准。
前端与剪辑:审美提升,主动上网找素材
前端 UI 一直是 GPT-5.6 被诟病的短板。这次测试的超跑展示网站在暗色背景、金属车身质感、悬浮卡片光泽上都有明显的未来感提升,审美和质感确实进步不少。
更有意思的是一个医学项目——人体解剖三维交互展示。测评者原本只想看模型对解剖的理解,没想到它主动去 GitHub 找相关建模放进项目,做出了可拖动、可旋转、可逐层拆解并显示部件名称的交互效果。这种「自己补齐信息」的行为,被形容为「变得精明了很多」。
自动剪辑测试同样体现了这一点:仅给一段 38 秒口播音频加一句「自己找素材、生成 YouTube 风格口播视频」,约 16 分钟、消耗 5X Pro 周额度的 1%,模型用 Remotion 完成了节奏流畅、素材基本对得上讲解的成片。不过细节仍不精确,比如讲到「AI 漫剧」时配了数位板绘画素材,语义没对上。配合 AE 制作动效则能直接交付工程文件,方便熟悉 AE 的人接手继续调整,但部分功能较强的第三方特效插件未能成功调用。
Computer Use:官方吹得最猛,翻车也最明显
OpenAI 这次重点宣传 Computer Use,直接把 GPT-6 称为「全球最强的电脑操作模型」。前面的建模、AE 操作,底层逻辑都依赖它。但测评者针对官方的大口气设计了一个刁钻任务:打开在线钢琴弹一首曲子。
结果直接卡住——每次按键操作耗时约 21 秒,别说弹曲子,音符根本连不起来。
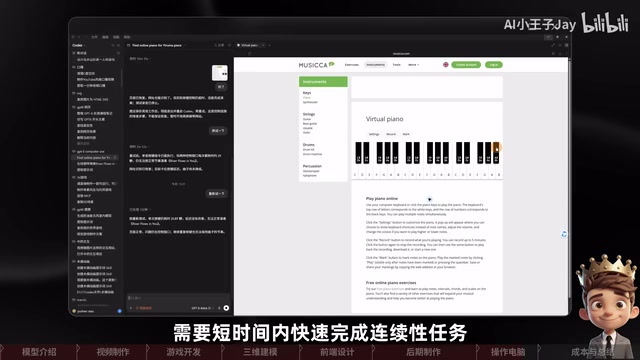
结论很务实:Computer Use 能完成任务,但节奏慢。对于「不追求速度、可以放着让它慢慢做」的长时任务(比如打一首五线谱谱子、下棋)很实用;但对需要短时间内快速连续操作的场景,仍力不从心。「强归强,提升空间还是很大很大」。
Computer Use 是指 AI 模型通过截图感知屏幕状态、再发出鼠标点击和键盘输入指令来操作真实计算机界面的能力,本质上是将视觉理解与动作执行串联成一个闭环 Agent。Anthropic 的 Claude 在 2024 年率先发布同名功能并引发广泛关注,OpenAI 随后将类似能力整合进 GPT 系列。这种方式的瓶颈在于"感知-决策-执行"的延迟叠加:每一步都需要截图上传、模型推理、指令下发,单次操作耗时数秒到数十秒不等。这也解释了为何弹钢琴这类需要毫秒级连续按键的任务会彻底失败——当前 Computer Use 的设计假设是处理"慢节奏、多步骤"的办公类任务,而非实时交互场景。
定价与「循环深度」:贵了,但不是暴力堆参数
价格确实上涨。按 API 标准价,GPT-5.6 每百万输入 Token 为 4 美元、输出 20 美元;GPT-6 Extra 则是 10 美元和 50 美元,单价约为 2.5 倍。Plus 会员基本不够用,需求高的用户往往要开 5 倍会员才够。
但涨价背后并非单纯膨胀参数。测评者提到 GPT-6 引入了一个新机制——「循环深度」:不再是参数量决定「脑容量」,而是把数据放进循环核心反复迭代、在潜在状态下多次深化思考。在复杂任务上,这反而带来了翻倍的效果和更快的输出速度,也意味着能减少不必要的 Token 消耗。
「循环深度」(Recurrent Depth)是一种有别于传统 Transformer 扩展路径的架构思路。传统做法是堆叠更多层、更大的参数矩阵来提升模型容量,代价是推理时的计算量线性增长。循环深度的核心思想是:让同一组参数在推理过程中对中间表示(latent state)进行多次迭代计算,类似于人类"反复推敲"的过程,而非一次性前向传播就得出结果。这种机制让模型在处理复杂问题时可以动态分配更多计算资源,而在简单问题上快速收敛,从而在效率和能力之间取得更好的平衡。这与 DeepMind 的 Adaptive Computation Time 等研究思路一脉相承,也是近年来"测试时计算(test-time compute)"这一研究方向的具体落地形式之一。
离 AGI 还有多远?
测评者最后给出的判断很克制:GPT-6 Extra 强是强,但离 AGI 仍有距离,上升空间很大。真正的启发不在跑分,而在使用心法的转变——过去为了让模型做好事情,人们习惯写极长、极细的提示词规定每一步;但换上更聪明的模型后,这些旧规则反而成了束缚。
更合理的做法是:讲清目标、验收标准和「哪些地方不能动」,具体方法留出空间让模型自己选择。尤其在自己不擅长的领域,说得太多可能起反效果,不如让模型用海量训练数据自主发挥。
从早年用代码画一棵圣诞树就能引来惊叹,到如今宣称可以接管整台电脑,AI 的发展节奏快到让人逐渐习惯。GPT-6 或许还不是贾维斯,但那只脚,似乎确实已经迈进了门槛。
相关推荐

Devin年收入逼近10亿美元:AI编程热潮背后的真实账本
Cognition旗下Devin AI编程智能体年化收入逼近10亿美元,四个月翻倍,估值达480亿美元。本文解析AI编程热潮背后的真实收入、53倍估值倍数、8亿美元现金消耗与企业客户版图。
n8n实战:从零搭建你的第一个AI Agent工作流
基于n8n in 100 days系列第14集实操,详解如何用n8n搭建第一个AI Agent:从When chat message received触发节点、AI Agent与Chat Model,到Memory记忆模块的作用与设计逻辑。

Aleph Alpha开放Kolibri 78B在线免费试用
Aleph Alpha旗下780亿参数大模型Kolibri 78B现已开放免费在线试用,用户无需部署即可通过网页体验这款欧洲本土AI模型的对话能力。