GPT-6实用指南:如何让AI高效完成任务又省钱

OpenAI GPT-6实用指南:通过模型选择、任务定义、缓存与异步四个环节让AI真正交付结果
本文基于OpenAI发布的GPT-6系列实用指南,以"修复一个失效按钮"为贯穿案例,拆解了让AI Agent高效完成工程任务的五个关键环节。核心思路是:按任务复杂度在Luna、GPT-6.iso、Astra三款模型中选择合适成员,并调节推理强度;将任务的现象、工作范围和验收方式表达清楚,同时为模型划定自主操作与需人工确认的决策边界;通过提示词缓存将固定内容前置以降低API重复处理成本;借助异步工具在测试等待期间推进独立子任务。评估流程是否有效的三项指标为成功率、耗时和单次成本。指南最终落脚于一个朴素方法论:交任务前先写清"要什么结果、可做哪些操作、哪些证据算完成",再去优化模型与工具配置。
从一个失效按钮说起
OpenAI 近期发布了一份关于 GPT-6 系列的实用指南,核心问题只有一个:当你用上 GPT-6,怎样才能让它把活真正干完,同时少花时间和成本。B站UP主阿黎用一个具体场景做了拆解——让 AI 修好一个点击后没有反应的网页按钮。这个看似简单的任务,恰好能串联起模型选择、任务定义、成本控制等一整套工作方法。
与其泛泛而谈大模型能力,不如看看在真实工程任务里,哪些操作能让 AI 从"听起来很强"变成"真的交付结果"。下面按照指南的五个关键环节逐一解读。
第一步:为任务匹配合适的模型
GPT-6 系列并非单一模型,而是按定位划分的多个成员。Luna 适合目标明确、需要反复执行的工作,比如从发票中提取字段、给请求分类这类结构化任务;GPT-6.iso 面向复杂编程、研究和计算机操作;Astra 则承担难度最高的推理任务。
选择模型前,先想清楚任务到底需要什么:是单纯整理信息,还是要调查原因、修改代码、再验证结果。修一个按钮显然不是简单的信息整理,它涉及复现、定位、修复、验证的完整链条。
模型之外还有一个值得调节的参数——推理强度。可以把它理解成允许模型在本次任务里投入多少"思考资源"。改一句文案通常不需要深入分析,而一个偶尔失效、牵涉多个模块的按钮,就可能需要调高推理强度。调整之后要看结果有没有改善,再判断多花的时间和成本是否值得。这是一个需要实测验证的权衡,而非越高越好。
推理强度(Reasoning Effort)是大语言模型中一个相对新颖的控制维度,本质上是让开发者或用户决定模型在生成回答之前投入多少"内部思考步骤"。以 OpenAI 的 o 系列模型为代表,这类模型在正式输出前会进行链式推理(Chain-of-Thought),推理强度越高,模型探索的中间步骤越多,回答质量通常更高,但延迟和 token 消耗也会成比例上升。在 API 层面,这一参数通常以 reasoning_effort 字段暴露,可设置为 low、medium、high 等档位。对于高度结构化、答案确定性强的任务,低强度已经足够;而涉及多步骤调试、因果推断或跨模块影响分析的任务,则更容易从高强度中获益。值得注意的是,推理过程本身消耗的 token 通常不计入输出 token,但仍会产生计算成本,因此需要结合实际任务质量要求与预算做取舍。
第二步:把"做完"定义清楚
"帮我修一下按钮"这样的指令留下了太多空白:哪个页面?怎样复现?改完代码就算结束,还是要打开网页检查?
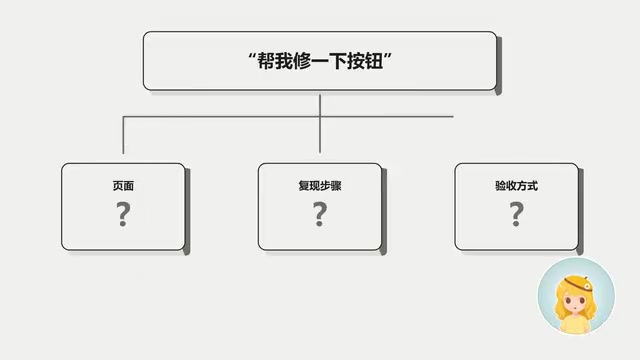
更好的交代方式是:"结算页的提交按钮点击后没有反应,请先复现问题、找出原因、修复代码,再用原来的操作步骤验证,最后告诉我改了什么、验证结果以及还有哪些地方没检查。"这段话同时给出了现象、工作范围和验收方式,模型由此知道任务要走到验证这一步。
不过指南也提到一个现实变化:现在大部分 Agent Harness 默认已内置验收流程,很多时候你只需要把问题描述清楚即可,不必事事手写验收标准。
补上决策边界
接下来要给模型划定行动边界。例如:查看文件、修改本地代码、运行相关测试可以自行完成;而发布上线、修改生产数据则需要人工确认。这样模型遇到常规步骤能持续推进,碰到关键决策才停下来等你。
这些长期有效的规则可以放进项目说明反复使用,重复出现的工作方法则可整理成"技能"。
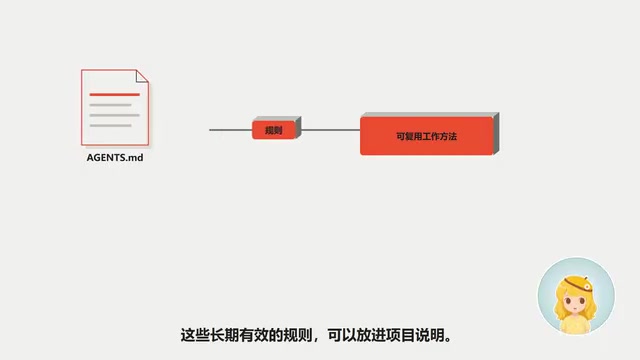
但技能越多、说明越长,占用的上下文也越多。官方建议把适用场景写准确,细节按需加载:改数据库结构时才读迁移规范,准备部署时才读部署文档,没必要让模型先通读整个项目资料。规则的作用是帮助模型找到相关信息、为当前任务做出判断,而不是堆砌。
第三步:用提示词缓存减少重复计算
如果你通过 API 搭建应用,每次请求可能都要带上相同的项目规范、参考资料和工具定义。这些内容反复出现,就有机会用到提示词缓存。
缓存复用的是模型已经处理过的、相同的提示词前缀。因此可以把固定内容放在前面,把"这次修哪个按钮"这类变化内容放在后面,后续请求命中缓存就能省掉一部分重复处理。
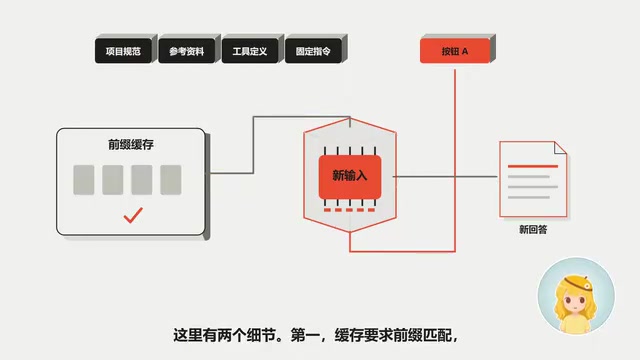
这里有两个关键细节:第一,缓存要求前缀匹配,前面的内容一旦变化就会影响后面内容的复用;第二,缓存节省的只是相应输入的处理成本,模型仍然要处理新内容、生成新回答。整个任务能省多少,需要看实际用量而定,不能一概而论。
提示词缓存(Prompt Caching)是 OpenAI 等大模型服务商提供的一种推理加速与降本机制。其原理是:当 API 请求中的提示词前缀与此前某次请求完全一致时,服务端可以复用已计算完毕的 KV Cache(键值缓存),跳过对这部分 token 的重复编码,从而缩短首 token 响应时间并降低计费成本——OpenAI 对命中缓存的输入 token 通常按折扣价计费。这一机制对以下场景尤为有价值:系统提示(System Prompt)较长且固定、每次请求都附带大量参考文档、工具定义(Function Calling Schema)保持不变。需要注意的是,缓存命中依赖严格的前缀匹配,哪怕只修改了系统提示中的一个字符,后续所有内容的缓存都会失效。因此,良好的提示词结构设计——将最稳定的内容置于最前、将每次变化的用户指令置于末尾——是充分利用缓存的关键工程实践。
第四步:让等待期间也能推进工作
假设修复之后一组测试要跑几分钟,通过 API 接入异步工具,应用可以在后台执行测试,同时让模型继续处理独立工作——比如先整理已经发生的代码改动、说明问题原因,等测试结果回来再补上验证结论。

这里的要点是分清依赖关系:整理改动不一定需要测试结果,但宣布修复成功就必须等结果。异步工具同样需要应用层来执行任务、管理后台工作并把结果送回模型。只有开发者把这一层接好,模型才能真正利用等待时间,而不是干等。
异步工具调用(Async Tool Use)是 AI Agent 架构中提升吞吐效率的重要模式。在同步模式下,模型每调用一次外部工具(如运行测试、查询数据库)都需要等待结果返回才能继续;而在异步模式下,应用层可以将耗时操作提交到后台执行,同时允许模型继续处理与该操作无依赖关系的其他子任务。这要求开发者在应用层实现任务队列、状态管理和回调机制,通常借助消息队列(如 Redis、Celery)或 Webhook 来协调。从架构角度看,模型本身并不"感知"异步,它只是在某个时间点收到了工具执行结果;真正的并发调度逻辑全部在 Orchestration 层完成。对于修复按钮这类需要运行测试套件的场景,合理的异步设计可以将整体任务完成时间从"串行等待之和"压缩到接近"最长单步耗时",在大规模 Agent 应用中对成本和用户体验的影响尤为显著。
怎么判断这套流程是否有效
方法并不复杂:挑一批有代表性的真实任务,记录三件事——成功完成了多少、花了多长时间、每次成功完成的成本是多少。
回到那个按钮,交付时应该能看到修复后的行为和检查依据,哪些情况验证过、哪些还没覆盖也要讲清楚。有了这些信息,你才能判断这次结果能不能接受。
指南给出的一个实用习惯是:下次交任务之前,先写下三句话——
- 我要得到什么结果
- 你可以自行做哪些操作
- 我要看到哪些证据才算完成
有了这三句话,再去调整模型、推理强度和工具流程,每一次调整就都有了可以检验的目标。这或许是整份指南最朴素也最重要的方法论:先把目标和验收标准定义清楚,再谈优化。
相关推荐
2026诺贝尔化学奖解读:手性放大背后的化学革命
2026年诺贝尔化学奖授予亨利·卡根与左右田健次,表彰其在不对称有机合成中发现非线性效应与自催化。本文解读手性分子、不对称催化及63万倍手性放大实验的科学意义。
诺贝尔化学奖得主硖合宪三:手性之谜与生命起源
诺贝尔化学奖得主硖合宪三接受电话采访,谈及其发现的硖合反应如何满足Frank判据、揭示分子手性起源,为地球生命起源这一世纪难题提供关键实验证据。
2026诺贝尔化学奖:破解分子手性之谜
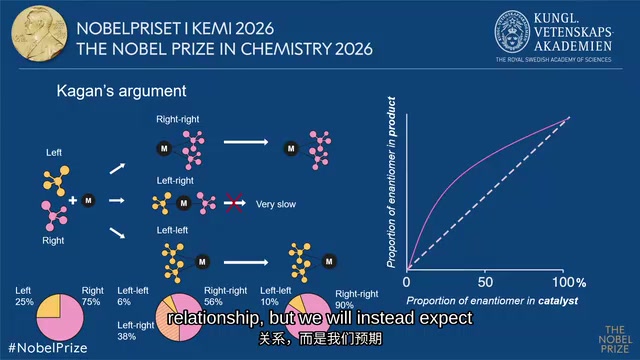
2026年诺贝尔化学奖授予亨利·卡根与硕井健三,表彰其在不对称有机合成中发现非线性效应与自催化反应。本文解读手性、放大效应及其对制药与生命起源研究的意义。