GPT Image 2深度解析:中文渲染、细节表现与使用指南
GPT Image 2在中文渲染和图像细节方面实现重大突破,成为AI图像生成新标杆。
OpenAI发布的GPT Image 2在AI图像生成领域取得显著突破,尤其在中文文字渲染方面实现精准无误,解决了长期困扰AI模型的中文乱码问题。同时在光影、材质、人物表情等细节表现上全面提升。文章还分析了当前GPT、Claude、Gemini等模型的竞争格局,并提醒用户注意辨别官网原版与套壳产品的区别。
GPT Image 2:AI图像生成的新标杆
近期,OpenAI的GPT Image 2(也称Image 2.0)成为AI领域最受关注的话题之一。这款全新的图像生成模型在中文渲染、细节表现等方面展现出令人惊叹的能力,被不少用户称为"直接封神"的存在。同时,GPT-4.5在编程、复杂任务、前端绘图等多个维度也展现出全面领先的综合实力。
本文将围绕GPT Image 2的核心能力进行解析,并探讨当前AI模型竞争格局的最新变化。
GPT Image 2的核心优势
中文渲染精准无误
长期以来,AI图像生成模型在处理中文文字时表现不佳,经常出现错字、乱码、笔画缺失等问题。这一直是Midjourney、DALL·E等模型的痛点。
这一难题的根源在于中文字符的结构复杂性。中文汉字由笔画组成,常用汉字超过6000个,每个字的笔画数从1到30+不等,且笔画间的空间关系极为精密。相比之下,英文仅有26个字母,结构相对简单。早期的扩散模型(Diffusion Model)在生成文字时,本质上是在像素空间中"画"出文字形状,而非真正理解字符结构,这导致模型容易出现笔画缺失、偏旁错位等问题。GPT Image 2很可能在训练数据中大幅增加了高质量中文文字-图像对,并在模型架构层面引入了更强的字符结构理解能力。
GPT Image 2在这一方面实现了质的飞跃——中文渲染精准无错,用户可以直接生成包含中文标题、标语、说明文字的图像,无需后期手动修正。
这一能力对于国内设计师、内容创作者来说意义重大。无论是制作社交媒体配图、产品海报还是PPT插图,准确的中文文字渲染都是刚需。
细节表现全面提升
除了文字渲染能力的突破,GPT Image 2在图像细节方面也有显著提升。这些进步背后是图像生成技术的持续演进——当前主流的AI图像生成技术基于扩散模型(Diffusion Model),其核心原理是先向图像逐步添加噪声直至变为纯噪声,然后训练神经网络学习逆向去噪过程,从而能够从随机噪声中生成高质量图像。2020年DDPM(Denoising Diffusion Probabilistic Models)奠定了理论基础,随后Stable Diffusion、DALL·E 2/3、Midjourney等产品将这一技术推向商业化。GPT Image 2的突破可能涉及更先进的架构设计,如结合Transformer的DiT(Diffusion Transformer)架构,以及更大规模的训练数据和计算资源投入。
具体提升体现在以下方面:
- 光影效果:更加自然真实的光照和阴影处理
- 材质质感:金属、布料、玻璃等材质的还原度更高
- 人物表情:面部细节更加生动,避免了"恐怖谷"效应
- 场景构图:整体画面布局更具专业设计感
值得一提的是,"恐怖谷效应"(Uncanny Valley)是日本机器人学家森政弘在1970年提出的理论,指当人造物与真人的相似度达到一定程度但又未完全逼真时,人类观察者会产生强烈的不适感。在AI图像生成领域,这常表现为眼神空洞、皮肤质感异常、面部对称性过高、微表情不自然等问题。GPT Image 2在克服这一效应方面取得了明显进步,生成的人物面部更加自然生动。
这使得GPT Image 2不仅适用于简单的插图生成,也能胜任更专业的视觉设计场景。
当前顶级AI模型的竞争格局
多模型混战时代
当前AI领域正处于激烈的竞争期。2024-2025年的AI大模型竞争已进入"多模态全能"阶段。所谓多模态(Multimodal),指模型能同时处理文本、图像、音频、视频等多种信息形式。Claude、Gemini等模型各有所长,但从综合能力来看,GPT系列仍然保持着"最强通用大模型"的地位。在编程能力、复杂任务处理、前端绘图等维度,GPT的综合表现依然处于领先位置。
不过这种领先并非绝对。在特定垂直领域,不同模型各有优势:
| 模型 | 优势领域 | 技术特点 |
|---|---|---|
| GPT | 综合能力、图像生成、编程 | 原生多模态,GPT-4o/4.5架构领先 |
| Claude | 长文本理解、代码审查 | 超长上下文窗口(200K tokens),严格安全对齐 |
| Gemini | 多模态理解、Google生态整合 | 依托搜索引擎和YouTube海量数据源 |
Anthropic的Claude以超长上下文窗口和严格的安全对齐著称,在企业级代码审查和长文档分析场景中表现突出;Google的Gemini系列则依托其搜索引擎和YouTube等海量数据源,在多模态理解方面具有独特优势。此外,Meta的Llama系列作为开源代表,以及国内的通义千问广告、文心一言等也在快速追赶,整个行业呈现百花齐放的态势。
AI模型的选择越来越取决于具体使用场景。
GPT功能生态的完善
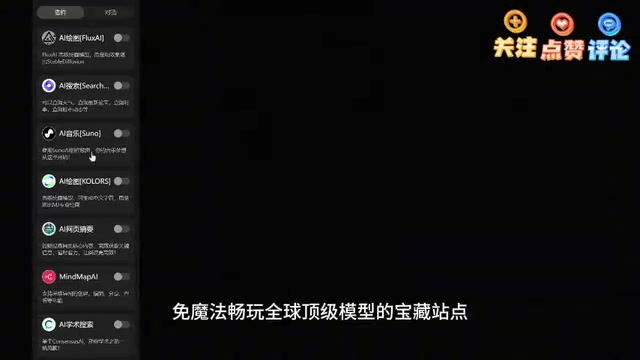
当前GPT官网版本已经集成了多项实用功能:
- 添加文件:支持上传文档、图片等多种格式进行分析
- 深度研究:针对复杂问题进行多轮深入探索
- 网页搜索:实时联网获取最新信息
- Image 2.0生图:最新的图像生成能力
- 标准/进阶模式:标准模式更均衡高效,进阶模式适合深度任务
如何辨别GPT官网原版与套壳产品
在使用GPT相关服务时,版本真实性是一个值得关注的问题。市面上存在大量第三方套壳产品,它们可能使用旧版API或经过功能阉割的模型,体验与官方版本差距明显。
所谓"套壳产品",是指第三方开发者通过调用OpenAI等公司提供的API接口,在其上层包装自己的界面和品牌进行转售的服务。这类产品存在几个核心问题:首先,API版本可能滞后于官网最新版本,用户无法体验最新功能;其次,部分套壳服务为降低成本会使用较低配置的模型(如用GPT-3.5冒充GPT-4);第三,用户输入的数据会经过第三方服务器,存在数据泄露和隐私安全风险;最后,这类服务的稳定性和可用性无法保证,可能随时因API额度耗尽或政策变化而中断。
判断是否为官网原版的关键指标
- 界面一致性:与OpenAI官网界面功能完全一致
- 功能完整性:支持深度研究、网页搜索、Image 2.0等最新功能
- 模式选择:提供标准和进阶两种模式切换
- 响应质量:输出质量与官网体验无差异
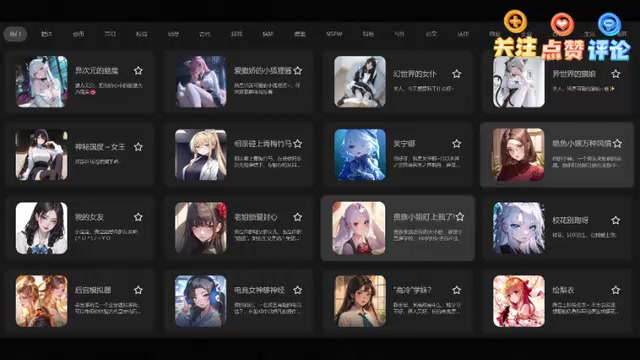
凡是界面功能与官网不一致的,很可能是功能不完整的版本,用户在使用时需要注意甄别,避免为阉割版本付费。
总结与建议
GPT Image 2的发布标志着AI图像生成进入了一个新阶段,尤其是在中文场景下的表现令人印象深刻。对于内容创作者和设计师来说,这意味着AI辅助设计的实用性又上了一个台阶。
使用建议:
- 优先通过官方渠道体验GPT Image 2的完整能力
- 根据实际需求选择最合适的AI工具,不必盲目追捧单一模型
- 注意数据安全和隐私保护,避免在不可信平台上传敏感素材
- 保持关注AI模型的迭代动态,及时了解新功能更新
AI模型的迭代速度极快,保持开放心态、灵活选择工具,才是应对这个快速变化时代的最佳策略。
相关推荐
 产品体验
程序员桌面布局指南:打造让你「回到家」的高效工作空间
探索程序员如何打造高效舒适的桌面布局。从多显示器配置到人体工学设计,解析技术工作者的桌面哲学,帮助你构建提升专注力与生产力的个人工作空间。
 产品体验
Qoder vs Cursor实测对比:同样20美金谁更强?
实测对比Qoder和Cursor两款AI IDE,从Agent自主修复能力、人工沟通次数、架构决策等维度评测。Qoder仅需2次沟通完成任务,Cursor需8次。详细分析两者差异,帮你选择最适合的AI编程工具。
 产品体验
Cursor云Agent演示:打通软件开发全链路瓶颈
深度解析Cursor云Agent最新Demo,展示如何通过云端虚拟机、自动测试产物和全链路控制平面,系统性消除软件开发生命周期中的人类瓶颈,让Agent自主运行、人按需介入。